Skip to content
This page has been auto-translated and may contain errors.View in English

Como os LLMs funcionam ​

docs.scrimba.com

Primeiro, o nome. LLM é a sigla para large language model (modelo de linguagem de grande escala): o tipo de IA por trás de ferramentas como o ChatGPT, aquela coisa para a qual você envia um prompt e recebe um texto de volta. Este capítulo é o retrato prático do que ele realmente é.

Você digita uma pergunta e, poucos segundos depois, aparece uma resposta fluente e confiante. Parece que o modelo te entendeu e foi buscar a resposta. Essa impressão é útil, mas também está errada de formas que importam, e é exatamente nesse espaço entre as duas coisas que nascem a maioria dos erros de quem está começando.

Este é o capítulo que compensa pelo resto da sua carreira com essas ferramentas. Você não precisa saber a matemática por trás do treinamento de um modelo para construir com ele. Mas precisa de um retrato funcional do que realmente acontece quando ele responde, porque esse retrato explica tudo o mais: por que o prompting funciona, por que a mesma pergunta gera respostas diferentes, por que os modelos inventam fatos, por que custam o que custam e por que algumas funcionalidades que parecem triviais são, na verdade, difíceis. Tudo que vem depois neste manual é consequência das ideias apresentadas aqui.

Este capítulo é o modelo mental por trás desses sistemas: o que é um modelo, o único ciclo que ele executa e o punhado de propriedades que explicam o restante do manual. Nada disso é matemática. Tudo isso é a diferença entre programar contra uma caixa-preta e saber por que ela se comporta da forma que se comporta.

Toda técnica dos capítulos seguintes, prompting, saída estruturada, retrieval, agentes, é consequência do que você está prestes a ler. Se você entender bem esse retrato, o resto deixa de parecer uma coleção de truques e passa a parecer uma única máquina que você consegue prever.

Esses modelos falham de formas específicas e repetíveis, e este capítulo explica por quê. Tire a interface do caminho e um modelo de linguagem é uma função congelada que prevê texto um pedaço por vez, e quase todo modo de falha em produção, não-determinismo, explosões de custo, perda de contexto, respostas erradas ditas com confiança, decorre desse único fato.

Não há matemática nova aqui, e esse é o ponto: a vantagem de engenharia que perdura está no mecanismo, não no modelo da vez. Leia isso como o substrato sobre o qual toda decisão futura vai se apoiar.

O que um modelo realmente é ​

Tire a interface de chat do caminho e um modelo de linguagem de grande escala é uma coisa só: uma função matemática enorme, um conjunto fixo de bilhões de números chamados parâmetros (você também vai ouvi-los sendo chamados de pesos). Isso é o modelo inteiro. Não é um banco de dados, não é um mecanismo de busca, não é uma pessoa pequena escondida numa caixa. É uma pilha muito grande de números que recebe texto e produz texto.

Esses números não vieram de um programador que os digitou. Eles foram definidos durante o treinamento. A empresa por trás do modelo alimentou-o com uma quantidade impressionante de texto, livros, código, artigos, páginas da web, e repetiu um exercício simples bilhões de vezes: esconder a próxima palavra, pedir ao modelo que a preveja e ajustar levemente seus números sempre que ele errasse o palpite. Repita isso numa escala enorme e os números vão se acomodando devagar em valores que são bons em prever texto. É isso que é o treinamento: ajustar bilhões de mostradores até que a previsão fique boa.

Duas coisas decorrem disso, e elas explicam boa parte do comportamento que você vai encontrar mais adiante. Primeiro, o treinamento acontece uma vez, com antecedência, e é extremamente caro. No momento em que você chama o modelo, os números já estão congelados. O modelo não aprende com a sua conversa. Nada que você diga altera seus parâmetros. Parece que ele lembra e se adapta, mas isso é o software em volta dele, não o modelo em si, um ponto que volta com força na seção sobre a janela de contexto.

Segundo, não existe nenhuma tabela de fatos dentro dele. O "conhecimento" existe como padrões incorporados nesses números, da mesma forma que um padeiro que já fez dez mil pães tem a técnica nas mãos sem precisar ler uma receita. O modelo aprendeu a forma de um texto correto e coerente. É por isso que ele pode ser fluente e estar errado na mesma frase: ele está reproduzindo a forma de uma boa resposta, não lendo um fato guardado numa estante.

JunoO que um modelo realmente é Então um modelo é uma pilha enorme de números fixos que transforma texto em texto, e esses números foram ajustados uma vez durante o treinamento e depois congelados. Ele não aprende com você enquanto conversa, e não tem nenhuma tabela organizada de fatos dentro dele, tem padrões. É por isso que ele pode parecer seguro e mesmo assim estar errado, então sempre confira qualquer coisa que realmente importa.

Um modelo é uma função pura: você fornece (pesos, entrada) e ele calcula uma saída, nada mais. Os pesos são os bilhões de números aprendidos e fixados durante o treinamento; a entrada é o texto que você envia. Por ser uma função, a mesma entrada sob as mesmas configurações produz sempre as mesmas pontuações internas. Qualquer variação que você veja entre execuções vem da etapa de amostragem que escolhe as palavras a partir dessas pontuações, não do modelo mudando de ideia.

O conhecimento que essa função carrega é armazenado com perdas, espalhado e comprimido por todos os pesos de uma só vez, e não arquivado como registros que se possa recuperar. Não existe uma linha que você possa ler, nem uma célula que você possa editar. Um fato que o modelo "sabe" é, na realidade, um padrão forte que os pesos reconstroem sob demanda, às vezes reconstruindo de forma levemente errada. Você não consegue apontar onde um fato mora, e não consegue corrigir um único fato sem retreinar o modelo.

A postura prática é tratar o modelo como uma função fixa que você chama, não como uma base de conhecimento que você consulta. Use-o para moldar linguagem, raciocinar sobre texto e seguir instruções. Quando você precisar de algo específico, atual ou auditável, coloque essa informação na entrada você mesmo, em vez de confiar que os pesos vão guardá-la. Esse único hábito, fornecer os fatos em vez de esperar que eles estejam lá, evita boa parte das respostas erradas ditas com confiança.

JunoO que um modelo realmente é Pense no modelo como uma função pura de pesos e entrada: mesma entrada, mesmas configurações, mesmas pontuações internas, com a variação entre execuções vindo da amostragem. O conhecimento dele é comprimido com perdas por todos os pesos, então você não consegue consultar ou editar um único fato ali dentro. Construa levando isso em conta: trate-o como uma função fixa que você chama, e alimente fatos específicos ou atuais pela entrada em vez de esperar que os pesos os lembrem.

Um modelo em produção é um conjunto de pesos congelados atrás de uma API: bilhões de números aprendidos, fixados no momento do treinamento, calculando uma função pura de (pesos, entrada). O único momento em que o comportamento dele realmente muda é quando o fornecedor lança um modelo diferente.

Isso tem uma implicação operacional afiada. Uma atualização silenciosa por trás do mesmo endpoint pode mudar suas saídas sem que uma única linha do seu código tenha mudado, então fixe uma versão específica do modelo, trate essa versão como parte do seu contrato, e rode novamente seus evals antes de adotar uma nova versão. Adotar "a mais recente" por confiança é como um sistema que funciona bem degrada silenciosamente.

Os pesos são memória paramétrica comprimida, e ela é tanto imprecisa quanto não auditável. Você não consegue comparar o que um modelo "sabe" entre versões, não consegue enumerar seus fatos, e não consegue provar que um determinado fato está ali ou está correto. Então nunca aposte a correção de um fato crítico na memória paramétrica. Se uma resposta errada custaria caro, forneça o fato na entrada a partir de uma fonte que você controla e pode citar, e mantenha o modelo no papel de formular e raciocinar sobre essa fonte, não de ser a fonte.

Mudar os pesos deliberadamente é o que o fine-tuning faz, e vale deixar claro o que isso realmente compra. O fine-tuning muda de forma confiável o comportamento e a forma, tom, formato, hábitos de tarefa, mas não te dá um repositório confiável e consultável de fatos. Recorra a ele para moldar como o modelo responde, não para instalar conhecimento em que você precisa confiar. Mantenha os fatos na entrada, mantenha o estilo nos pesos, e você não vai se surpreender com nenhum dos dois.

JunoO que um modelo realmente é Os pesos estão congelados, então o comportamento só muda quando o fornecedor lança um modelo diferente: fixe a versão, torne isso parte do seu contrato, e rode novamente os evals antes de atualizar, ou uma troca silenciosa vai te fazer regredir enquanto você dorme. A memória paramétrica é imprecisa e não auditável; você não consegue comparar o que ela sabe, então mantenha fatos críticos na entrada, vindos de uma fonte que você controla, não na memória. E o fine-tuning muda comportamento e forma, não é um repositório confiável de fatos, então use-o para como o modelo responde, não para o que ele deveria saber.

Prevendo o próximo token ​

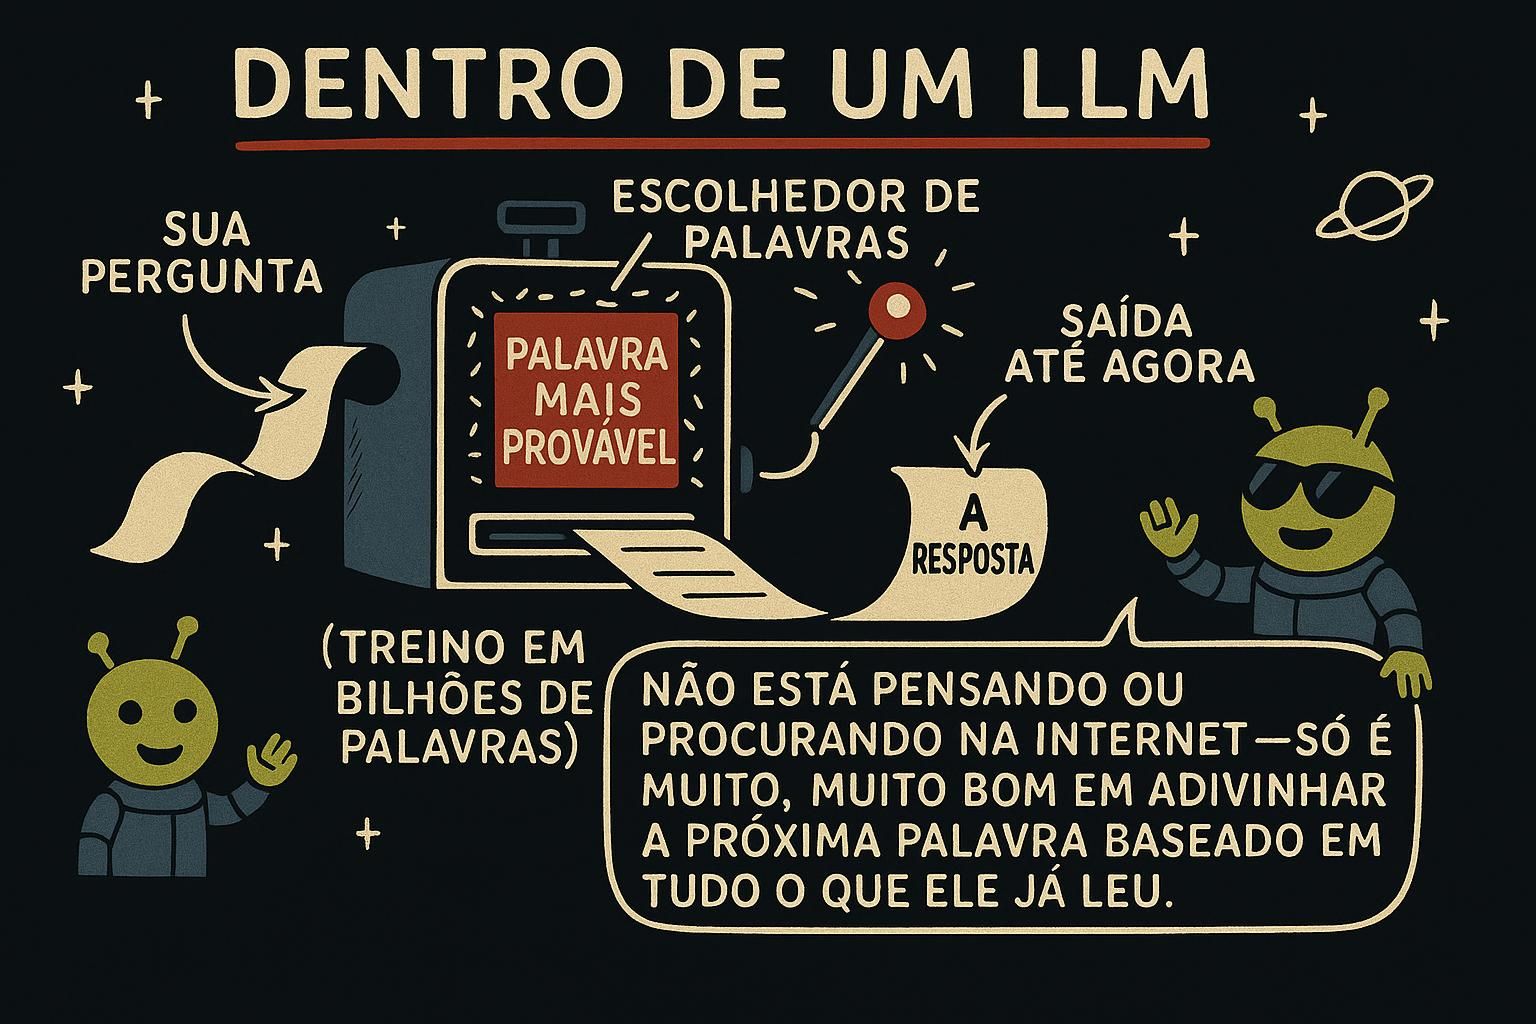
Com essa pilha de números em posição, o modelo faz exatamente uma tarefa: prever o próximo pedaço de texto, repetidamente.

Veja o ciclo em câmera lenta. Você dá a ele algum texto. Ele passa esse texto por todos aqueles parâmetros e produz uma probabilidade para cada pedaço possível de vir a seguir que ele conhece, dezenas de milhares de opções de uma vez. Depois de "A capital da França é", o pedaço "Paris" pode receber uma pontuação de 97%, "a" uma pontuação de 1%, e todo o resto quase nada.

O modelo então escolhe um pedaço, adiciona ao texto e roda tudo de novo para escolher o próximo. Ele repete isso até a resposta estar terminada.

Esse é o motor inteiro. Uma resposta que você lê como um único pensamento foi construída um pedaço por vez, cada pedaço escolhido a partir de uma classificação nova de probabilidades, sem nenhum plano para onde a frase está indo além de "o que é provável a seguir". Toda capacidade que você vai usar, chat, código, tradução, uso de ferramentas, raciocínio, é esse mesmo ciclo rodando por baixo.

O teclado do celular que sugere sua próxima palavra é a mesma ideia em miniatura. A diferença são os bilhões de parâmetros atrás do palpite. Treinado com texto suficiente, "qual é o pedaço mais provável de vir a seguir" acaba sendo bom o bastante para escrever código funcional e explicações claras. Mas o mecanismo por baixo nunca muda: é previsão, não compreensão, e não é uma resposta armazenada sendo consultada.

JunoPrevendo o próximo token O motor inteiro é um ciclo pequeno: ler o texto até agora, dar uma pontuação para cada pedaço possível de vir a seguir, escolher um, e repetir até a resposta estar concluída. O modelo não tem nenhum plano para a frase além do que é provável a seguir, então uma resposta que você lê como um único pensamento foi na verdade construída um pedaço por vez. Isso é previsão, não compreensão, e não é uma resposta armazenada sendo consultada.

O modelo faz uma única coisa repetidamente: em cada passo, ele lê todo o texto até agora e emite uma pontuação para cada token (um token é um pedaço de texto, muitas vezes parte de uma palavra) do seu vocabulário, dezenas de milhares deles de uma vez. Essas pontuações se tornam uma distribuição de probabilidade, e o modelo amostra um token a partir dela. Depois ele anexa esse token ao texto e roda tudo de novo para escolher o próximo. Depois de "A capital da França é", "Paris" pode concentrar quase toda a probabilidade e tudo o mais quase nenhuma.

Essa realimentação é o motivo do nome autorregressivo: cada novo token depende de todo o texto até agora, incluindo os tokens que ele já escreveu nesta rodada. Não há plano global e não há rascunho para revisar. O modelo se compromete com um token por vez, e, como não pode voltar atrás num token, ele pode se encurralar: uma palavra inicial dita com confiança pode forçar o resto da frase por um caminho estranho que ele então precisa terminar.

Esse único fato explica algumas coisas que você vai usar na prática. Deixar o modelo escrever seu raciocínio antes da resposta final ajuda, porque mais tokens significam mais passos e mais computação gasta no problema antes de ele se comprometer com uma resposta. A estrutura da saída é decidida estritamente da esquerda para a direita, então a forma de uma resposta é definida ao longo do caminho, não planejada de antemão. E o mesmo ciclo é o que impulsiona o uso de ferramentas: o modelo prevê os tokens que formam uma chamada, você a executa, e o resultado é realimentado como mais texto para a próxima previsão.

JunoPrevendo o próximo token Em cada passo o modelo pontua cada token do seu vocabulário, amostra um, realimenta e repete: esse ciclo de realimentação é o que significa autorregressivo. Não há plano e não há como desfazer, então ele se compromete token por token e pode se encurralar. É por isso que escrever o raciocínio antes da resposta ajuda, e por que o uso de ferramentas é o mesmo ciclo com um resultado realimentado.

A geração é sequencial por construção: o modelo produz um token (um pedaço de texto), realimenta-o e prevê o próximo, então cada token de saída é uma passagem separada pela rede. Ler sua entrada é comparativamente barato, processado de uma vez; a parte lenta e cara é o modelo escrevendo. Latência e custo escalam com o comprimento da saída, não da entrada. As palancas práticas decorrem disso: mantenha as saídas curtas, transmita os tokens em streaming para que o usuário veja o progresso em vez de esperar a resposta completa, e não pague por formatação verbosa que você vai descartar.

A outra consequência é a correção. Como não há plano global, uma única passagem não se autocorrige: o modelo se compromete da esquerda para a direita e não pode revisar um token depois que ele saiu. É por isso que qualquer coisa que precisa estar certa quer verificação ou uma segunda passagem sobre o rascunho inicial, e por que um modelo que escreve seu raciocínio antes da resposta tende a se sair melhor, você está comprando mais passos para ele se comprometer. Trate a primeira geração como um rascunho, não como um veredito.

Uma alavanca que vale a pena embutir: muitas configurações expõem probabilidades por token (logprobs, a própria pontuação de confiança do modelo para cada token que ele escolheu). Você pode lê-las para sinalizar trechos de baixa confiança, bloquear uma resposta sobre a qual o modelo estava incerto, ou encaminhar casos incertos para uma segunda passagem ou um humano. É um sinal barato que você já tem, e transforma "o modelo pode estar errado aqui" em algo sobre o qual você pode agir programaticamente em vez de apenas suspeitar.

JunoPrevendo o próximo token Cada token de saída é sua própria passagem pela rede, então custo e latência acompanham o comprimento da saída, não da entrada: mantenha as respostas curtas, transmita-as em streaming e pare de pagar por formatação que você descarta. Não há plano e não há como desfazer, então uma única passagem não se autocorrige; trate a primeira geração como um rascunho e adicione uma passagem de verificação para qualquer coisa que precise estar certa. Se você puder ler logprobs por token, use-os para sinalizar ou encaminhar os trechos em que o modelo tinha menos certeza, é confiança que você já tem e raramente aproveita.

O controle de aleatoriedade ​

Se o modelo sempre pegasse o único pedaço com a pontuação mais alta, ele te daria a mesma resposta para o mesmo prompt sempre, e essa resposta muitas vezes seria monótona e repetitiva. Então, na maior parte do tempo, a escolha tem um pouco de aleatoriedade embutida: geralmente ele escolhe um pedaço de alta probabilidade, mas nem sempre o mais alto de todos. É por isso que você pode fazer exatamente a mesma pergunta duas vezes e receber duas respostas diferentes. Isso é o sistema funcionando como projetado, não uma falha.

Você controla quanta aleatoriedade existe por meio de uma configuração chamada temperatura, que você define ao chamar o modelo, no capítulo sobre chamar modelos a partir do código. Vale a pena ter essa intuição desde já. Numa temperatura baixa, o modelo se mantém próximo das suas escolhas principais: focado, consistente, previsível, o que é o que você quer para extrair um número de uma nota fiscal ou classificar textos em categorias. Numa temperatura mais alta, pedaços de menor probabilidade são escolhidos com mais frequência: mais variado e criativo, e mais propenso a se desviar para algo errado. Brainstorming e escrita criativa querem a extremidade mais alta; qualquer coisa que tenha uma resposta correta quer a extremidade mais baixa.

Então um único controle desliza o modelo entre "cuidadoso e repetível" e "surpreendente e inventivo". É o mesmo ciclo de previsão de qualquer forma; a temperatura só muda quão ousadamente o modelo se afasta do seu palpite mais seguro.

JunoO controle de aleatoriedade Temperatura é o seu controle de aleatoriedade. Diminua-a para tarefas com uma resposta correta, como extração ou classificação, e você recebe respostas focadas e repetíveis. Aumente-a para brainstorming e trabalho criativo, e você recebe mais variedade junto com mais chances de se desviar. O mesmo ciclo de previsão, só que com um alcance mais ousado ou mais seguro.

Antes de o modelo escolher seu próximo pedaço, ele tem uma probabilidade para cada candidato. A temperatura remodela essa distribuição antes de o modelo fazer a amostragem a partir dela. Uma temperatura baixa afia a distribuição em direção ao token único mais provável (mais próximo de sempre pegar a escolha principal), então a saída fica focada e repetível. Uma temperatura alta a achata, dando aos tokens menos prováveis uma chance real, então a saída fica mais variada e mais propensa a se desviar para o errado. É por isso que o mesmo prompt pode retornar respostas diferentes: existe um sorteio acontecendo, e a temperatura define quão inclinadas as chances estão.

A temperatura não é o único controle aqui. Top-p (amostrar apenas do menor conjunto de tokens cujas probabilidades somam p) e top-k (apenas os k tokens mais prováveis) ambos reduzem o conjunto de candidatos antes da amostragem. Eles se sobrepõem em efeito com a temperatura, então ajuda pensar neles como uma única configuração de aleatoriedade, e não três independentes.

A postura prática é definir a temperatura explicitamente por tarefa, em vez de confiar em qualquer valor padrão que venha configurado. Vá baixo para extração, classificação e qualquer coisa que emita saída estruturada que você vai analisar depois; vá mais alto para ideação e rascunhos, onde a variedade é o objetivo. Fique atento a interações: combinar uma temperatura alta com um top-p de 1 deixa toda a cauda da distribuição em jogo, o que joga contra você quando precisa de resultados confiáveis e analisáveis.

JunoO controle de aleatoriedade A temperatura remodela a distribuição de probabilidade antes da amostragem: baixa a afia em direção ao token principal para uma saída focada, alta a achata para variedade. Trate temperature, top_p e top_k como uma única configuração de aleatoriedade, não três. Defina-a por tarefa: baixa para extração, classificação e saída estruturada; mais alta para ideação. Não combine uma temperatura alta com top_p de 1 quando precisar de resultados analisáveis.

A temperatura escala a distribuição de pontuações antes da amostragem, e o atalho tentador é defini-la em 0 e chamar a saída de determinística. É quase isso, mas não é uma garantia. Matemática de ponto flutuante, agrupamento em lote no lado do servidor e roteamento interno em modelos grandes todos introduzem um não-determinismo pequeno mesmo em 0. Então não construa cache por correspondência exata nem testes de correspondência exata que assumam saída idêntica byte a byte para um prompt repetido; essa suposição falha de forma intermitente, e falhas intermitentes são o tipo caro de perseguir.

Isso molda como você testa comportamento amostrado. Uma única execução diz quase nada sobre um sistema estocástico (um cuja saída varia de execução para execução), então avalie um prompt executando-o várias vezes e olhando para a distribuição das saídas: com que frequência ele fica dentro da especificação, quão ampla é a variância, onde a cauda dá errado. É esse o trabalho que seus evals fazem, e eles precisam de amostras suficientes para ver a dispersão, não de uma única passagem de sorte.

Trate temperatura, top-p (amostrar apenas do menor conjunto de tokens cujas probabilidades atingem uma probabilidade cumulativa p) e top-k (manter apenas os k tokens mais prováveis) como um único orçamento de amostragem que você ajusta em conjunto, em vez de três controles que você define por reflexo. Escolha a menor aleatoriedade que ainda dá variedade aceitável para a tarefa: apertar os três de uma vez pode fazer a saída entrar em colapso, ficando repetitiva e frágil, enquanto deixar todos abertos entrega uma variância que depois você precisa validar. O custo é real dos dois lados, então gaste-o deliberadamente.

JunoO controle de aleatoriedade Temperatura 0 é quase determinística, não garantida: ponto flutuante, agrupamento em lote e roteamento interno vazam não-determinismo, então evite cache por correspondência exata e testes de correspondência exata. Avalie o comportamento amostrado ao longo de várias execuções e leia a distribuição, não uma única passagem; é para isso que seus evals servem. Ajuste temperature, top_p e top_k como um único orçamento de amostragem, e escolha a menor aleatoriedade que ainda dá variedade aceitável.

Tokens ​

Os "pedaços" que um modelo prevê têm um nome: tokens. Um token é um pedaço de texto, muitas vezes uma palavra inteira, às vezes só parte de uma. Palavras comuns geralmente são um único token, enquanto palavras mais longas ou raras são divididas em vários.

"tokenization"  ->  "token" + "ization"
"unbelievable"  ->  "un" + "believ" + "able"
"cat"           ->  "cat"

Por que picar o texto nesses pedaços estranhos em vez de usar palavras inteiras ou letras individuais? É uma questão de equilíbrio. Letras individuais tornariam cada sequência enormemente longa, e o comprimento é o que o modelo precisa processar. Palavras inteiras precisariam de um vocabulário de milhões de entradas e ainda assim quebrariam na primeira vez que alguém inventasse uma palavra ou cometesse um erro de digitação. Os tokens são o caminho do meio: um vocabulário fixo de algumas dezenas de milhares de pedaços comuns que podem ser encaixados para formar qualquer coisa, incluindo palavras que o modelo nunca viu.

Aqui está a consequência escondida por baixo dos panos que surpreende as pessoas. O modelo nunca vê letras. Ele vê tokens, que para ele são na verdade números de identificação para esses pedaços. Então tarefas que parecem fáceis para nós podem ser difíceis para ele: contar as letras de uma palavra, inverter uma string, notar que "strawberry" tem três r's.

Ele não está sendo lerdo. Ele simplesmente não percebe os caracteres individuais, da mesma forma que você não consegue distinguir os grãos separados de farinha num pão já assado. Quando um modelo erra numa tarefa de ortografia ou contagem de caracteres, é por isso, e a solução geralmente é fazer essa parte com código normal em vez de com o modelo.

Tokens também são a unidade de duas coisas com as quais você vai se preocupar constantemente:

  • Dinheiro: os fornecedores cobram por token, tanto os tokens que você envia quanto os tokens que o modelo escreve de volta, então um documento longo na entrada e uma resposta longa na saída custam mais. Uma estimativa aproximada para o inglês é cerca de quatro caracteres por token, ou 100 tokens para cada 75 palavras; código e outras línguas frequentemente se dividem em mais tokens, o que é parte do motivo de custarem mais. Você vai encontrar isso diretamente quando começar a chamar modelos a partir do código.
  • Limites: existe um teto para quantos tokens o modelo consegue processar de uma vez, que é a próxima seção.
JunoTokens Um token é um pedaço de texto, geralmente uma palavra ou parte de uma, e o modelo lê esses pedaços como números de identificação, não como letras. É por isso que ele pode tropeçar em contagem ou ortografia, então passe esse trabalho para código simples. E como você paga por token nos dois sentidos e existe um teto para quantos cabem de uma vez, menos tokens significa menos custo e mais espaço.

O modelo prevê tokens, pedaços de texto que muitas vezes são uma palavra inteira e às vezes um fragmento. A peça que faz essa divisão é o tokenizador, e ele opera a partir de um vocabulário aprendido, construído mesclando repetidamente os pares de caracteres mais comuns até você ter um conjunto fixo de algumas dezenas de milhares de pedaços (um esquema geralmente chamado de codificação por par de bytes, ou BPE). Esse histórico é o motivo de palavras frequentes acabarem como um único token enquanto palavras raras se fragmentam em partes: os padrões comuns foram mesclados durante o treinamento, os incomuns nunca foram.

Dois fatos práticos decorrem disso. Primeiro, o modelo nunca lida com caracteres, apenas com IDs de tokens, então qualquer operação no nível de caractere (contar letras, inverter uma string, cortar numa posição exata) é instável dentro de um prompt e confiável no seu próprio código. Empurre esse trabalho para o código e deixe o modelo fazer a parte da linguagem. Segundo, a tokenização é específica de cada modelo, então as contagens de tokens não são portáveis. A mesma frase pode custar um número diferente de tokens em outro tokenizador, o que importa no momento em que você orçar custo ou encaixar conteúdo dentro de uma janela.

A lição para quem constrói: não estime contagens de tokens de olho, a partir do comprimento em caracteres. Conte com o tokenizador real que o modelo usa, porque esse é o número pelo qual você é cobrado e limitado. Você encontra tudo isso de forma concreta quando começar a chamar modelos a partir do código, onde a contagem que você envia mais a contagem que você recebe de volta é a sua conta.

JunoTokens Um tokenizador divide o texto usando um vocabulário aprendido (BPE), o que é o motivo de palavras comuns serem um token e palavras raras se fragmentarem. A tokenização é específica de cada modelo, então conte com o próprio tokenizador do modelo em vez de estimar a partir de caracteres. E mantenha o trabalho no nível de caractere (contar, inverter, cortar com precisão) no seu código, não no prompt.

Tokens são o medidor de tudo o que você entrega. Um token é um pedaço de texto do vocabulário aprendido do tokenizador, e a conta por token mais o teto fixo de contexto são os dois números que moldam seu custo e seu design. A regra de bolso reconfortante de quatro caracteres por token vale para prosa em inglês simples e desmorona exatamente onde a produção vive: código, JSON, formatação profundamente aninhada e escritas não latinas todos se fragmentam em muito mais tokens do que a heurística prevê. Então orçe com o tokenizador real, não com o medidor, ou suas estimativas de custo e capacidade estarão erradas justamente nas cargas que você realmente envia.

Essa fragmentação não é distribuída uniformemente, e isso é um problema de justiça e de custo em escala. O mesmo significado num idioma não latino pode custar várias vezes os tokens da versão em inglês, então a mesma funcionalidade fica silenciosamente mais cara, e mais lenta, para alguns dos seus usuários do que para outros. Vale a pena medir por idioma antes de prometer a alguém um preço fixo ou uma latência fixa.

Mais dois hábitos de campo. Formato é gasto: espaços em branco, delimitadores verbosos e markdown decorativo todos custam tokens sem nenhum significado adicional, então mantenha a estrutura que você alimenta ao modelo compacta e deixe seu código adicionar a apresentação depois. E alimente texto limpo e normal, porque tokens raros ou malformados (mojibake, caracteres de controle perdidos, codificações estranhas) ficam nos cantos finos e mal treinados do vocabulário e podem desencadear saídas estranhas. Nada disso é exótico; é a diferença entre um orçamento de tokens em que você confia e um que te surpreende na fatura.

JunoTokens A regra dos quatro caracteres por token quebra em código, JSON e escritas não latinas, que é exatamente onde vive o seu tráfego real, então orçe com o tokenizador real. Idiomas não latinos podem custar várias vezes mais tokens para o mesmo significado, uma diferença real de custo e justiça que vale a pena medir por idioma. Tire a formatação decorativa para economizar tokens, e alimente texto limpo para que tokens raros ou malformados não te comprem comportamento estranho.

A janela de contexto ​

A janela de contexto é quanto texto o modelo consegue receber de uma vez, medido em tokens. Imagine como o tamanho da mesa de trabalho do modelo. Tudo que está envolvido numa única requisição precisa caber nessa mesa de uma vez: suas instruções, a conversa até agora, quaisquer documentos que você colou, e a resposta que o modelo está escrevendo.

Por que existe um limite? Ele vem de como a previsão funciona. Para escolher o próximo token, o modelo pesa como cada token da entrada se relaciona com todos os outros tokens, para conseguir identificar que "ele" se refere ao gato mencionado três frases atrás. Essa comparação de todos com todos é o que permite ao modelo acompanhar o significado ao longo de um trecho, e é também o que torna entradas longas caras de processar. O fornecedor define um teto, a janela de contexto, para manter cada requisição administrável.

Quando a mesa está cheia, alguma coisa precisa saltar fora. Se uma conversa se estender o suficiente para transbordar a janela, as partes mais antigas caem e o modelo não consegue mais vê-las. É por isso que uma conversa longa parece "esquecer" o que você disse no começo. Ele não esqueceu em nenhum sentido humano; aqueles tokens saíram da mesa. Também ajuda saber que os modelos tendem a prestar mais atenção ao início e ao fim do que está na mesa e podem perder o rastro de coisas enterradas no meio, então onde você coloca o texto importante importa quando você preenche a janela.

Agora o ponto que pega quase todo iniciante, e importa mais do que todo o resto. O modelo não tem memória entre requisições separadas. Lembre-se de que os números dele estão congelados. Cada chamada começa com uma mesa vazia. O modelo não lembra da sua última pergunta, do seu nome, ou de nada de um minuto atrás.

Um aplicativo de chat parece uma única conversa contínua só porque o aplicativo reenvia silenciosamente todo o histórico com cada nova mensagem. A continuidade é algo que o software em volta do modelo constrói, não algo que o modelo tem.

Esse único fato molda como você constrói tudo a partir daqui. Se você quer que o modelo saiba algo, precisa colocar isso na mesa naquela requisição: a conversa até agora, os dados do usuário, os documentos relevantes, tudo, sempre. Boa parte deste manual é, na verdade, sobre fazer bem essa única coisa: colocar o texto certo na mesa.

JunoA janela de contexto A janela de contexto é a mesa de trabalho do modelo: cada requisição precisa caber nela, e quando ela transborda, o texto mais antigo cai fora. O modelo não guarda nenhuma memória entre chamadas, então o aplicativo reenvia todo o histórico a cada vez para simular um chat contínuo. Seu trabalho a partir daqui é colocar o texto certo nessa mesa em cada requisição.

Pense na janela de contexto como um orçamento fixo de tokens que uma requisição pode gastar, cobrindo suas instruções, a conversa em andamento, quaisquer documentos colados e a resposta sendo gerada. A janela existe por causa de como o modelo lê a entrada: um mecanismo chamado atenção compara cada token com todos os outros tokens para descobrir o que se relaciona com o quê. Essa comparação é o que permite ao modelo resolver um "ele" de volta ao substantivo que ele indica, e seu custo cresce aproximadamente com o quadrado do comprimento da entrada. Dobre os tokens e você mais que dobra o trabalho, que é a razão real pela qual entradas longas são lentas e elevam o custo.

Caber dentro da janela não é o mesmo que o modelo usar tudo o que está nela. Existe um efeito bem documentado chamado perdido no meio: os modelos prestam atenção mais confiável ao início e ao fim da entrada e podem passar por cima de material estacionado no centro. Então coloque suas instruções e dados mais importantes perto do início ou do fim do prompt, não enterrados numa parede de texto colado.

A outra metade disso é a memória, e o fato-chave é que o modelo é stateless (sem estado): ele não lembra de nada entre requisições separadas. Cada chamada começa com uma janela vazia, então a única forma de o modelo saber a conversa até agora é você enviá-la novamente a cada vez. Reenviar e moldar esse histórico é o seu trabalho, não o do modelo. Conforme o chat cresce além da janela, gerencie isso você mesmo, cortando turnos antigos ou substituindo-os por um resumo curto, para que os tokens que você mantém sejam os que ainda importam.

Isso coloca a construção de contexto no centro de construir com esses modelos. Decidir o que entra na janela, em que ordem, e como comprimir o que veio antes é a maior parte do trabalho, e prompting é onde você aprende a moldar isso deliberadamente.

JunoA janela de contexto A janela é um orçamento de tokens que cobre instruções, histórico, documentos e a resposta; a atenção faz com que entradas longas custem aproximadamente o quadrado do seu comprimento. Os modelos sofrem do efeito perdido no meio, então coloque o que importa perto do início ou do fim. O modelo não tem estado, então reenviar e cortar o histórico da conversa é responsabilidade sua, a cada chamada.

Trate a janela de contexto como um teto, não como uma meta. É o orçamento de tokens que uma única requisição recebe, abrangendo suas instruções, o histórico em andamento, documentos recuperados e a saída.

Cada token que você coloca nela custa dinheiro e latência, porque a etapa de atenção (a comparação de todos os tokens com todos que o modelo executa para ler a entrada) escala aproximadamente com o quadrado do comprimento. Pior, a capacidade efetiva de recuperação se degrada bem antes de você atingir o limite: o efeito perdido no meio significa que a precisão sobre material enterrado no centro cai mesmo quando ele tecnicamente cabe. Então cure o contexto em vez de despejar tudo dentro, e quando os dados de origem forem grandes, recupere apenas as partes relevantes com RAG em vez de colar o corpus inteiro.

Ordem é uma alavanca, não um detalhe. Fornecedores podem reutilizar a computação de um prefixo inalterado através do cache de prompt, onde o estado interno em cache é o cache KV, o trabalho armazenado do modelo para tokens que ele já leu. Coloque conteúdo estável primeiro (instruções do sistema, material de referência fixo) e conteúdo variável por último, e chamadas repetidas ficam mais baratas e mais rápidas porque o início do prompt é servido a partir do cache. Reordene esse prefixo sem cuidado e você invalida o cache e paga o preço total de novo.

Memória entre turnos não é uma funcionalidade que o modelo tem; é uma escolha de engenharia que você faz, e cada opção falha do seu próprio jeito:

  • Janelamento simples, mantendo os turnos mais recentes, é barato mas descarta silenciosamente fatos antigos que o usuário ainda espera que você saiba.
  • Sumarização mantém mais histórico em menos tokens mas perde detalhe e pode silenciosamente codificar seus próprios erros.
  • Retrieval traz de volta só o que é relevante mas depende inteiramente do seu índice retornar as partes certas.

Escolha por caso de uso, e assuma que qualquer opção que você escolher eventualmente vai trazer à superfície a coisa errada; instrumente para isso em vez de confiar nela.

JunoA janela de contexto A janela é um teto, não uma meta: custo e latência sobem com cada token, e a capacidade de recuperação se deteriora antes de você atingir o limite, então cure o contexto e use retrieval para qualquer coisa grande. Conteúdo estável primeiro, variável por último, para que o cache de prompt (o cache KV) realmente compense. A memória entre turnos é sua escolha de design entre janelamento, sumarização e retrieval, e eu já fui pego pelas três, então instrumente a que você escolher.

O que o modelo não sabe ​

Todo o conhecimento de um modelo foi incorporado durante o treinamento, então ele só sabe o que estava nos dados de treinamento, e esses dados foram reunidos até algum ponto de corte no passado. Dois limites decorrem diretamente disso.

Primeiro, ele não sabe nada que tenha acontecido depois do seu corte. Pergunte sobre as notícias da semana passada ou uma biblioteca que saiu este mês e ele não tem ideia real, embora possa produzir alegremente uma resposta que parece plausível de qualquer forma. Segundo, ele nunca soube nada privado. Os documentos internos da sua empresa, o histórico de pedidos de um usuário, o conteúdo do seu banco de dados: nada disso estava no texto público em que ele treinou, então ele não pode saber disso, não importa quão bem você peça.

Existe um limite mais discreto também. O modelo geralmente não consegue te dizer de onde veio algo que ele "sabe", porque o conhecimento está misturado dentro dele em vez de arquivado como fatos separados e com fonte identificada. Ele pode escrever uma citação para você, mas está prevendo como uma citação deveria parecer, não buscando uma real.

Essa é a razão para uma técnica que você vai encontrar mais adiante chamada retrieval, ou RAG. Se você quer que um modelo responda sobre eventos recentes ou seus próprios dados privados, você não o retreina. Você mesmo busca o texto relevante e o coloca na mesa no momento da requisição, para que o modelo tenha os fatos diante de si em vez de chutar. Um modelo é muito mais um raciocinador sobre o texto que você fornece do que um poço confiável de fatos específicos.

JunoO que o modelo não sabe Um modelo só sabe o que estava nos seus dados de treinamento, até um corte no passado, então ele perde eventos recentes e qualquer coisa privada, e não consegue dizer de forma confiável de onde vieram os seus fatos. Quando você precisa de informação atual ou privada, não retreine: busque o texto relevante e entregue-o ao modelo na requisição. Trate o modelo como algo que raciocina sobre o que você fornece, não como uma memória confiável.

O conhecimento embutido de um modelo, seu conhecimento paramétrico (os fatos codificados nos seus pesos, os números ajustáveis definidos durante o treinamento), está congelado no corte de treinamento. Nada que aconteceu depois dessa data está ali, e nada privado jamais esteve, porque os pesos foram moldados por texto público. Então a memória te dá duas lacunas previsíveis: recência, qualquer coisa depois do corte, e privacidade, qualquer coisa que nunca esteve nos dados de treinamento públicos.

Essas duas lacunas são na verdade uma única lacuna vista de dois ângulos, e ambas se fecham da mesma forma: colocar o texto necessário na requisição. Você mesmo busca o artigo recente ou a linha relevante do banco de dados e fornece isso junto com a pergunta, para que o modelo leia o fato em vez de recordá-lo. Essa é a ideia central por trás do RAG, geração aumentada por retrieval, que você vai usar sempre que as respostas precisarem refletir informação atual ou proprietária.

O conhecimento paramétrico também não vem com nenhuma fonte anexada. Os fatos estão misturados nos pesos, não armazenados como entradas discretas com procedência, então o modelo não consegue te dizer de forma confiável de onde algo veio. Uma citação que ele produz é gerada para parecer correta, não recuperada de um registro, o que é exatamente o motivo pelo qual fundamentar a resposta em texto que você fornece vale o esforço.

A regra prática para construir: não peça ao modelo para recordar fatos atuais ou proprietários da memória. Se um fato precisa estar certo, busque-o e forneça-o, e deixe o modelo raciocinar sobre ele.

JunoO que o modelo não sabe O conhecimento paramétrico, os fatos codificados nos pesos, está congelado no corte de treinamento e não carrega nenhuma fonte, então o modelo perde informação recente e privada e não consegue citar nada de forma confiável. As duas lacunas se fecham da mesma forma: busque o texto relevante e coloque-o na requisição, que é a ideia por trás do RAG. Como regra, não deixe o modelo recordar fatos atuais ou proprietários da memória; forneça-os e deixe-o raciocinar sobre eles.

A memória paramétrica do modelo, o conhecimento contido nos seus pesos (os números ajustáveis fixados durante o treinamento), não tem versão e não é auditável. Você não consegue comparar versões, apontar onde uma afirmação mora, ou confirmar que ela não se desviou. Então para qualquer coisa que precisa estar correta, atual ou em conformidade, não confie na palavra do modelo: fundamente a resposta numa fonte recuperada e cite essa fonte. Trate o conhecimento embutido como um pressuposto fluente, não como um sistema de registro.

O corte também é mais nebuloso do que uma única data sugere. Os dados de treinamento não são uniformes até essa data: material recente é mais escasso e menos digerido do que material mais antigo e bem coberto, então fatos recentes-mas-pré-corte são conhecidos de forma desigual. Um modelo pode estar confiante e errado sobre algo de um ano antes do seu corte enquanto acerta perfeitamente um fato de uma década atrás, o que é o motivo de "isso é antes do corte?" ser uma garantia mais fraca do que parece, e por que você recupera qualquer coisa que precisa estar certa.

Recorra à ferramenta certa para cada lacuna, porque as duas comuns não são intercambiáveis. Retrieval fornece fatos no momento da requisição e permanece atual conforme suas fontes se atualizam. Fine-tuning, continuar o treinamento com seus próprios exemplos, muda forma e comportamento, tom, formato, como o modelo segue suas convenções, e é uma forma pobre e desatualizada de injetar conhecimento: fatos treinados ficam congelados de novo, difíceis de atualizar, e ainda sem fonte. Use retrieval para o que é verdade, fine-tuning para como isso deveria soar.

JunoO que o modelo não sabe A memória paramétrica não tem versão e não é auditável, então para qualquer coisa que precisa estar correta, atual ou em conformidade, fundamente a resposta numa fonte recuperada e cite essa fonte, não a palavra do modelo. Lembre-se de que o corte é nebuloso: fatos recentes-mas-pré-corte são conhecidos de forma desigual, então recupere qualquer coisa que precisa estar certa. E combine a ferramenta com a lacuna: retrieval fornece fatos, enquanto fine-tuning muda forma e comportamento e é uma forma desatualizada de injetar conhecimento.

Por que os modelos inventam coisas ​

Às vezes um modelo afirma algo falso com total confiança: uma citação que ninguém disse, uma função que não existe, uma referência a um estudo que nunca foi escrito. Isso é chamado de alucinação, e depois das últimas seções isso deveria parecer quase inevitável em vez de misterioso.

O motivo é que o modelo não tem nenhuma noção interna de "verdadeiro" versus "falso". Ele só tem "texto provável" versus "texto improvável". Na maior parte do tempo essas duas coisas se alinham, porque no texto do qual ele aprendeu, afirmações verdadeiras são muito mais comuns do que falsas, então a continuação provável é geralmente a correta.

Mas quando o modelo encontra uma lacuna, algo em que ele nunca foi treinado, ou seus dados privados que ele nunca poderia ter visto, ele não para e sinaliza a lacuna. Ele não consegue saber de forma confiável o que ele não sabe. Ele faz a única coisa que sempre faz: produz a continuação que parece mais provável.

Uma resposta confiante, bem formulada e errada é muitas vezes exatamente o que parece mais provável. O mesmo mecanismo que o torna fluente é o que o torna fluente quando está errado.

Esse é o ponto em que vale a pena parar e pensar: alucinação não é uma falha que você consegue eliminar completamente com prompting. Você pode reduzi-la, e os capítulos seguintes mostram como. Dizer ao modelo que ele tem permissão para dizer "eu não sei" ajuda um pouco. Pedir a ele que responda apenas a partir do texto que você fornece ajuda muito mais, porque agora não há nenhuma lacuna para preencher a partir do treinamento congelado. Mas a tendência vem do que o modelo fundamentalmente é, uma máquina de probabilidade sem nenhum verificador de fatos dentro, então as correções duráveis são estruturais: forneça a ele os fatos com os quais trabalhar em vez de esperar que estivessem no seu treinamento, e verifique respostas que importam em vez de confiar nelas.

Leve uma regra deste capítulo acima de todas as outras: a confiança de um modelo não te diz nada sobre se ele está certo. Fluência e correção são produzidas pelo mesmo processo e se separam o tempo todo. Construa como se qualquer resposta individual pudesse estar errada, porque qualquer resposta individual pode estar.

JunoPor que os modelos inventam coisas Uma alucinação é o modelo preenchendo com confiança uma lacuna com texto que parece certo mas não é, porque ele só sabe "provável" e não "verdadeiro". Você pode reduzir a frequência com que isso acontece, mas não consegue eliminá-la completamente com prompts, então a jogada segura é entregar ao modelo os fatos de que ele precisa e verificar as respostas que importam. E lembre-se do ponto principal: um tom confiante não é prova, então nunca confie na certeza por si só.

Quando um modelo inventa uma citação, uma função ou uma referência e a afirma com total confiança, isso é uma alucinação, e ela decorre diretamente de como o modelo funciona. O modelo não tem nenhum sinal para verdade. Ele pontua continuações por "texto provável" versus "texto improvável", e na maior parte do tempo provável e verdadeiro se sobrepõem porque afirmações verdadeiras dominaram seus dados de treinamento.

A alucinação dispara exatamente onde essa sobreposição se rompe: nas margens do seu conhecimento, em tópicos raros ou de nicho, e nos seus dados privados que ele nunca treinou. Ali o modelo ainda produz sua continuação mais provável, e uma resposta fluente, bem formulada e errada é muitas vezes o que pontua mais alto.

Então você não consegue corrigir isso apenas com palavras, mas pode classificar suas mitigações por quanto elas realmente ajudam. A maior alavanca de longe é o fundamentar: coloque os fatos reais no prompt e diga ao modelo para responder apenas a partir desse texto fornecido, idealmente citando-o. Agora não há nenhuma lacuna para ele preencher a partir do treinamento congelado. Recuperar o texto certo para fornecer é sua própria técnica, abordada em RAG.

Abaixo disso, dê ao modelo uma saída de emergência explícita, permissão para responder "eu não sei" em vez de chutar, o que remove parte da pressão para inventar. E mantenha a temperatura (o controle de aleatoriedade na seleção de tokens) modesta para trabalho factual, já que alta aleatoriedade abre mais a porta para continuações improváveis e fora do alvo.

A consequência prática: restrinja o modelo ao contexto que você fornece, e verifique saídas que importam. Trate a formulação do prompt como um ajuste pequeno em cima dessas medidas estruturais, nunca como a defesa completa. Um modelo que parece certo não te disse nada sobre se está correto, porque fluência e correção vêm do mesmo processo e rotineiramente se separam.

JunoPor que os modelos inventam coisas Alucinação é o modelo emitindo texto fluente e provável sem nenhuma verificação interna de verdade, e piora nas margens do seu conhecimento e em dados que ele nunca viu. Classifique suas correções por impacto: fundamente em texto que você fornece (a maior alavanca), dê a ele espaço para dizer "eu não sei", diga a ele para responder apenas a partir do contexto fornecido e citá-lo, e mantenha a temperature modesta para trabalho factual. Restrinja ao contexto e verifique as saídas que importam; não confie apenas em truques de formulação.

Alucinação é o modelo retornando texto confiante e bem formulado que por acaso é falso, e é uma propriedade da arquitetura, não um bug que você corrige. O modelo classifica continuações por probabilidade sem nenhum sinal de verdade anexado, então nas margens do seu treinamento, tópicos raros, eventos recentes, qualquer coisa privada, ele ainda emite seu palpite mais provável. Você não vai eliminar isso. O trabalho é projetar o sistema de forma que uma resposta errada seja capturada ou contida antes de chegar a qualquer coisa que importa.

Isso significa três medidas estruturais, nenhuma delas sendo formulação de prompt. Valide a forma de cada resposta: faça o modelo retornar dados contra um esquema para que saídas malformadas ou fora de faixa falhem ruidosamente em vez de fluir adiante, o que é o que a saída estruturada te compra. Meça sua taxa real de alucinação com evals, um conjunto de entradas reservado com respostas conhecidas como corretas, pontuado automaticamente, em vez de verificar alguns prompts pontualmente e chamar isso de resolvido. E mantenha um humano no processo onde o custo de estar errado é alto, porque nenhuma guarda automatizada captura tudo.

A armadilha por baixo de tudo isso é a calibração. A confiança do modelo é mal calibrada: certeza declarada não é evidência de correção, e o tom de uma resposta não carrega nenhuma informação sobre seu valor de verdade. Então nunca condicione uma decisão ao modelo parecer confiante.

Construa e prefira um caminho de abstenção, um "eu não consigo responder isso a partir do que me foi dado" sancionado, e torne abster-se barato para que o sistema recorra a ele em vez de inventar. Essa mentalidade estrutural, assumir que qualquer resposta individual pode estar errada e conter o dano, é sobre o que o capítulo inteiro de segurança e limites é construído.

JunoPor que os modelos inventam coisas Você não consegue eliminar a alucinação, então projete para contenção: valide a estrutura com esquemas, meça a taxa com evals em vez de conferir alguns resultados de olho, e mantenha um humano onde estar errado é caro. A confiança do modelo é mal calibrada, então um tom confiante não é evidência e você nunca condiciona nada a ele. Dê ao sistema uma forma barata e sancionada de se abster, e prefira isso a um palpite confiante, sempre.

Juntando tudo ​

Tudo neste capítulo é uma única ideia vista de ângulos diferentes. Um modelo é uma pilha congelada de números que prevê o próximo token, e quase todo comportamento com o qual você vai lidar decorre disso:

  • Ele prevê um token por vez a partir de uma classificação de probabilidades, então ele improvisa em vez de recordar, e um toque de aleatoriedade (temperatura) faz com que as respostas variem.
  • Tokens são os pedaços com os quais ele trabalha: a unidade da sua conta, a unidade do seu limite de tamanho, e o motivo pelo qual ele não consegue contar letras de forma confiável.
  • A janela de contexto é a mesa de trabalho de uma única requisição, compartilhada por tudo, e o modelo não lembra de nada entre requisições, então a continuidade é responsabilidade sua.
  • O conhecimento dele está congelado num corte de treinamento e nunca incluiu seus dados privados, o que é o motivo de você buscar os fatos e colocá-los no prompt.
  • Alucinação é o preço de um sistema que prevê texto provável sem nenhuma noção de verdade, reduzida por fundamentação e verificação, nunca apenas por formulação inteligente.

Junte tudo isso e uma quantidade surpreendente da engenharia de IA acaba sendo uma única tarefa em diferentes disfarces: colocar o texto certo na mesa, na forma certa, no momento certo, e nunca confiar ciegamente na saída. O próximo capítulo, Modelos abertos e fechados, analisa que tipos de modelos existem e como você consegue um, e depois prompting é onde você começa a direcionar toda essa previsão para o que você realmente quer.

JunoJuntando tudo Quase tudo sobre um modelo decorre de um único fato: ele é um conjunto congelado de números prevendo o próximo token. Disso vêm respostas variadas, custo e limites baseados em tokens, nenhuma memória entre requisições, um corte de treinamento e a alucinação. Boa parte de construir com esses modelos é colocar o texto certo na mesa e nunca confiar ciegamente na saída.

Um fato gera o capítulo inteiro: um modelo é uma função congelada que prevê o próximo token a partir de uma distribuição de probabilidade. Rastreie as consequências e você tem seu modelo funcional:

  • Previsão mais amostragem significa que a saída varia; a temperatura define quanto.
  • Tokens são a unidade do custo, a unidade do limite, e o motivo pelo qual tarefas no nível de caractere pertencem ao código.
  • A janela de contexto é finita e sem estado, então você reenvia e cura tudo que o modelo precisa.
  • O conhecimento está congelado num corte e sem fonte, então fatos atuais e privados vêm de retrieval, não de recordação.
  • Alucinação é estrutural, reduzida por fundamentação e verificação, não por formulação.

O padrão por baixo de tudo isso é o mesmo: colocar o texto certo no contexto, na forma certa, no momento certo, e verificar o que volta. Isso é o que o resto do manual constrói, começando com o panorama de modelos abertos e fechados e depois prompting.

JunoJuntando tudo O capítulo inteiro é um fato e seus desdobramentos: um previsor de próximo token congelado te dá saída variada, custo e limites baseados em tokens, ausência de estado, um corte de conhecimento e alucinação. O trabalho que se segue é constante: colocar o texto certo no contexto na forma certa, depois verificar o que volta. Prompting é onde você começa a fazer isso.

Tudo aqui se reduz a uma frase: uma função congelada prevê o próximo token sobre o texto que você fornece, sem estado, sem sinal de verdade e sem plano. Toda propriedade de produção que você gerencia é um corolário disso:

  • A saída é estocástica, então você testa distribuições, não execuções isoladas.
  • Custo e latência acompanham os tokens, especialmente da saída, então você orça e transmite em streaming.
  • O contexto é finito e sem estado, então a memória é uma escolha de engenharia com modos de falha.
  • O conhecimento paramétrico está congelado, é impreciso e não tem fonte, então qualquer coisa crítica precisa ser fundamentada e citada.
  • A confiança não é calibrada, então você verifica em vez de confiar.

A vantagem é que nada disso se move quando o modelo se move. Fixe uma versão, construa a estrutura em torno dos modos de falha, e o próximo lançamento é uma atualização que você avalia, não uma surpresa que você absorve. O resto do manual é essa estrutura, e ele começa com o panorama, modelos abertos e fechados, depois prompting.

JunoJuntando tudo Uma frase resume o capítulo: um previsor de próximo token congelado e sem estado, sem nenhum sinal de verdade. Saída estocástica, custo dirigido por tokens, contexto finito, conhecimento congelado e confiança não calibrada são todos corolários, e sua estrutura de contenção existe para conter cada um deles. A vantagem é que ela não se move quando o modelo se move, então fixe uma versão e construa em torno dos modos de falha.