Skip to content
This page has been auto-translated and may contain errors.View in English

Agentes ​

docs.scrimba.com

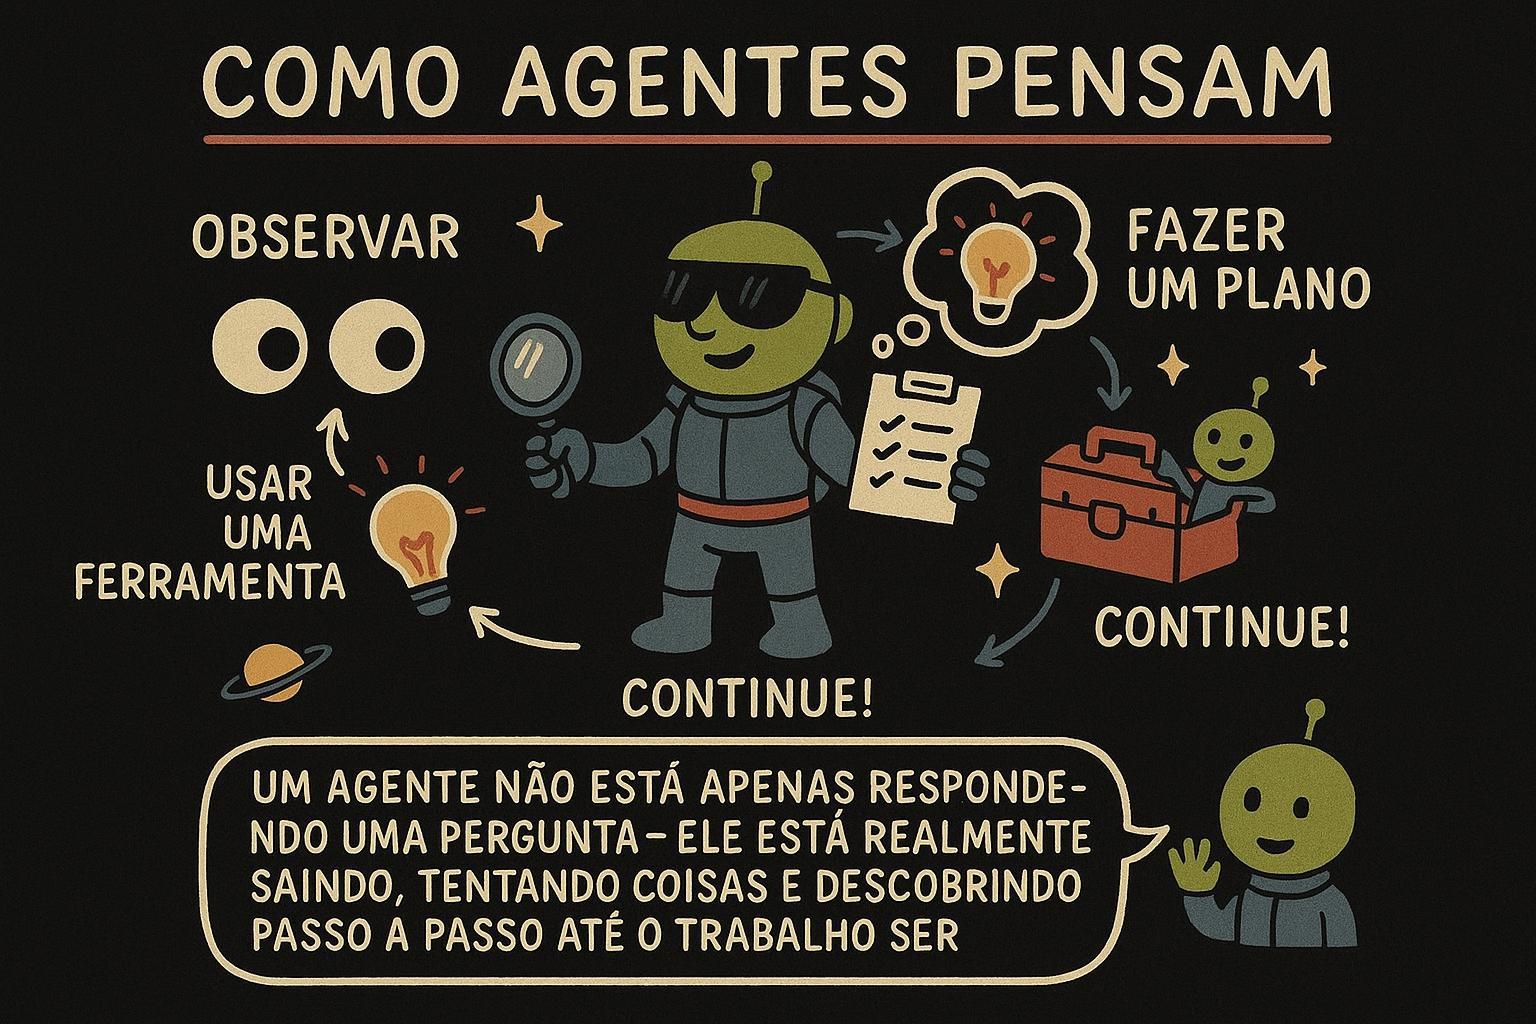
Um agente é um modelo rodando em loop, escolhendo a próxima ferramenta a chamar até que uma tarefa seja concluída. O restante deste capítulo explica o que isso significa, onde essa abordagem vale a pena e onde ela custa caro sem você perceber.

O loop do agente ​

Em uso de ferramentas, o modelo chamava uma função e você devolvia o resultado. Mas algumas tarefas exigem várias etapas, e você não sabe quais são essas etapas de antemão. "Encontre o voo mais barato e reserve" pode significar pesquisar, comparar, verificar uma agenda e então reservar, e o modelo precisa descobrir essa sequência ao longo do caminho.

Então, em vez de lidar com uma única chamada de ferramenta, você coloca tudo isso dentro de um loop. Esse ciclo repetido é o loop do agente, um turno repetido até que a tarefa seja concluída:

  1. Envie a conversa e as ferramentas disponíveis para o modelo.
  2. O modelo chama uma ferramenta ou dá uma resposta final.
  3. Se ele chamou uma ferramenta, execute-a, adicione o resultado à conversa e volte para o passo 1.
  4. Se ele deu uma resposta final, pare.

A cada turno, o modelo vê tudo o que aconteceu até então, incluindo resultados anteriores de ferramentas, e decide o próximo passo. Essa é toda a diferença em relação ao uso de ferramentas: você continua repetindo o loop até que o modelo considere que terminou.

A verdadeira mudança está em quem assume o controle. Em todos os capítulos anteriores, era o seu código que decidia o fluxo de controle: você escolhia quando chamar o modelo, quando executar uma ferramenta, o que vinha a seguir. Um agente entrega essa decisão ao modelo. O loop fica perguntando "o que deve acontecer agora?" e a previsão do modelo é a resposta a cada vez. Você troca controle por flexibilidade, e essa troca é a fonte tanto do alcance quanto do risco.

No fundo, nada de novo está acontecendo. É a mesma previsão sobre um contexto que cresce, o ciclo de ida e volta do uso de ferramentas repetido continuamente. O modelo não elabora um plano e o segue. A cada turno, ele prevê o único próximo passo mais provável a partir do que consegue ver naquele momento, e então o loop roda de novo.

Quando isso funciona, parece um raciocínio direcionado a um objetivo. Quando não funciona, o agente entra em loop sobre si mesmo ou segue por um caminho sem saída, porque nenhuma parte do sistema está de fato guardando o plano geral.

JunoO loop do agente Um agente é o loop de uso de ferramentas repetido: envie a conversa e as ferramentas, o modelo chama uma ferramenta ou dá uma resposta final, você executa a ferramenta e devolve o resultado, e repete até que ele responda. A cada turno, o modelo vê todos os resultados anteriores e escolhe o próximo passo. A única ideia nova em relação ao uso de ferramentas simples é repetir o ciclo em vez de tratar apenas uma chamada.

Em uso de ferramentas, você lidava com uma chamada e devolvia o resultado. Um agente é esse ciclo de ida e volta envolto em um loop, executado até que o modelo decida que terminou. Esse loop é o loop do agente. A mudança é essa: parar de fixar a sequência de passos no código e deixar o modelo escolher o próximo passo a cada turno.

O ciclo tem quatro etapas:

  1. Envie a conversa junto com a lista de ferramentas para o modelo.
  2. O modelo responde com chamadas de ferramentas ou com uma resposta final em texto.
  3. Se ele pediu ferramentas, execute-as, anexe cada resultado à conversa e repita o loop.
  4. Se ele respondeu, pare e retorne.

O mecanismo que faz isso funcionar é que o modelo vê a conversa completa e crescente a cada turno: seu pedido original, cada chamada de ferramenta que ele fez e cada resultado que voltou. Esse contexto acumulado é a única memória do agente. Cada previsão é condicionada por todo o histórico até aquele momento, e é por isso que ele consegue encadear passos que dependem de resultados anteriores.

Um detalhe que vale destacar desde já: o passo 2 pode retornar várias chamadas de ferramenta de uma vez, não apenas uma. Quando as chamadas não dependem umas das outras, como verificar a previsão do tempo em três cidades, o modelo pode pedir as três em um único turno e você as executa juntas. Quando uma chamada precisa do resultado de outra anterior, o modelo tem que esperar por esse resultado antes de poder pedir a próxima, então elas acabam distribuídas em turnos separados. O loop lida com os dois casos: executa quaisquer chamadas que voltaram neste turno, devolve todos os resultados e prevê de novo.

Não existe um plano global em nada disso. O modelo prevê o melhor próximo passo a partir do que consegue ver naquele momento, não a partir de um mapa da tarefa completa. É essa a diferença entre um agente e os pipelines fixos que você já escreveu antes, e é por isso que o mesmo loop capaz de encadear etapas de pesquisa também pode acabar girando em falso.

JunoO loop do agente Um agente é o ciclo de ida e volta do uso de ferramentas dentro de um loop: envie a conversa mais as ferramentas, o modelo chama ferramentas ou responde, você executa as ferramentas e devolve os resultados, repete até ele responder. A conversa crescente é a única memória do agente, então cada passo é condicionado por todos os resultados anteriores. Um turno pode retornar várias chamadas de ferramenta independentes de uma vez, ou uma por vez quando cada uma depende da anterior. Não existe um plano global em lugar nenhum: cada passo é apenas um novo palpite sobre o próximo passo.

Um agente é o ciclo de ida e volta do uso de ferramentas colocado dentro de um loop e com o volante entregue ao modelo, o loop do agente: o modelo escolhe a próxima ferramenta a cada turno, você a executa, devolve o resultado, e repete até que ele emita uma resposta final em vez de uma chamada. O loop tem quatro etapas, e isso não é a parte interessante. A parte interessante é o que essa arquitetura te dá e o que ela não dá.

O ciclo:

  1. Envie a conversa em andamento junto com os esquemas das ferramentas.
  2. O modelo retorna chamadas de ferramenta ou uma resposta final.
  3. Execute as chamadas que houver, anexe os resultados, repita o loop.
  4. Ao receber uma resposta final, retorne.

Um único turno pode retornar várias chamadas de ferramenta. O modelo emite chamadas paralelas quando julga que elas são independentes (três consultas sem dependência de dados entre si) e chamadas seriais em turnos separados quando uma precisa do resultado da outra primeiro. Você não pode forçar isso de fora: se o trabalho é paralelizado ou não é uma decisão do modelo, baseada na tarefa que ele inferiu, então uma tarefa que você imagina paralela pode voltar serializada e mais lenta, e uma que você imagina serial pode voltar como um lote que você precisa estar pronto para executar de uma vez.

Aqui está o fato central, aquele para o qual todo modo de falha remonta. Não existe um plano global. O modelo não guarda um mapa da tarefa e o executa passo a passo. A cada turno, ele prevê o próximo passo a partir da conversa atual, e essa conversa é todo o estado do sistema: seu prompt mais cada chamada e resultado acumulados até aquele momento.

Cada passo confia no passo anterior, sem nada verificando o conjunto. É por isso que um agente que parece estar raciocinando em direção a um objetivo está, na verdade, fazendo uma sequência de palpites plausíveis localmente que, quando dá certo, acabam se somando.

A consequência que vale internalizar agora, porque a seção sobre guardrails vai retomar isso: como o estado é apenas a transcrição crescente e cada passo é condicionado por ela, um resultado errado de ferramenta que aparece no início não é corrigido, ele é usado como base para o resto. O erro se propaga para a frente e se acumula, e nenhuma parte do loop está posicionada para percebê-lo. Boa parte do trabalho de confiabilidade em agentes é justamente lutar contra essa propriedade.

JunoO loop do agente Um agente é o ciclo de ida e volta do uso de ferramentas dentro de um loop, com o modelo no comando: ele escolhe a próxima ferramenta, você a executa, devolve o resultado, repete até que ele responda. Todo o estado é a transcrição crescente, e não existe um plano global em lugar nenhum, apenas uma cadeia de palpites sobre o próximo passo, cada um condicionado pelo anterior. Um turno pode retornar chamadas paralelas quando o modelo as julga independentes, ou seriais quando dependem umas das outras, e você não controla qual delas vai ocorrer. Guarde uma coisa: cada passo confia no passo anterior, então um resultado errado que aparece no início se acumula para a frente sem nada verificando o conjunto.

Um agente mínimo ​

Aqui está o loop em código. Ele reaproveita as definições e implementações de ferramentas de uso de ferramentas e as envolve em um loop que roda até o modelo parar de pedir ferramentas.

python
import json

def run_agent(user_text, tools, tool_impls, max_steps=6):
    messages = [{"role": "user", "content": user_text}]
    step = 0

    while step < max_steps:
        response = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
        message = response.choices[0].message
        messages.append(message)

        calls = message.tool_calls
        if not calls:
            return message.content  # nenhuma ferramenta pedida: esta é a resposta final

        # executa cada ferramenta solicitada e devolve os resultados
        for call in calls:
            args = json.loads(call.function.arguments)
            result = tool_impls[call.function.name](args)
            messages.append({"role": "tool", "tool_call_id": call.id, "content": json.dumps(result)})

        step += 1

    return "Parado: o agente atingiu o limite de passos."  # rede de segurança

Leia de cima a baixo: chame o modelo, empurre a mensagem dele para a conversa e, se ele pediu ferramentas, execute todas e anexe os resultados, depois repita o loop. Quando o modelo retorna texto em vez de uma chamada de ferramenta, essa é a resposta final, e você a retorna.

O valor de max_steps define um limite de passos, a rede de segurança que evita que o loop saia do controle, assunto da próxima seção. A estrutura aqui corresponde ao SDK de um provedor específico; os nomes dos campos variam entre provedores, mas o loop é o mesmo em qualquer lugar.

JunoUm agente mínimo Um agente mínimo é um loop em torno de uma chamada ao modelo: execute o modelo, execute quaisquer ferramentas que ele peça, devolva os resultados, repita. Quando o modelo retorna texto em vez de uma chamada de ferramenta, esse texto é a resposta final. O limite de passos é uma rede de segurança obrigatória, não um extra que você adiciona depois.

Aqui está o loop em código, reaproveitando as definições e implementações de ferramentas de uso de ferramentas. Ele roda até o modelo parar de pedir ferramentas ou até atingir o limite de passos.

python
import json

def run_agent(user_text, tools, tool_impls, max_steps=6):
    messages = [{"role": "user", "content": user_text}]
    step = 0

    while step < max_steps:
        response = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
        message = response.choices[0].message
        messages.append(message)

        calls = message.tool_calls
        if not calls:
            return message.content  # resposta final

        for call in calls:
            args = json.loads(call.function.arguments)
            try:
                result = tool_impls[call.function.name](args)
            except Exception as err:
                result = {"error": str(err)}  # exponha a falha, não deixe o programa quebrar
            messages.append({"role": "tool", "tool_call_id": call.id, "content": json.dumps(result)})

        step += 1

    return "Parado: o agente atingiu o limite de passos."

A estrutura é a de um SDK específico, e os nomes dos campos variam, mas todo loop tem essas partes: anexar a mensagem do modelo, decidir se ele pediu ferramentas, executar as solicitadas e devolver cada resultado como uma mensagem tool associada ao id da chamada.

A única mudança que vale a pena fazer em relação à versão básica é o try/except em torno da ferramenta. Quando uma ferramenta falha, não deixe a exceção derrubar o loop. Capture-a e devolva o erro ao modelo como resultado da ferramenta. Assim, no próximo turno, o modelo pode ler "essa consulta falhou" e se adaptar: tentar de novo com argumentos diferentes, usar outra ferramenta, ou avisar o usuário que não conseguiu concluir a tarefa. Uma quebra não dá ao modelo nenhuma chance de se recuperar; esse padrão de erro como resultado o mantém no loop com informação suficiente para agir.

Duas coisas para acompanhar enquanto isso roda. Primeiro, a conversa só cresce. Cada turno anexa a mensagem do modelo e cada resultado de ferramenta, então no passo cinco o modelo já está relendo tudo dos passos um a quatro de novo. Isso é a memória do agente e também a sua conta: cada passo reenvia todo o contexto acumulado, então o custo em tokens por passo sobe conforme a tarefa avança. Um agente de dez passos não é dez chamadas baratas, é dez chamadas sobre uma transcrição cada vez maior.

Segundo, esse crescimento é o motivo pelo qual max_steps importa além de apenas impedir loops infinitos. Escolha o valor de acordo com a tarefa. Uma pergunta sobre o tempo precisa de dois ou três passos; uma tarefa de pesquisa talvez precise de dez. Defina o limite um pouco acima do que uma execução saudável costuma levar, para que uma tarefa legitimamente mais longa consiga terminar, mas uma que trave ainda seja interrompida antes de drenar seu orçamento.

JunoUm agente mínimo O loop é: anexar a mensagem do modelo, decidir se ele pediu ferramentas, executá-las e devolver cada resultado como uma mensagem tool. Envolva a chamada de ferramenta em try/except e devolva os erros em vez de deixar o programa quebrar, para que o modelo possa tentar de novo ou se recuperar. Fique atento a que a conversa só cresce: cada passo reenvia toda a transcrição, então o custo em tokens por passo sobe conforme a tarefa avança. Defina o max_steps de acordo com a tarefa, um pouco acima do que uma execução saudável costuma levar.

O loop, reaproveitando a camada de ferramentas de uso de ferramentas. A estrutura é a de um SDK de um provedor específico; os nomes dos campos variam, a estrutura não.

python
import json

def run_agent(user_text, tools, tool_impls, max_steps=6):
    messages = [{"role": "user", "content": user_text}]
    step = 0

    while step < max_steps:
        response = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
        message = response.choices[0].message
        messages.append(message)

        calls = message.tool_calls
        if not calls:
            return message.content

        for call in calls:
            args = json.loads(call.function.arguments)
            try:
                result = tool_impls[call.function.name](args)
            except Exception as err:
                result = {"error": str(err)}  # o modelo lê isso e pode se adaptar no próximo turno
            messages.append({"role": "tool", "tool_call_id": call.id, "content": json.dumps(result)})

        step += 1

    return "Parado: o agente atingiu o limite de passos."

O loop básico está correto, mas não é algo que se possa colocar em produção como está, e é na diferença entre os dois que esta seção se concentra. Três propriedades deste código causam problemas quando chegam à produção.

Exponha os erros, nunca deixe o programa quebrar. O try/except devolve ao modelo uma ferramenta que falhou como um resultado que ele consegue ler. Isso está certo, mas entenda o que você está fazendo: você está entregando ao modelo uma string de erro e confiando que ele vai se recuperar de forma sensata. Ele pode repetir a mesma chamada ruim, inventar uma abordagem diferente, ou se desculpar e parar.

Devolver os erros mantém o agente vivo; isso não torna a recuperação confiável. Para qualquer coisa que sustente algo importante, limite o número de tentativas por ferramenta e trate a falha repetida como um estado terminal que você mesmo trata, não como um loop que você deixa o modelo resolver de forma improvisada.

A transcrição só cresce, e isso gera dois custos que se somam. O custo em tokens por passo sobe porque cada chamada reenvia todo o histórico acumulado, então uma execução longa paga uma conta cada vez maior a cada turno, não uma conta fixa. E quanto mais longa a transcrição, mais o modelo está lendo saídas antigas de ferramentas para decidir o próximo movimento, o que é exatamente onde o efeito de perda no meio do capítulo sobre janela de contexto começa a morder: o modelo presta menos atenção a informações enterradas no meio de um contexto longo, e as instruções iniciais que deveriam limitar o agente acabam submersas sob os resultados acumulados e recebem menos atenção. Agentes longos não falham com estrondo, eles vão se desviando pouco a pouco.

max_steps é um orçamento, não uma proteção contra bugs. Ele existe porque o modelo decide quando parar e pode decidir errado: entrar em loop num passo, ficar alternando entre duas ferramentas, ou seguir por um caminho sem saída.

Esse número é um teto de custo real. No pior caso, o gasto é aproximadamente max_steps multiplicado pelo custo de uma chamada com contexto completo próxima do fim da execução, então um limite generoso em uma tarefa com contexto pesado gera uma conta generosa. Defina-o a partir da execução legítima mais longa que você espera, mais uma margem, dispare um alerta quando as execuções costumarem atingi-lo (isso é um sinal de que o agente está travado, não de que o limite está baixo demais) e resista à tentação de aumentá-lo só para mascarar um agente que não consegue terminar.

JunoUm agente mínimo O loop básico está correto, mas não está pronto para produção. Devolva os erros de ferramenta para que o modelo possa se adaptar, mas limite o número de tentativas e trate a falha repetida como algo terminal, porque expor um erro não torna a recuperação confiável. A transcrição só cresce, então o custo em tokens por passo sobe e suas instruções iniciais acabam enterradas sob resultados antigos até o agente começar a se desviar. max_steps é um teto de custo, não uma proteção contra bugs: dimensione-o pela execução real mais longa, mais uma margem, e quando as execuções continuarem atingindo esse limite, é sinal de que o agente está travado, então não aumente o número por reflexo.

Parando e guardrails ​

Um loop que deixa o modelo decidir quando parar pode simplesmente não parar. Ele pode chamar ferramentas para sempre, se repetir, ou seguir por um caminho sem saída. Como cada passo é uma chamada ao modelo cobrada por tokens, um agente fora de controle consome dinheiro e tempo rapidamente.

Por isso, guardrails, os limites que você coloca em torno do loop, fazem parte do design, não são um retoque que se adiciona no final:

  • Um limite de passos. Limite o número de repetições do loop, como faz o max_steps. Quando esse limite for atingido, pare e retorne.
  • Valide as entradas das ferramentas. O modelo escolhe os argumentos, então verifique-os antes de executar qualquer coisa com consequências reais.
  • Limite o que as ferramentas podem fazer. Dê ao agente o mínimo de poder necessário. Uma ferramenta que só lê é mais segura do que uma que deleta.
  • Fique atento ao custo. Várias chamadas ao modelo por tarefa se multiplicam rapidamente, então acompanhe os tokens e defina um orçamento.

O que une tudo isso: o modelo está improvisando o caminho, então cabe a você colocar os limites que ele não vai colocar. Assuma que o agente vai fazer a coisa errada pelo menos uma vez, e faça com que isso seja algo que você consiga sobreviver.

JunoParando e guardrails Um agente decide por conta própria quando parar, então ele pode entrar em loop para sempre, e cada volta do loop custa tokens. Sempre defina um limite de passos, valide os argumentos que o modelo escolhe e dê às ferramentas o mínimo de poder necessário. Acompanhe o custo, porque várias chamadas ao modelo por tarefa se acumulam rápido.

Um loop em que o modelo decide quando parar pode simplesmente não parar, e como cada passo é uma chamada ao modelo cobrada por tokens, um agente travado consome o orçamento rapidamente. Guardrails fazem parte do design. São quatro para incorporar:

  • Um limite de passos. Limite as repetições com max_steps e retorne de forma limpa quando o limite for atingido. Essa é a sua parada de emergência contra loops fora de controle.
  • Valide as entradas das ferramentas. O modelo escolhe os argumentos, e pode escolher errado ou ser induzido a escolher errado. Verifique-os antes de qualquer ferramenta com consequências reais ser executada: uma exclusão sem id, uma transferência com valor negativo, um caminho fora do diretório permitido.
  • Poder mínimo. Dê a cada ferramenta a capacidade mais restrita que a tarefa exigir. Somente leitura é melhor do que leitura e escrita, uma consulta delimitada é melhor do que acesso bruto ao banco de dados, uma lista fixa de destinatários é melhor do que envio arbitrário.
  • Teto de custo. Acompanhe os tokens ao longo de toda a execução, não por chamada, e interrompa quando uma execução ultrapassar o orçamento.

O ponto que amarra tudo isso é que os argumentos das suas ferramentas vêm do modelo, o que significa que eles vêm, indiretamente, de qualquer texto que o modelo tenha lido. Se uma ferramenta buscou uma página da web e essa página continha instruções, essas instruções agora estão no contexto do modelo e podem influenciar a próxima chamada de ferramenta. Isso é prompt injection: texto não confiável no contexto influenciando o que o agente faz. A defesa não está no prompt. Está em validar cada entrada de ferramenta e delimitar o poder de cada ferramenta, de modo que mesmo um argumento totalmente sequestrado não consiga causar dano real.

JunoParando e guardrails Quatro guardrails, parte do design, não um retoque: uma parada rígida com max_steps, validação de entrada em cada ferramenta consequente, delimitação de poder mínimo nas ferramentas e um orçamento de tokens para toda a execução. O motivo pelo qual a validação de entrada importa: os argumentos das ferramentas vêm do modelo, o que significa que vêm de qualquer texto que ele tenha lido, então uma página buscada que carregue instruções é prompt injection e pode influenciar a próxima chamada. Valide as entradas e delimite o poder das ferramentas para que mesmo um argumento sequestrado não consiga causar dano.

Um loop em que o modelo decide quando parar pode simplesmente não parar, e como cada passo é uma chamada cobrada por tokens, o modo de falha já é caro por padrão. Os quatro guardrails (limite de passos, validação de entrada, poder mínimo, teto de custo) são o básico esperado. A parte que merece sua atenção é entender por que a validação de entrada é um controle de segurança, não apenas uma verificação de sanidade.

Os argumentos das ferramentas são saída do modelo, e a saída do modelo é condicionada por tudo o que está no contexto, incluindo texto que o agente buscou de fora. No momento em que um agente lê uma página da web, um documento, um e-mail ou um resultado de ferramenta que você não controla, há texto não confiável no seu contexto, e esse texto pode carregar instruções. Isso é prompt injection: conteúdo adversário na entrada direcionando o modelo para ações que você não pretendia. Em um prompt de disparo único, isso é um incômodo. Em um agente, é uma exploração ativa, porque o próximo movimento do modelo é uma chamada de ferramenta com efeito no mundo real, e o texto injetado consegue influenciar essa chamada.

Projete pensando nisso como algo adversário, porque é. Três regras se mantêm firmes:

  • Valide cada argumento de ferramenta contra uma lista de permissões, não uma lista de bloqueios. Defina como é um argumento válido (este formato de id, este conjunto de destinatários, este diretório) e rejeite tudo o mais. Você não consegue enumerar toda entrada ruim que um atacante vai criar; mas consegue enumerar as boas.
  • Delimite o poder das ferramentas de modo que uma chamada totalmente sequestrada seja algo sobrevivível. Assuma que o argumento está sob controle de um atacante e pergunte o que a ferramenta poderia fazer nessa situação. Se a resposta real for "enviar e-mail para qualquer pessoa" ou "deletar qualquer registro", a ferramenta é abrangente demais, não importa quão cuidadoso seja o prompt. Poder mínimo é o controle que se mantém quando o modelo está comprometido, e o prompt não é um controle de verdade.
  • Coloque um humano no loop para ações irreversíveis. Enviar dinheiro, excluir dados, enviar e-mail para clientes: condicione essas ações a uma confirmação. O agente propõe, uma pessoa ou uma verificação mais rígida decide.

O motivo mais profundo pelo qual nada disso pode viver dentro do prompt: as instruções do prompt de sistema e as instruções injetadas em conteúdo buscado chegam como o mesmo tipo de coisa, texto dentro do contexto, e o modelo não tem uma forma confiável de dar mais peso a uma do que à outra. Por isso, você não consegue alcançar segurança apenas escrevendo o prompt certo. A fronteira que realmente se mantém está fora do modelo: entradas validadas e ferramentas com poder delimitado. Isso se conecta com o tratamento mais amplo em segurança e limites.

JunoParando e guardrails Os quatro guardrails são o básico esperado; o que merece mais reflexão é a validação de entrada, porque ela é um controle de segurança. Os argumentos das ferramentas são saída do modelo condicionada por tudo o que ele leu, então qualquer página ou e-mail buscado pode carregar instruções injetadas que direcionam a próxima chamada, e em um agente essa chamada tem efeito no mundo real. Valide contra uma lista de permissões, delimite cada ferramenta para que um argumento sequestrado ainda seja sobrevivível, e condicione ações irreversíveis à aprovação de um humano. Você não consegue alcançar segurança só com o prompt: instruções injetadas e instruções de sistema são o mesmo tipo de texto para o modelo, então a fronteira precisa existir fora dele.

Quando um workflow é melhor que um agente ​

Agentes são empolgantes, o que torna tentador usar um mesmo quando você não precisa. A regra simples: se você já conhece os passos, não use um agente. Escreva-os como código simples, um workflow, em que cada passo roda em uma ordem fixa.

Um workflow é mais confiável, mais barato e muito mais fácil de depurar, porque você controla o caminho em vez de esperar que o modelo o encontre. Reserve os agentes para tarefas abertas, em que os passos dependem do que é descoberto ao longo do caminho.

Muitos recursos que parecem precisar de um agente ficam melhores como uma chamada de saída estruturada ou uma consulta de RAG montada manualmente com código. Recorra a um agente apenas quando você não conseguir escrever os passos com antecedência.

JunoQuando um workflow é melhor que um agente Se você já conhece os passos, fixe-os como um workflow em vez de usar um agente: é mais barato, mais confiável e mais fácil de depurar. Reserve os agentes para tarefas abertas, em que os passos dependem do que é descoberto ao longo do caminho. Muitos recursos "de agente" são, na verdade, uma chamada de saída estruturada ou RAG montada manualmente com código.

Agentes são a ferramenta empolgante, e é exatamente por isso que acabam sendo usados mesmo quando não são a escolha certa. A regra de decisão se resume a uma pergunta: você consegue escrever os passos com antecedência? Se sim, você quer um workflow, os passos como código simples em uma ordem fixa, não um agente.

Um workflow ganha em tudo em que um agente tem dificuldade. É mais barato, porque você faz uma ou duas chamadas ao modelo em vez de um loop delas. É mais confiável, porque o caminho é fixo em vez de ser redecidido a cada turno. E é muito mais fácil de depurar, porque uma falha acontece em um passo conhecido que você pode inspecionar, não em algum ponto dentro de uma cadeia de movimentos escolhidos pelo modelo.

Aqui está o teste na prática. "Resuma este chamado de suporte, classifique sua urgência e encaminhe-o para uma fila" tem passos conhecidos em uma ordem conhecida, então é um workflow: uma chamada de saída estruturada para obter o resumo, a categoria e a urgência, seguida de código simples para encaminhar de acordo com o resultado. "Investigue por que os últimos três pedidos deste cliente falharam" não tem passos conhecidos, o caminho depende do que cada consulta revela, então é um agente.

A armadilha é que muitos recursos parecem abertos e não são. Extrair campos de um documento, responder com base na sua documentação, organizar e-mails que chegam: tudo isso parece trabalho de agente, mas se resolve como uma chamada de saída estruturada ou uma consulta de RAG com código em volta. Comece pelo workflow como padrão e deixe uma tarefa conquistar o direito de usar um agente por ser imprevisível de um jeito que você não consegue programar de antemão.

JunoQuando um workflow é melhor que um agente A decisão se resume a uma pergunta: você consegue escrever os passos com antecedência? Se sim, construa um workflow, os passos como código simples, porque é mais barato, mais confiável e depurável em um ponto conhecido. "Resumir, classificar, encaminhar um chamado" é um workflow: uma chamada de saída estruturada mais código de encaminhamento. "Investigar por que estes pedidos falharam" é um agente, porque o caminho depende do que cada passo descobre. Use o workflow por padrão e faça a tarefa conquistar o direito de usar um agente.

O agente é a ferramenta que as pessoas querem usar, e é por isso que ele acaba sendo usado onde não deveria. A regra de decisão é curta: se você consegue escrever os passos com antecedência, escreva-os. Isso é um workflow, os passos como código em uma ordem fixa, e ele supera um agente em custo, confiabilidade e facilidade de depuração para qualquer tarefa cujo formato você já conhece.

O motivo remonta direto à arquitetura. Um agente não tem plano global e acumula erros para a frente, então sua confiabilidade é o produto de cada passo dar certo, sem nada verificando o conjunto. Um workflow que você escreveu tem um plano, por definição, e você pode inspecionar, testar e validar cada passo isoladamente. Quando algo quebra em um workflow, quebra em uma linha. Quando algo quebra em um agente, quebra em algum ponto de uma transcrição de movimentos escolhidos pelo modelo, e você tem que reconstruir o que ele estava pensando a partir do rastro deixado.

Agora o caso mais difícil, porque "eu sei os passos" é a metade fácil. Um agente pode ser a ferramenta errada mesmo quando a tarefa é aberta, quando o custo de um passo errado é alto demais para deixar que um "chutador de próximo passo" o tome. Um agente que reserva viagens, movimenta dinheiro ou modifica dados de produção é uma tarefa aberta, mas também um lugar onde você não quer um loop imprevisível, sujeito a injeção e que acumula erros no controle. O design certo ali costuma ser um híbrido: o modelo planeja ou propõe, mas um workflow fixo e barreiras humanas executam, de modo que a parte imprevisível nunca toca diretamente na parte irreversível.

Então a pergunta na verdade são duas perguntas. Você conhece os passos, e quanto custa um passo errado?

Passos conhecidos vão para um workflow. Passos desconhecidos com ações baratas e reversíveis são onde um agente realmente compensa. Passos desconhecidos com ações caras e irreversíveis pedem um design restrito, não um loop rodando livremente.

Um agente se encaixa em trabalho aberto com passos baratos e reversíveis, e pouco mais além disso. Uma parcela surpreendente dos recursos "de agente" é, na verdade, uma chamada de saída estruturada ou uma consulta de RAG com código em volta, e é melhor que continuem assim.

JunoQuando um workflow é melhor que um agente Duas perguntas, não uma: você conhece os passos, e quanto custa um passo errado? Passos conhecidos vão para um workflow, que supera um agente em custo, confiabilidade e depuração porque tem um plano, coisa que o agente nunca tem. Passos desconhecidos com ações baratas e reversíveis são onde um agente conquista seu lugar. Passos desconhecidos com ações caras e irreversíveis pedem um híbrido: o modelo propõe, um workflow fixo e barreiras humanas executam, de modo que o loop que acumula erros nunca toque na parte que você não pode desfazer.

Na prática ​

A função run_agent acima é tudo o que existe. Dê a ela uma pergunta, um conjunto de ferramentas e suas implementações, e ela roda em loop até terminar ou até atingir o limite de passos. Uma tarefa pequena mostra o loop compensando o esforço:

python
answer = run_agent(
    "What's the weather in Brasília and should I bring an umbrella?",
    tools,        # inclui get_weather do capítulo sobre uso de ferramentas
    tool_impls,   # {"get_weather": ...}
)
# O agente chama get_weather, lê "nublado", e então responde em um turno final:
# "Está nublado em Brasília, a 18 graus, então um guarda-chuva é uma boa ideia."

Uma ferramenta, um loop, uma resposta. A mesma estrutura escala para várias ferramentas e vários passos sem mudar de formato. Uma vez que você consegue construir algo tão capaz, a próxima pergunta é como saber se isso realmente funciona, e é sobre isso que trata evals.

JunoNa prática O loop run_agent é todo o padrão: dê a ele uma pergunta, ferramentas e suas implementações, e ele roda em loop até o modelo parar de pedir ferramentas ou atingir o limite de passos. Uma ferramenta e um loop escalam para muitas sem mudar de formato. A próxima pergunta é como saber se isso realmente funciona, e é aí que entram os evals.

A função run_agent é todo o padrão. Dê a ela uma pergunta, ferramentas e suas implementações, e ela roda em loop até o modelo parar de pedir ferramentas ou atingir o limite.

python
answer = run_agent(
    "What's the weather in Brasília and should I bring an umbrella?",
    tools,        # inclui get_weather do capítulo sobre uso de ferramentas
    tool_impls,   # {"get_weather": ...}
)
# O agente chama get_weather, lê "nublado", e então responde em um turno final.

Uma ferramenta, um loop, uma resposta, e o mesmo formato escala para várias ferramentas e vários passos. O que não escala de graça é a sua confiança de que isso funciona. Um workflow você consegue testar passo a passo; um agente segue um caminho diferente para cada entrada diferente, então uma execução que funcionou ontem te diz pouco sobre a execução que falha hoje.

É por isso que a próxima coisa a construir junto com um agente é uma forma de medi-lo: executá-lo em um conjunto de tarefas representativas e verificar os resultados, em vez de confiar em uma única demonstração bem-sucedida. Transformar "funcionou quando eu testei" em um número que você consegue acompanhar é exatamente o que evals cobre.

JunoNa prática O loop run_agent é todo o padrão, e uma ferramenta e um loop escalam para muitas sem mudar de formato. A pegadinha é a confiança: um agente segue um caminho diferente para cada entrada, então uma boa demonstração prova pouco sobre a próxima execução. Construa uma forma de medi-lo em um conjunto de tarefas representativas em vez de confiar em um único sucesso, e é para isso que existem os evals.

A função run_agent é todo o padrão, e o exemplo abaixo é o mínimo possível: uma ferramenta, um loop, uma resposta.

python
answer = run_agent(
    "What's the weather in Brasília and should I bring an umbrella?",
    tools,        # inclui get_weather do capítulo sobre uso de ferramentas
    tool_impls,   # {"get_weather": ...}
)
# get_weather retorna "nublado", o modelo responde em um turno final.

A estrutura escala para muitas ferramentas e muitos passos sem mudar, e é justamente aí que está a armadilha, porque os modos de falha escalam junto, enquanto o código permanece o mesmo. Um agente é dependente do caminho: entradas diferentes geram sequências diferentes de passos escolhidos pelo modelo, então testar entrada por entrada te diz quase nada sobre a entrada que você ainda não viu. A aleatoriedade proveniente da amostragem faz com que até a mesma entrada possa seguir por um caminho diferente em duas execuções.

Por isso, o que você constrói junto com um agente é medição, e é um tipo de medição diferente do que um workflow exige. Você não está afirmando uma única saída esperada; está amostrando muitas tarefas representativas e lendo a distribuição dos resultados: com que frequência ele termina dentro do orçamento, com que frequência chega à resposta certa, onde entra em loop, quanto custa nos casos extremos. Essa é a versão para agentes dos evals, e é a única forma de transformar as preocupações de confiabilidade, custo e segurança discutidas nas seções acima em números que você pode defender, em vez de uma demonstração em que você teve sorte.

JunoNa práticarun_agent é todo o padrão, e ele escala em estrutura enquanto os modos de falha escalam junto. Um agente é dependente do caminho, e a amostragem adiciona não determinismo, então testar entrada por entrada te diz pouco, e uma boa demonstração prova ainda menos. Meça-o do jeito certo para agentes: amostre muitas tarefas representativas e leia a distribuição, com que frequência ele termina dentro do orçamento, onde entra em loop, quanto custa nos casos extremos. É para isso que existem os evals, e é assim que as preocupações de confiabilidade e custo mencionadas acima se transformam em números que você pode defender.