

 The AI Engineer Path
Evals

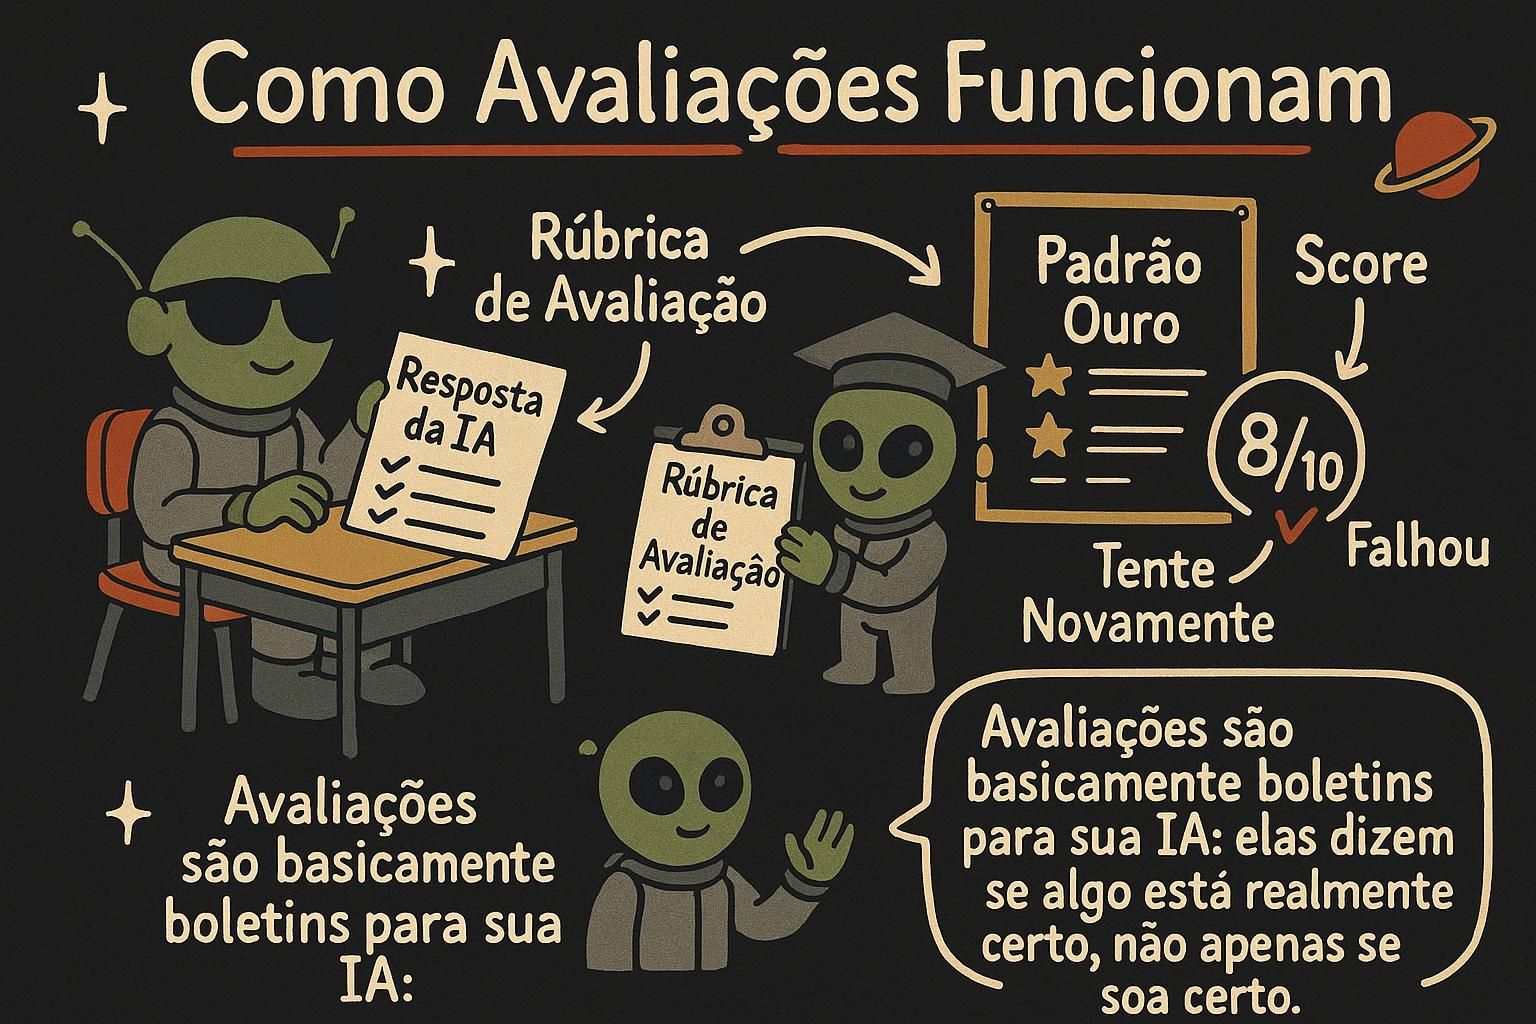
Você muda um prompt, testa uma vez, a resposta parece melhor, você publica, e uma semana depois os usuários encontram os casos que a mudança silenciosamente piorou. Um eval (abreviação de "evaluation", avaliação) é a solução: um teste repetível para saber se sua funcionalidade de IA funciona, um conjunto de entradas pareadas com o que seria uma boa saída, avaliado sempre da mesma forma para que você saiba se uma mudança realmente ajudou. Um modelo é uma caixa-preta probabilística que responde à mesma pergunta de forma diferente a cada execução, então medir é a única forma de saber ao certo, e essa disciplina é boa parte do que separa uma demonstração de um produto.
Por que confiar no olho falha
Checar as respostas da sua IA manualmente parece funcionar bem no começo. Você executa um prompt, lê a resposta, ela parece boa, e você segue adiante. O problema é que três coisas trabalham silenciosamente contra você, e você já encontrou todas elas.
Aqui estão as três:
- A saída varia. O mesmo prompt pode gerar respostas diferentes a cada execução, então um resultado bom não garante que o próximo também será bom.
- Mudanças causam regressões. Um ajuste no prompt que corrige um caso costuma quebrar outro que você não estava observando.
- Não escala. Você consegue ler cinco respostas. Você não consegue ler quinhentas toda vez que mudar uma linha.
Nada disso significa que você fez algo errado. Significa que confiar no olho é a ferramenta errada para um trabalho desse tamanho, e existe um jeito mais tranquilo de fazer isso.

Monte um conjunto de avaliação
Um conjunto de avaliação é uma lista de casos de teste. Cada caso tem uma entrada e o que seria uma boa saída para ela. Comece pequeno. De dez a vinte casos que cobrem suas situações comuns, mais alguns casos-limite complicados, são muito mais úteis do que nenhum, e você pode crescer o conjunto conforme encontra novas falhas no mundo real.
eval_set = [
    {"input": "A comida estava fria e atrasou.", "expected": "NEGATIVE"},
    {"input": "Melhor refeição da minha vida!", "expected": "POSITIVE"},
    {"input": "Foi ok, nada especial.", "expected": "NEUTRAL"},
    # ...adicione casos reais e casos-limite conforme forem descobertos
]
Quando um usuário relatar uma resposta ruim, adicione-a ao conjunto com a saída que ela deveria ter dado. Seu conjunto de avaliação se torna então uma memória crescente de todo erro que você nunca quer repetir, do mesmo jeito que um bug corrigido se transforma num teste que você mantém.
Como avaliar
Tarefas diferentes precisam de avaliações diferentes, então o primeiro passo é combinar a checagem com o tipo de resposta que você espera.
- Correspondência exata funciona quando existe apenas uma resposta correta: um rótulo de classificação, um campo extraído, um sim ou não. Você compara a saída diretamente com o valor esperado.
- Avaliação por critérios funciona quando não há uma única resposta correta, como um resumo ou uma réplica. Você checa se a saída atende a condições: O resumo menciona o fato principal? Tem menos de 50 palavras? O tom é educado?
- LLM como juiz usa uma segunda chamada ao modelo para avaliar a saída de acordo com seus critérios. Escala bem para questões de qualidade difíceis de definir que uma checagem simples não consegue capturar, mas o juiz também é um modelo, então pode errar, e você deve confrontar seu julgamento com o julgamento humano de vez em quando.
# avaliação por correspondência exata sobre o conjunto de avaliação
def run_evals(eval_set, classify):
    passed = 0
    for test in eval_set:
        output = classify(test["input"])
        if output == test["expected"]:
            passed += 1
        else:
            print(f'FAIL: "{test["input"]}" -> got {output}, wanted {test["expected"]}')
    print(f"{passed}/{len(eval_set)} passed")
Correspondência exata é o ponto de partida mais amigável, e se encaixa perfeitamente no trabalho de classificação e extração dos capítulos anteriores. A ideia do LLM como juiz funciona porque perceber se uma resposta atende a um padrão é geralmente uma previsão mais fácil do que produzir a resposta, do mesmo jeito que revisar uma redação é mais fácil do que escrevê-la. Mas o juiz é outro previsor com as mesmas falhas, então trate suas pontuações como uma estimativa útil, dê a ele um roteiro de avaliação claro, e confira suas notas contra as suas próprias em uma amostra de vez em quando.
Execute a cada mudança
Um conjunto de avaliação só é útil se você realmente o executar. Trate seus prompts como código: antes de publicar uma mudança em um prompt, em um modelo, ou na sua recuperação de dados, execute as avaliações e compare a pontuação com a de antes. Se o número caiu, você causou uma regressão, mesmo que seu único teste manual tenha parecido bom.
Isso é o que transforma a engenharia de prompt de um chute em algo que você pode iterar com confiança. Mude algo, meça, mantenha o que pontua melhor, e descarte o que pontua pior. É o mesmo ciclo que torna o software comum confiável, agora aplicado às partes difusas de uma funcionalidade de IA.
Se a pontuação caiu, você causou uma regressão. Um teste manual afortunado não anula o conjunto, então deixe o número decidir sempre.
Na prática
A função run_evals da seção anterior é um arcabouço de avaliação completo, ainda que pequeno. Você aponta ela para seu classificador e seu conjunto de avaliação, e ela te diz quantos casos passam e mostra exatamente quais falham:
run_evals(eval_set, classify_review)
# FAIL: "Foi ok, nada especial." -> got POSITIVE, wanted NEUTRAL
# 2/3 passed
Aquela única linha de falha vale mais do que uma dezena de testes manuais bem-sucedidos, porque aponta para uma fraqueza real que agora você pode corrigir e medir de novo. O capítulo final, Segurança e limites, cobre os riscos contra os quais você precisa se planejar antes de colocar qualquer coisa disso na frente de usuários reais.
run_evals já se paga: te dá uma pontuação e os casos exatos que quebraram. Corrija um, execute de novo, veja o número se mover. A seguir, Segurança e limites cobre o que observar antes que usuários reais cheguem.