

 The AI Engineer Path
Evaluaciones

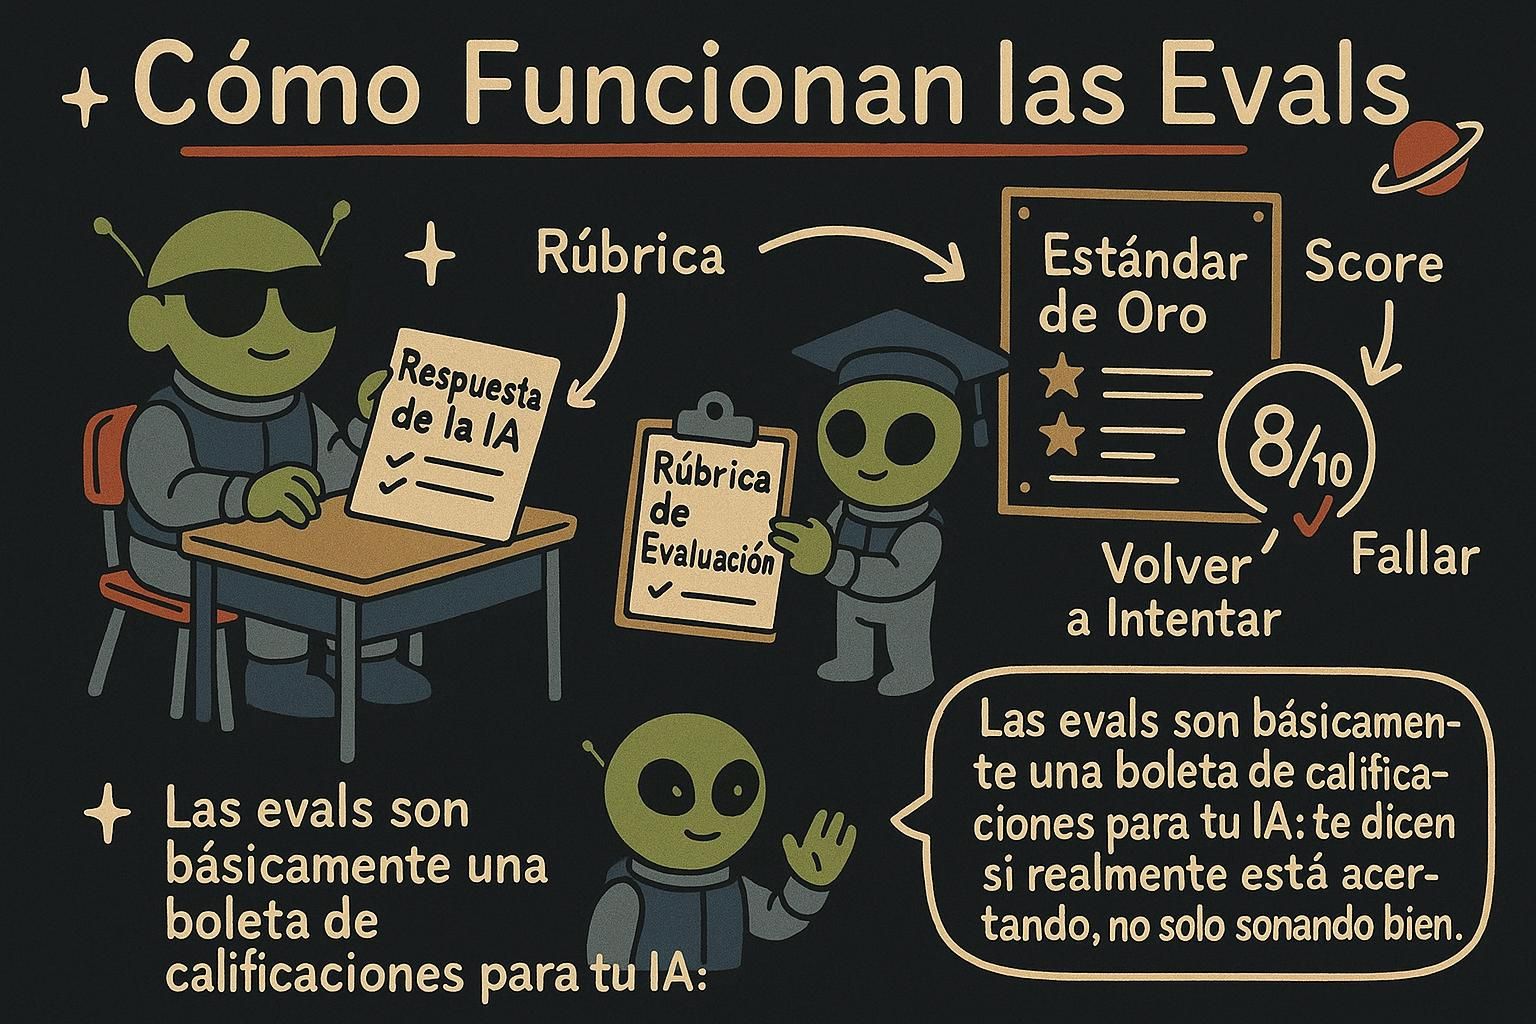
Cambias un prompt, lo pruebas una vez, la respuesta se ve mejor, y lo lanzas; una semana después los usuarios encuentran los casos que quedaron peor sin que te dieras cuenta. Una evaluación (o "eval", del inglés evaluation) es la solución: una prueba repetible de si tu funcionalidad de IA funciona, un conjunto de entradas junto con lo que debería ser una buena salida, calificado de la misma forma cada vez para que puedas saber si un cambio realmente ayudó. Un modelo es una caja negra probabilística que responde la misma pregunta de forma distinta en cada corrida, así que medir es la única manera de saberlo con certeza, y esa disciplina es gran parte de lo que separa una demo de un producto real.
Por qué revisar a simple vista no basta
Revisar las respuestas de tu IA a mano se siente bien al principio. Corres un prompt, lees la respuesta, se ve bien, y sigues adelante. El problema es que hay tres cosas que juegan en tu contra sin que lo notes, y ya te has topado con las tres.
Aquí están:
- La salida varía. El mismo prompt puede dar respuestas distintas en cada corrida, así que un buen resultado no garantiza que el siguiente también lo sea.
- Los cambios provocan regresiones. Un ajuste al prompt que arregla un caso a menudo rompe otro que no estabas mirando.
- No escala. Puedes leer cinco respuestas. No puedes leer quinientas cada vez que cambias una línea.
Nada de esto significa que hayas hecho algo mal. Significa que revisar a simple vista es la herramienta equivocada para un trabajo de este tamaño, y hay una forma más tranquila de hacerlo.

Armar un conjunto de evaluación
Un conjunto de evaluación es una lista de casos de prueba. Cada caso tiene una entrada y lo que debería ser una buena salida para ella. Empieza en pequeño. De diez a veinte casos que cubran tus situaciones comunes más algunos casos límite complicados son mucho más útiles que ninguno, y puedes ir ampliando el conjunto a medida que descubres nuevas fallas en el mundo real.
eval_set = [
    {"input": "La comida llegó fría y tarde.", "expected": "NEGATIVE"},
    {"input": "¡La mejor comida de mi vida!", "expected": "POSITIVE"},
    {"input": "Estuvo bien, nada especial.", "expected": "NEUTRAL"},
    # ...agrega casos reales y casos límite a medida que los descubras
]
Cuando un usuario reporta una mala respuesta, agrégala al conjunto junto con la respuesta que debería haber dado. Tu conjunto de evaluación se convierte entonces en una memoria creciente de cada error que nunca quieres volver a cometer, de la misma forma que un bug que arreglas se convierte en una prueba que conservas.
Cómo calificar
Distintas tareas necesitan distintas formas de calificar, así que el primer paso es hacer coincidir la verificación con el tipo de respuesta que esperas.
- Coincidencia exacta funciona cuando hay una sola respuesta correcta: una etiqueta de clasificación, un campo extraído, un sí o un no. Comparas la salida con el valor esperado directamente.
- Basada en criterios funciona cuando no hay una única respuesta correcta, como un resumen o una respuesta abierta. Revisas si la salida cumple ciertas condiciones: ¿El resumen menciona el dato clave? ¿Tiene menos de 50 palabras? ¿El tono es cordial?
- Modelo como juez (LLM-as-judge) usa una segunda llamada al modelo para calificar la salida contra tus criterios. Escala bien para preguntas de calidad difusas que una verificación simple no puede capturar, pero el juez es en sí mismo un modelo, así que puede equivocarse, y conviene verificarlo de vez en cuando contra el juicio humano.
# calificación por coincidencia exacta sobre el conjunto de evaluación
def run_evals(eval_set, classify):
    passed = 0
    for test in eval_set:
        output = classify(test["input"])
        if output == test["expected"]:
            passed += 1
        else:
            print(f'FAIL: "{test["input"]}" -> got {output}, wanted {test["expected"]}')
    print(f"{passed}/{len(eval_set)} passed")
La coincidencia exacta es el punto de partida más amigable, y encaja perfecto con el trabajo de clasificación y extracción de capítulos anteriores. La idea del modelo como juez funciona porque detectar si una respuesta cumple un estándar suele ser una predicción más fácil que producir la respuesta en sí, de la misma forma que revisar un ensayo es más fácil que escribirlo. Pero el juez es otro modelo con las mismas debilidades, así que trata sus puntuaciones como una estimación útil, dale una rúbrica clara, y compara sus calificaciones con las tuyas en una muestra de vez en cuando.
Córrelas en cada cambio
Un conjunto de evaluación solo sirve si realmente lo corres. Trata tus prompts como código: antes de lanzar un cambio a un prompt, a un modelo, o a tu recuperación de información, corre las evaluaciones y compara la puntuación con la de antes. Si el número bajó, causaste una regresión, aunque tu única prueba manual haya salido bien.
Esto es lo que convierte la ingeniería de prompts de una adivinanza en algo sobre lo que puedes iterar con confianza. Cambia algo, mídelo, conserva lo que puntúa más alto, y descarta lo que puntúa más bajo. Es el mismo ciclo que hace confiable al software común, ahora aplicado a las partes difusas de una funcionalidad de IA.
Si la puntuación bajó, causaste una regresión. Una prueba manual con suerte no anula al conjunto, así que deja que el número sea el que decida siempre.
En la práctica
La función run_evals de la sección anterior es un arnés de evaluación completo, aunque pequeño. Lo apuntas a tu clasificador y a tu conjunto de evaluación, y te dice cuántos casos pasan y te muestra exactamente cuáles fallan:
run_evals(eval_set, classify_review)
# FAIL: "Estuvo bien, nada especial." -> got POSITIVE, wanted NEUTRAL
# 2/3 passed
Esa única línea que falla vale más que una docena de pruebas manuales exitosas, porque señala una debilidad real que ahora puedes arreglar y volver a medir. El capítulo final, Seguridad y límites, cubre los riesgos contra los que hay que diseñar antes de poner cualquiera de esto frente a usuarios reales.
run_evals ya se justifica por sí solo: te da una puntuación y los casos exactos que fallaron. Arregla uno, corre de nuevo, mira cómo se mueve el número. Lo siguiente, Seguridad y límites, cubre qué cuidar antes de que lleguen los usuarios reales.