

 The AI Engineer Path
Fine-tuning

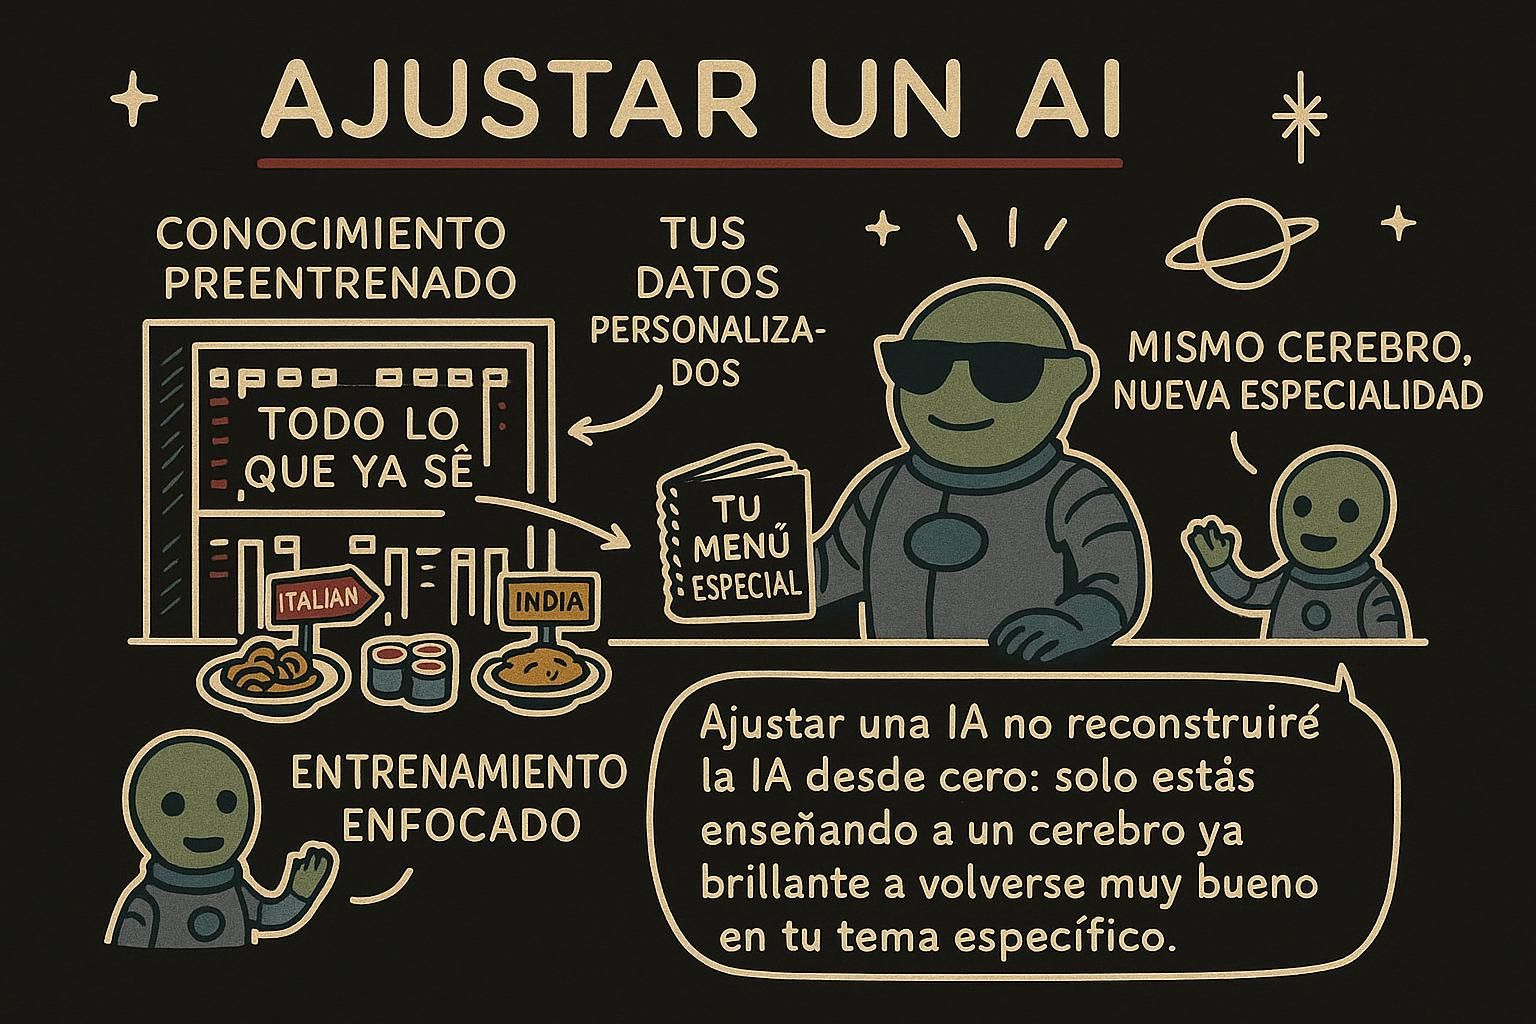
Fine-tuning significa tomar un modelo existente y seguir entrenándolo con tus propios ejemplos, de modo que su comportamiento por defecto se acerque a lo que necesitas. Este capítulo te da una idea concreta de qué cambia el fine-tuning, para qué sirve, y cuándo conviene usarlo en lugar de un prompt o de recuperación de información.
Qué hace realmente el entrenamiento
Para entender qué cambia el fine-tuning, ayuda saber de dónde sale un modelo. Un modelo se construye en dos etapas generales.
La primera es el preentrenamiento (pretraining): el modelo lee una cantidad enorme de texto y aprende a predecir el siguiente token, una y otra vez, hasta que la gramática, los hechos y los patrones de razonamiento quedan incorporados en él como efecto colateral. El resultado es un modelo base, fluido pero sin un rumbo definido. Va a continuar tu texto sin problema, pero no ha sido entrenado para ser un asistente útil que responda preguntas.
La segunda etapa es el post-entrenamiento: el modelo base se sigue entrenando con ejemplos curados de buenas respuestas, junto con retroalimentación humana sobre qué respuestas son mejores. Esto es lo que convierte a un predictor de texto crudo en el asistente que sigue instrucciones con el que realmente hablas. El modelo que llamas desde una API ya pasó por ambas etapas.
Ambas etapas funcionan con el mismo mecanismo: mostrarle ejemplos al modelo y ajustar sus números internos, sus parámetros o pesos, para que sus predicciones se acerquen más a esos ejemplos. El entrenamiento es práctica de predicción que deja al modelo permanentemente modificado.

Qué es el fine-tuning
El fine-tuning es una versión pequeña y enfocada de esa segunda etapa, que ejecutas tú mismo. Tomas un modelo que ya está entrenado y sigues entrenándolo con un conjunto de tus propios ejemplos, cada uno una entrada emparejada con la salida que quisieras que produjera. Después de suficientes ejemplos, los pesos del modelo se ajustan de modo que ese tipo de respuesta se vuelve su comportamiento por defecto, sin que tengas que pedirlo en el prompt cada vez.
La diferencia real frente al prompting y a RAG está en dónde vive el cambio. El prompting y RAG dejan al modelo congelado y lo guían mediante el contexto que le das en el momento de la llamada. El fine-tuning cambia al modelo mismo, así que el nuevo comportamiento queda incorporado y aparece incluso con un prompt corto. No estás dando mejores instrucciones en tiempo de ejecución; estás entregando un modelo que ya se inclina hacia lo que quieres.
En la práctica le entregas al proveedor un archivo con conversaciones de ejemplo, este ejecuta un trabajo de entrenamiento, y te devuelve un nuevo id de modelo. Llamas ese id exactamente igual que a cualquier otro modelo, salvo que ahora sus respuestas reflejan lo que le enseñaste. El fine-tuning traslada el comportamiento al modelo; el prompting y RAG guían a uno que permanece congelado.
Para qué sirve, y para qué no
El fine-tuning se gana su lugar cuando necesitas un comportamiento consistente que un prompt tiene dificultad para fijar: un formato de salida preciso todas las veces, un tono o estilo particular, o una tarea acotada como clasificación hecha de forma confiable a lo largo de miles de llamadas. También puede hacer que las llamadas sean más baratas y rápidas, porque el comportamiento que de otro modo tendrías que explicar en un prompt largo queda incorporado en el modelo, así que tus prompts se vuelven más cortos.
Donde falla es en el conocimiento. El fine-tuning es malo para enseñarle a un modelo hechos nuevos, y peor aún con hechos que cambian. Los ejemplos de entrenamiento se difuminan en patrones generales en lugar de quedar guardados como entradas exactas y consultables, así que un modelo con fine-tuning sigue inventando detalles y sigue quedando desactualizado en el momento en que tu información se actualiza. Volver a entrenar cada vez que cambia un precio o una política es lento y costoso. Cuando el problema es "el modelo no sabe X", la respuesta casi siempre es RAG, no fine-tuning.
La regla general: usa fine-tuning para cambiar la forma, no para agregar hechos. Enséñale al modelo cómo responder, y deja que la recuperación de información se encargue de con qué responder.
¿Prompt, RAG o fine-tuning?
La mayoría de las veces no empiezas aquí. Las tres técnicas forman una escalera, empezando por lo más barato y rápido de cambiar:
- Prompting. Prueba esto siempre primero. Es instantáneo de iterar, no cuesta nada extra, y un prompt claro con un par de ejemplos resuelve más de lo que la gente espera. Si no has logrado que el prompt funcione, no estás listo para hacer fine-tuning.
- RAG. Recurre a esto cuando la brecha es de conocimiento: el modelo necesita hechos que no tiene, o que cambian con el tiempo. RAG los provee en el momento de la pregunta sin tocar el modelo.
- Fine-tuning. Recurre a esto cuando la brecha es de comportamiento en lugar de conocimiento y el prompting no logra hacerlo suficientemente consistente, o cuando tus prompts han crecido tanto que incorporar las instrucciones en el modelo resulta más barato y rápido a escala.
No son excluyentes, y los sistemas más sólidos las combinan: haz fine-tuning de un modelo para tu formato y tono, y luego usa RAG para alimentarlo con hechos actuales en tiempo de ejecución. Comportamiento del entrenamiento, conocimiento de la recuperación.
Entonces, una prueba rápida antes de hacer fine-tuning. ¿Puedes lograrlo con un mejor prompt? Entonces haz eso. ¿La brecha es conocimiento faltante? Entonces es RAG.
Sube la escalera; el fine-tuning es el último escalón, no el primero. Solo cuando el prompt ya está bien hecho, los hechos ya están disponibles, y el modelo aún no se comporta de forma lo bastante consistente, el fine-tuning se convierte en la herramienta que corresponde.
En la práctica
Los datos de fine-tuning no tienen nada de exótico. Cada ejemplo es una conversación corta con la forma exacta que envías en tiempo de ejecución, terminando con la respuesta que hubieras querido que el modelo dé:
# Aquí se muestran solo unos cuantos; un conjunto de datos real tiene cientos o miles de ejemplos,
# cubriendo todo el rango de entradas que esperas en tiempo de ejecución.
training_examples = [
    {"messages": [
        {"role": "system", "content": "Classify the ticket's urgency as low, medium, or high."},
        {"role": "user", "content": "I was charged twice this week and need it fixed today."},
        {"role": "assistant", "content": "high"},
    ]},
    {"messages": [
        {"role": "system", "content": "Classify the ticket's urgency as low, medium, or high."},
        {"role": "user", "content": "Is there a dark mode setting anywhere?"},
        {"role": "assistant", "content": "low"},
    ]},
    # ...
]
Guardas esto en un archivo, inicias un trabajo de entrenamiento con el proveedor, y esperas a que termine. Lo que obtienes de vuelta es un nuevo id de modelo, al que luego llamas exactamente igual que a cualquier otro modelo:
# El modelo con fine-tuning es simplemente otro id; todo lo demás no cambia.
response = client.chat.completions.create(
    model="your-org/urgency-classifier-v1",
    messages=[
        {"role": "system", "content": "Classify the ticket's urgency as low, medium, or high."},
        {"role": "user", "content": "The export button does nothing when I click it."},
    ],
)
# response.choices[0].message.content -> "low"  (solo la etiqueta, el comportamiento que entrenaste)
La ganancia es que ahora el comportamiento vive dentro del modelo. Las instrucciones pueden ser más cortas, el formato se mantiene a lo largo de miles de llamadas, y no tuviste que hacer crecer el prompt para lograrlo. El costo es todo lo que lo rodea: necesitas un conjunto de datos de calidad, una corrida de entrenamiento, y un trabajo nuevo cada vez que quieras cambiar lo que aprendió, que es exactamente la razón por la que esto está en la base de la escalera. Sube ejemplos, obtén un id de modelo, llámalo como a cualquier otro.
Esa es la última de las formas de moldear lo que un modelo sabe y cómo responde, todas las cuales lo dejan prediciendo texto sobre un escenario que tú preparaste. Los próximos capítulos le dan la capacidad de actuar: en Uso de herramientas el modelo llama a tus propias funciones, y luego las ejecuta en un ciclo como agente.