

 The AI Engineer Path
Cómo funcionan los LLM

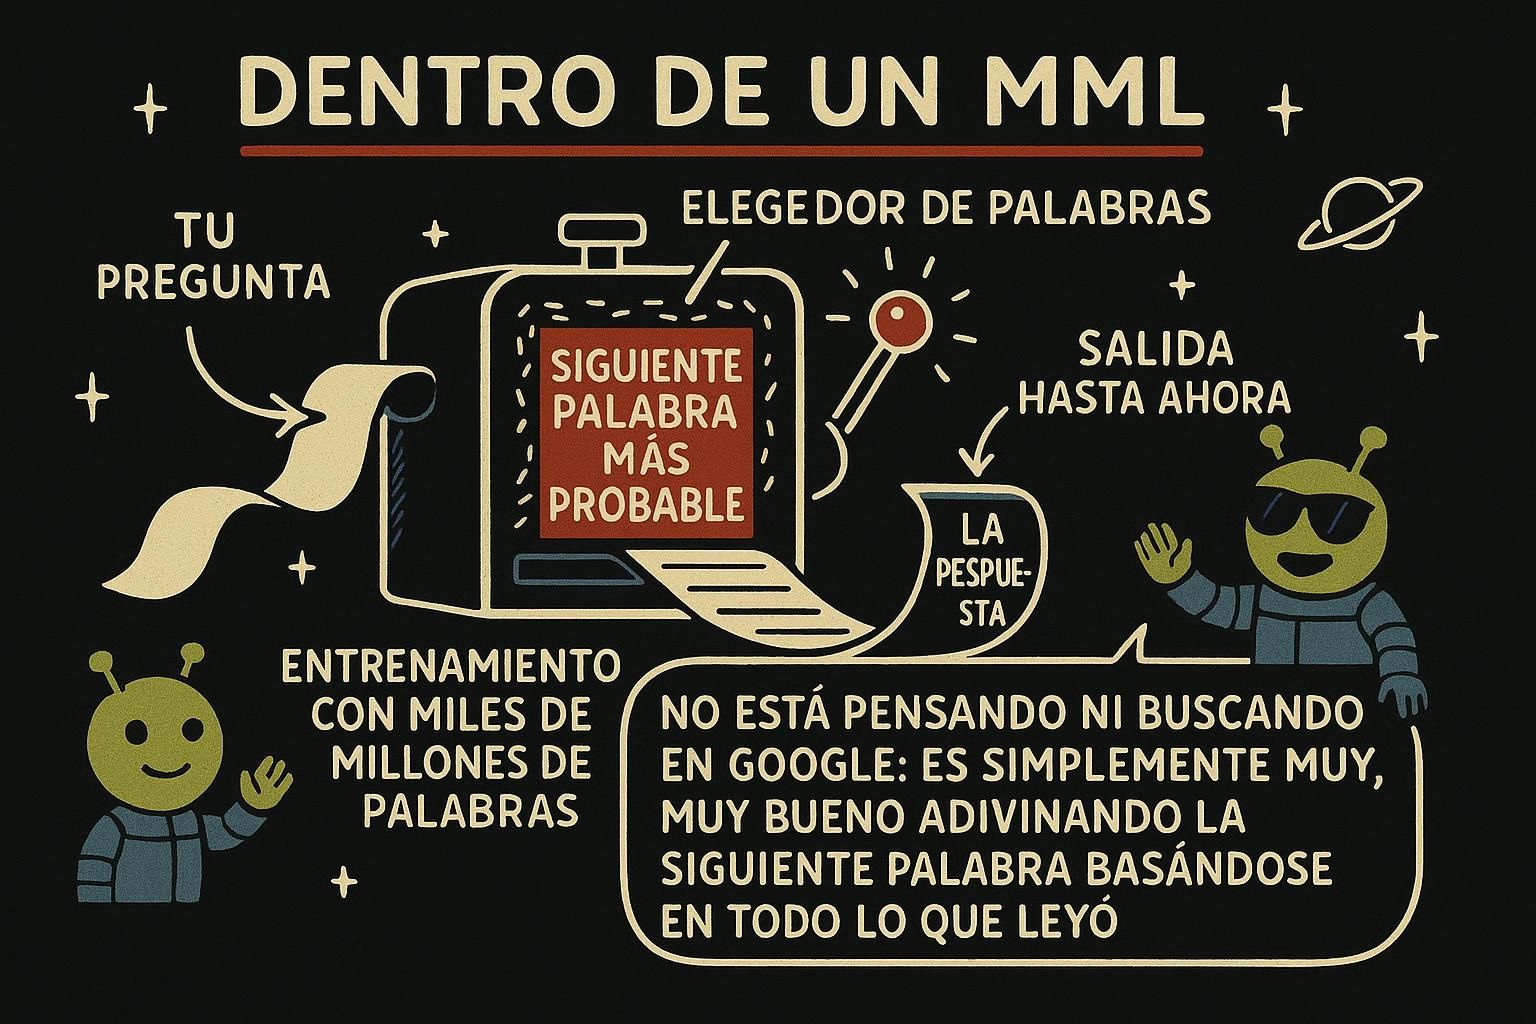
Primero, el nombre. LLM es la sigla de large language model (modelo de lenguaje grande): el tipo de IA que hay detrás de herramientas como ChatGPT, esa a la que le envías un prompt y de la que recibes texto como respuesta. Este capítulo es la imagen de trabajo de lo que realmente es un LLM.
Escribes una pregunta y, unos segundos después, aparece una respuesta fluida y segura de sí misma. Da la impresión de que el modelo te entendió y buscó la respuesta. Esa impresión es útil, y también es errónea de maneras que importan, y en esa brecha es donde nacen la mayoría de los errores de quienes recién empiezan.
Este es el capítulo que te va a servir durante el resto de tu carrera trabajando con estas herramientas. No necesitas conocer las matemáticas detrás del entrenamiento de un modelo para construir con uno. Sí necesitas una imagen clara de lo que en realidad ocurre cuando responde, porque esa imagen explica todo lo demás: por qué funciona el prompting, por qué la misma pregunta da respuestas distintas, por qué los modelos inventan datos, por qué cuestan lo que cuestan y por qué algunas funciones son difíciles aunque parezcan triviales. Todo lo que viene después en este manual es una consecuencia de las ideas que ves aquí.
Qué es realmente un modelo
Si le quitas la interfaz de chat, un modelo de lenguaje grande es una sola cosa: una función matemática enorme, un conjunto fijo de miles de millones de números llamados parámetros (también los vas a escuchar llamar pesos, o weights). Eso es todo el modelo. No es una base de datos, ni un motor de búsqueda, ni una persona pequeña dentro de una caja. Es una pila muy grande de números que recibe texto y produce texto.
Esos números no salieron de un programador que los escribió a mano. Se fijaron durante el entrenamiento. El proveedor le dio de comer al modelo una cantidad descomunal de texto —libros, código, artículos, páginas web— y repitió un ejercicio simple miles de millones de veces: ocultar la siguiente palabra, pedirle al modelo que la prediga y ajustar sus números un poco cada vez que se equivoca. Repite eso a una escala enorme y los números se van acomodando poco a poco en valores que son buenos para predecir texto. Eso es el entrenamiento: afinar miles de millones de perillas hasta que la predicción mejora.
De esto se desprenden dos cosas, y explican bastante del comportamiento que vas a encontrar más adelante. Primero, el entrenamiento ocurre una sola vez, con anticipación, y es enormemente costoso. Para cuando tú llamas al modelo, los números ya están congelados. El modelo no aprende de tu conversación. Nada de lo que dices cambia sus parámetros. Da la sensación de que recuerda y se adapta, pero eso lo hace el software que lo rodea, no el modelo en sí, un punto que retomamos con fuerza en la sección de la ventana de contexto.
Segundo, no hay ninguna tabla de datos dentro del modelo. El "conocimiento" existe como patrones incrustados en esos números, de la misma forma en que un panadero que ha hecho diez mil panes tiene la técnica en las manos sin necesidad de leer una receta. El modelo aprendió la forma de un texto correcto y coherente. Por eso puede ser fluido y estar equivocado en la misma frase: está reproduciendo la forma de una buena respuesta, no leyendo un dato guardado en un estante.

Predecir el siguiente token
Con esa pila de números ya lista, el modelo hace exactamente un trabajo: predecir el siguiente fragmento de texto, una y otra vez.
Veamos el ciclo en cámara lenta. Le das algo de texto. Él pasa ese texto por todos esos parámetros y produce una probabilidad para cada fragmento posible que podría seguir, decenas de miles de opciones a la vez. Después de "La capital de Francia es", el fragmento "París" podría recibir un puntaje de 97%, "una" un 1%, y todo lo demás casi nada.
Luego el modelo elige un fragmento, lo agrega al texto y vuelve a ejecutar todo el proceso para elegir el siguiente. Repite esto hasta que la respuesta está completa.
Ese es todo el motor. Una respuesta que tú lees como un pensamiento único se construyó fragmento por fragmento, cada uno elegido a partir de un nuevo ranking de probabilidades, sin ningún plan sobre hacia dónde va la frase más allá de "qué es probable a continuación". Cada capacidad que vas a usar —chat, código, traducción, uso de herramientas, razonamiento— es este mismo ciclo funcionando por debajo.
El teclado del celular que te sugiere la siguiente palabra es la misma idea en miniatura. La diferencia son los miles de millones de parámetros detrás de la sugerencia. Entrenado con suficiente texto, "cuál es el fragmento siguiente más probable" resulta ser suficientemente bueno para escribir código funcional y explicaciones claras. Pero el movimiento de fondo nunca cambia: es predicción, no comprensión, y no es una búsqueda de una respuesta guardada.
La perilla de la aleatoriedad
Si el modelo siempre tomara el único fragmento con el puntaje más alto, te daría la misma respuesta al mismo prompt cada vez, y esa respuesta suele ser plana y repetitiva. Por eso, la mayor parte del tiempo la elección tiene un poco de aleatoriedad: casi siempre toma un fragmento de alta probabilidad, pero no siempre el que está en el primer lugar. Por eso puedes hacer exactamente la misma pregunta dos veces y obtener dos respuestas distintas. Eso es el sistema funcionando como fue diseñado, no una falla.
Controlas cuánta aleatoriedad hay mediante una configuración llamada temperatura, que ajustas cuando llamas al modelo, tema que verás en el capítulo sobre llamar modelos desde código. Conviene tener ya la intuición desde ahora. A una temperatura baja, el modelo se apega a sus elecciones más probables: enfocado, consistente, predecible, que es lo que quieres para extraer un número de una factura o clasificar texto en categorías. A una temperatura más alta, los fragmentos de menor probabilidad se eligen con más frecuencia: más variado y creativo, y con más probabilidad de irse por un camino equivocado. La lluvia de ideas y la escritura creativa quieren el extremo alto; cualquier tarea con una respuesta correcta quiere el extremo bajo.
Entonces una sola perilla desliza al modelo entre "cuidadoso y repetible" y "sorprendente e inventivo". Es el mismo ciclo de predicción en ambos casos; la temperatura solo cambia cuán audazmente el modelo se aleja de su elección más segura.
Tokens
Los "fragmentos" que predice un modelo tienen un nombre: tokens. Un token es un pedazo de texto, muchas veces una palabra completa, a veces solo una parte de ella. Las palabras comunes suelen ser un solo token, mientras que las palabras más largas o poco frecuentes se dividen en varios.
"tokenización"  ->  "token" + "ización"
"increíble"     ->  "in" + "creíble"
"gato"          ->  "gato"
¿Por qué picar el texto en pedazos tan raros en lugar de usar palabras completas o letras sueltas? Es una decisión de compromiso. Las letras sueltas harían que cada secuencia fuera enormemente larga, y la longitud es justo lo que el modelo tiene que procesar. Las palabras completas necesitarían un vocabulario de millones de entradas y de todos modos se romperían la primera vez que alguien invente una palabra o cometa un error de tipeo. Los tokens son el camino intermedio: un vocabulario fijo de unas pocas decenas de miles de pedazos comunes que se pueden ensamblar para formar cualquier cosa, incluyendo palabras que el modelo nunca ha visto.
Acá está la consecuencia interna que sorprende a la gente. El modelo nunca ve letras. Ve tokens, que para él en realidad son números de identificación de esos fragmentos. Por eso tareas que a nosotros nos resultan sencillas pueden ser difíciles para él: contar las letras de una palabra, invertir una cadena de texto, notar que "fresa" tiene dos "r".
No es que sea torpe. Simplemente no percibe los caracteres individuales en absoluto, de la misma forma en que tú no puedes saborear los granos de harina por separado en un pan ya horneado. Cuando un modelo se equivoca en una tarea de ortografía o de conteo de caracteres, esta es la razón, y la solución suele ser hacer esa parte con código normal en lugar de pedírsela al modelo.
Los tokens también son la unidad de dos cosas que te van a importar constantemente:
- Dinero: los proveedores cobran por token, tanto los tokens que envías como los que el modelo te devuelve, así que un documento largo de entrada y una respuesta larga de salida cuestan más los dos. Una medida aproximada para el inglés es de unos cuatro caracteres por token, o 100 tokens cada 75 palabras; el código y otros idiomas suelen dividirse en más tokens, lo cual es parte de por qué pueden costar más. Vas a ver esto de forma directa cuando empieces a llamar modelos desde código.
- Límites: hay un tope de cuántos tokens puede manejar el modelo a la vez, que es el tema de la siguiente sección.
La ventana de contexto
La ventana de contexto es cuánto texto puede recibir el modelo de una sola vez, medido en tokens. Imagínala como el tamaño del escritorio del modelo. Todo lo que interviene en una sola solicitud tiene que entrar en ese escritorio al mismo tiempo: tus instrucciones, la conversación hasta el momento, cualquier documento que hayas pegado y la respuesta que el modelo está escribiendo.
¿Por qué existe siquiera un límite? Viene de cómo funciona la predicción. Para elegir el siguiente token, el modelo compara cómo se relaciona cada token de la entrada con todos los demás, de modo que puede darse cuenta de que "eso" se refiere al gato mencionado tres frases atrás. Esa comparación de todos-contra-todos es lo que le permite al modelo seguir el significado a lo largo de un pasaje, y también es lo que hace que las entradas largas sean costosas de procesar. El proveedor fija un tope, la ventana de contexto, para mantener manejable cada solicitud.
Cuando el escritorio se llena, algo tiene que salirse. Si una conversación se extiende lo suficiente como para desbordar la ventana, las partes más antiguas se caen y el modelo ya no puede verlas. Por eso un chat largo parece "olvidar" lo que dijiste al principio. No lo olvidó en ningún sentido humano; esos tokens simplemente ya no están sobre el escritorio. También ayuda saber que los modelos tienden a prestar más atención al principio y al final de lo que hay en el escritorio, y pueden perder de vista cosas enterradas en el medio, así que dónde ubicas el texto importante importa cuando llenas la ventana.
Ahora viene el punto que atrapa a casi todo el que recién empieza, y pesa más que todo lo demás. El modelo no tiene memoria entre solicitudes separadas. Recuerda que sus números están congelados. Cada llamada empieza con un escritorio en blanco. El modelo no recuerda tu última pregunta, tu nombre, ni nada de hace un minuto.
Una aplicación de chat se siente como una sola conversación fluida solo porque la aplicación, en silencio, vuelve a enviar todo el historial con cada mensaje nuevo. La continuidad es algo que construye el software alrededor del modelo, no algo que el modelo tenga por sí mismo.
Ese único hecho da forma a cómo construyes todo lo demás a partir de aquí. Si quieres que el modelo sepa algo, tienes que ponerlo sobre el escritorio en esa solicitud: la conversación hasta el momento, los datos del usuario, los documentos relevantes, todo, cada vez. Buena parte de este manual trata en realidad de hacer bien esa única cosa: poner el texto correcto sobre el escritorio.
Lo que el modelo no sabe
Todo el conocimiento de un modelo se incrustó mientras se entrenaba, así que solo sabe lo que estaba en esos datos de entrenamiento, y esos datos se recopilaron hasta cierto punto de corte en el pasado. De esto se desprenden dos límites directos.
Primero, no sabe nada de lo que ocurrió después de su corte. Pregúntale sobre las noticias de la semana pasada o sobre una biblioteca de código que salió este mes y no tiene ninguna idea real, aunque tal vez de todos modos produzca con gusto una respuesta que suena plausible. Segundo, nunca supo nada privado. Los documentos internos de tu empresa, el historial de compras de un usuario, el contenido de tu base de datos: nada de eso estaba en el texto público con el que entrenó, así que no puede saberlo, sin importar con qué amabilidad se lo pidas.
Hay un límite más silencioso todavía. El modelo generalmente no puede decirte de dónde viene algo que "sabe", porque el conocimiento está mezclado en su interior en lugar de estar archivado como datos separados con su fuente identificada. Puede escribirte una cita, pero está prediciendo cómo se debería ver una cita, no buscando una real.
Esta es la razón detrás de una técnica que vas a ver más adelante llamada retrieval, o RAG. Si quieres que un modelo responda sobre eventos recientes o sobre tus propios datos privados, no lo vuelves a entrenar. Tú mismo buscas el texto relevante y lo pones sobre el escritorio en el momento de la solicitud, para que el modelo tenga los datos frente a él en lugar de adivinar. Un modelo es mucho más un razonador sobre el texto que le entregas que un pozo confiable de datos específicos.
Por qué los modelos inventan cosas
A veces un modelo afirma algo falso con total seguridad: una cita que nadie dijo, una función que no existe, la referencia a un estudio que nunca se escribió. Esto se llama alucinación, y después de las últimas secciones debería sentirse casi inevitable en lugar de misterioso.
La razón es que el modelo no tiene ninguna noción interna de "verdadero" versus "falso". Solo tiene "texto probable" versus "texto improbable". La mayoría de las veces esas dos cosas coinciden, porque en el texto del que aprendió, las afirmaciones verdaderas son mucho más comunes que las falsas, así que la continuación probable suele ser también la correcta.
Pero cuando el modelo se topa con un vacío —algo con lo que nunca se entrenó, o tus datos privados que nunca pudo haber visto— no se detiene a señalar el vacío. No puede saber con confiabilidad qué es lo que no sabe. Hace lo único que siempre hace: producir la continuación que suena más probable.
Una respuesta segura, bien construida y equivocada muchas veces es exactamente lo que suena más probable. La misma maquinaria que lo hace fluido lo hace fluido incluso cuando se equivoca.
Esta es la parte con la que hay que quedarse: la alucinación no es un fallo que puedas eliminar por completo con el prompt. Puedes reducirla, y los capítulos siguientes muestran cómo. Decirle al modelo que puede responder "no lo sé" ayuda un poco. Pedirle que responda solo a partir del texto que tú proporcionas ayuda mucho más, porque ahora no hay ningún vacío que llenar con conocimiento congelado del entrenamiento. Pero la tendencia viene de lo que el modelo fundamentalmente es, una máquina de probabilidades sin ningún verificador de datos interno, así que las soluciones duraderas son estructurales: entrégale los datos con los que trabajar en lugar de esperar que estuvieran en su entrenamiento, y verifica las respuestas que realmente importan en lugar de confiar en ellas.
Llévate una regla de este capítulo por encima de todas las demás: la confianza de un modelo no te dice nada sobre si está en lo correcto. La fluidez y la corrección se producen con el mismo proceso y se separan todo el tiempo. Construye asumiendo que cualquier respuesta individual podría estar equivocada, porque cualquier respuesta individual podría estarlo.
Uniendo todo
Todo lo de este capítulo es una sola idea vista desde ángulos distintos. Un modelo es una pila congelada de números que predice el siguiente token, y casi todo comportamiento con el que vas a lidiar se desprende de eso:
- Predice un token a la vez a partir de un ranking de probabilidades, así que improvisa en lugar de recordar, y un toque de aleatoriedad (la temperatura) hace que las respuestas varíen.
- Los tokens son los fragmentos con los que trabaja: la unidad de tu factura, la unidad de tu límite de tamaño, y la razón por la que no puede contar letras con confiabilidad.
- La ventana de contexto es el escritorio de una sola solicitud, compartido por todo, y el modelo no recuerda nada entre solicitudes, así que la continuidad es tu trabajo.
- Su conocimiento está congelado en un corte de entrenamiento y nunca incluyó tus datos privados, por lo que buscas los datos y los pones en el prompt.
- La alucinación es el precio de un sistema que predice texto probable sin ninguna noción de verdad, y se reduce fundamentando y verificando, nunca solo con redacción ingeniosa.
Junta todo esto y una cantidad sorprendente de la ingeniería de IA resulta ser una sola tarea con distintos disfraces: poner el texto correcto sobre el escritorio, en la forma correcta, en el momento correcto, y nunca confiar ciegamente en la salida. El próximo capítulo, Modelos abiertos y cerrados, examina qué tipos de modelos existen y cómo consigues uno, y luego prompting es donde empiezas a dirigir toda esta predicción hacia lo que realmente quieres.