Skip to content
This page has been auto-translated and may contain errors.View in English

Salida estructurada ​

docs.scrimba.com

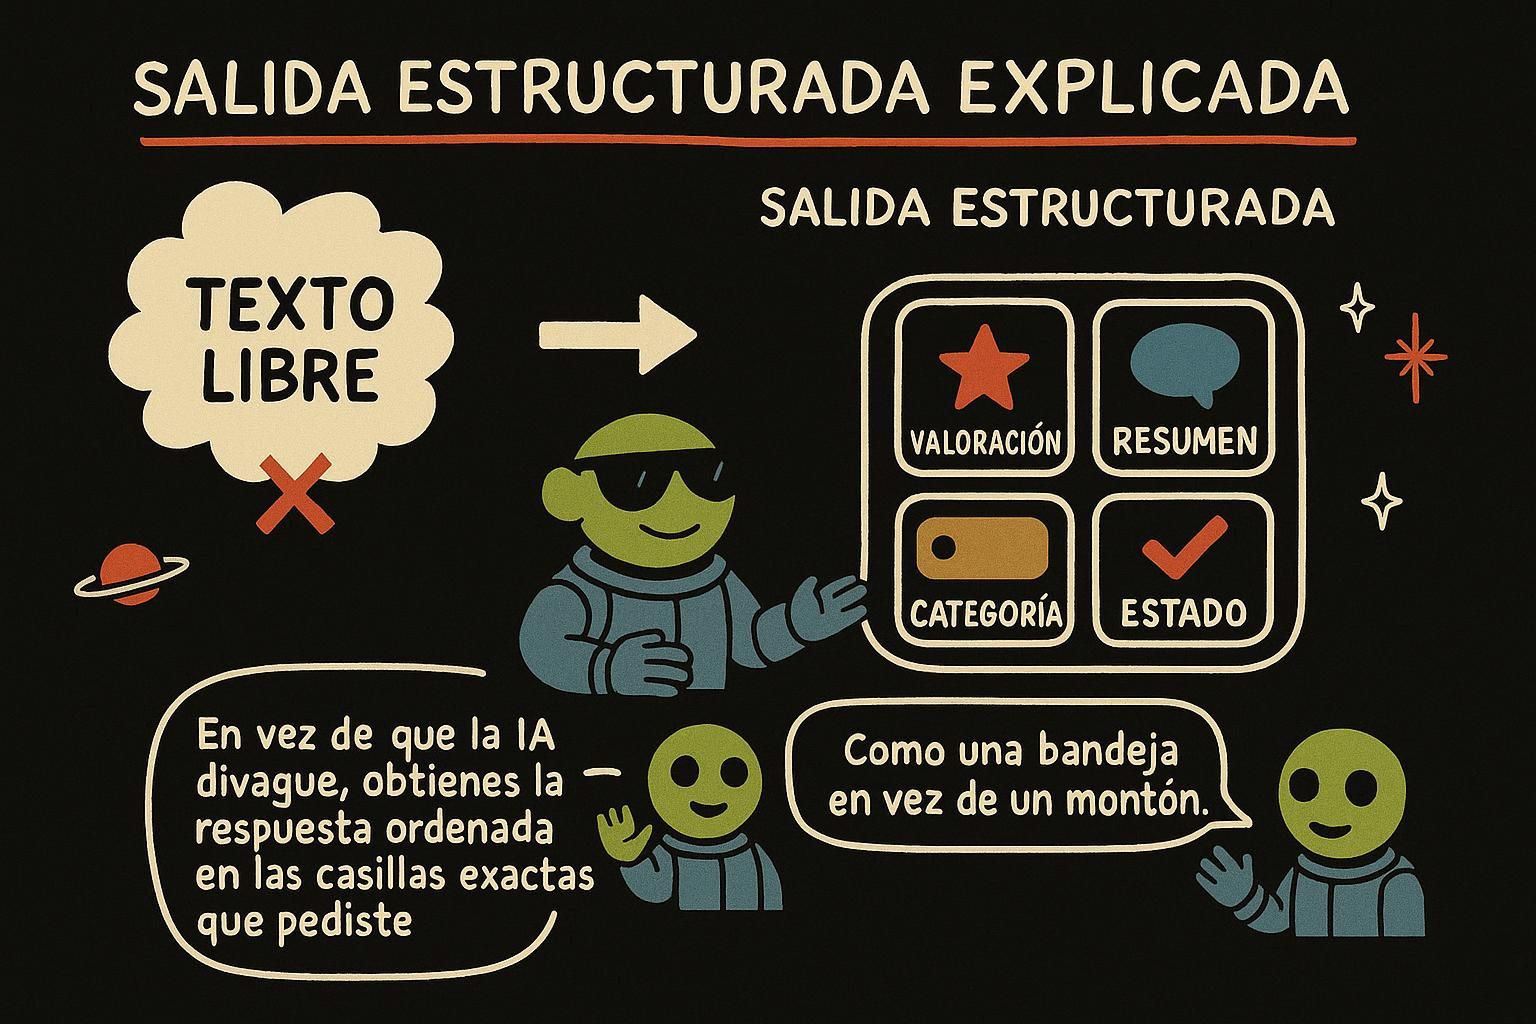
Primero, veamos en qué consiste el problema. La salida estructurada es la práctica de lograr que un modelo devuelva datos que tu código pueda leer directamente: un campo sobre el que puedas tomar decisiones en lugar de un párrafo que tengas que analizar a mano. Este capítulo trata de cómo lograr que eso sea confiable.

Hasta ahora el modelo te entrega texto, lo cual está bien cuando una persona lo lee. Pero el software no puede hacer mucho con un párrafo. Para actuar sobre la respuesta de un modelo desde tu código, necesitas que esté en forma de datos: un campo que puedas leer, un valor sobre el que puedas decidir, un registro que puedas guardar.

El cambio es pequeño, pero transforma todo lo que viene después. En cuanto el modelo devuelve { "sentiment": "negative" } en vez de una oración sobre lo insatisfecho que parece estar el cliente, tu código puede enrutar el ticket, actualizar un panel o enviar una alerta. Lo interesante es cómo lograr que el modelo produzca datos limpios cuando lo único que hace es predecir texto, y la respuesta revela una palanca que quizás no sabías que tenías.

El modelo devuelve texto. Tu código necesita datos: un campo para leer, un valor sobre el que decidir, un registro para almacenar. Este capítulo es el puente entre esas dos cosas, y la clave está en dejar de esperar que el modelo formatee bien las cosas y empezar a restringir lo que puede producir.

Aquí hay una palanca real, no un truco de prompting. El mismo ciclo de muestreo que vimos en cómo funcionan los LLM se puede dirigir para forzar que la salida tenga la forma que quieres, lo que convierte a un generador de texto impreciso en un componente en el que el resto de tu sistema puede confiar.

Un modelo que devuelve prosa es un componente que no puedes componer con otros. En el momento en que su salida alimenta a otro sistema, necesitas datos con una forma conocida, y necesitas que los modos de falla al obtener esos datos sean modos que puedas ver y manejar.

Este capítulo trata sobre restringir la generación a un esquema, y sobre qué te cuesta eso en latencia, qué no te garantiza (valores correctos), y cómo falla en los casos límite. El mecanismo subyacente es el mismo que impulsa el uso de herramientas: una llamada a una herramienta es salida estructurada donde la firma de una función hace las veces de esquema.

Pide JSON ​

El primer instinto es pedirlo en el prompt: "responde como JSON", el formato de texto plano que usa el software para intercambiar datos, escrito como campos y valores dentro de llaves. Pruébalo y en su mayoría funciona, y ahí está la trampa. El modelo sigue sin hacer nada más que predecir texto probable, y a veces el texto probable es un bloque de código, o un amigable "¡Claro, aquí tienes!" antes de los datos, o un comentario al final. Cualquiera de esos casos rompe el código que lee el JSON. Pedirlo con buenas maneras inclina la predicción hacia el JSON; no la obliga.

Por eso los proveedores te dan una palanca real. Activar el modo JSON con response_format hace más que pedirlo: restringe al modelo para que la sintaxis vuelva como JSON válido.

python
import json

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": 'Extract the city and the temperature. Reply as JSON: { "city": string, "tempC": number }.'},
        {"role": "user", "content": "It's about 18 degrees in Oslo right now."},
    ],
    response_format={"type": "json_object"},  # restringe la salida a sintaxis JSON válida
)

data = json.loads(response.choices[0].message.content)
print(data["city"], data["tempC"])  # "Oslo" 18

response_format={"type": "json_object"} hace que la salida sea sintácticamente un JSON válido, así que json.loads no fallará por prosa suelta. Aun así debes describir en el prompt los campos que quieres, porque el modo JSON garantiza JSON válido, no los campos específicos que tenías en mente. Descarta "no es JSON en absoluto", no "JSON con la forma equivocada". Hay una cosa que todavía no puede garantizar: si la respuesta se corta a mitad de camino, puedes recibir medio objeto JSON, así que es sintaxis confiable, no una garantía absoluta en todos los casos.

JunoPide JSON Pedir JSON solo en el prompt es poco confiable, porque el modelo únicamente predice texto probable y puede envolverlo en bloques de código o charla que rompen el análisis. Configurar response_format en modo JSON restringe la sintaxis para que vuelva como JSON válido. No garantiza que los campos coincidan con lo que pediste, y una respuesta cortada a medio camino puede llegar como medio objeto, así que describe la forma en el prompt y verifica lo que llega.

El reflejo es escribir "responde como JSON" en el prompt, donde JSON es el formato de datos con el que el software intercambia campos y valores. En su mayoría funciona, y eso es justamente el problema: "en su mayoría" no es un contrato. El modelo predice texto probable, y a veces ese texto probable incluye un bloque de código, un preámbulo tipo "¡Claro!" o una nota al final, todo lo cual rompe json.loads.

El modo JSON es la primera palanca real. Configurar response_format con un tipo de objeto JSON restringe la generación para que la sintaxis sea JSON válido, no prosa que se parece a JSON.

python
import json

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": 'Extract the city and the temperature. Reply as JSON: { "city": string, "tempC": number }.'},
        {"role": "user", "content": "It's about 18 degrees in Oslo right now."},
    ],
    response_format={"type": "json_object"},  # restringe la salida a sintaxis JSON válida
)

data = json.loads(response.choices[0].message.content)
print(data["city"], data["tempC"])  # "Oslo" 18

La forma de response_format que se ve aquí es la de OpenAI; otros proveedores exponen la misma idea con su propio campo, así que traslada el concepto, no la clave literal. El modo JSON restringe la sintaxis, nunca la forma de los campos. Tú describes los campos en el prompt, y el modelo es libre de renombrarlos, omitirlos o anidarlos de otra manera mientras siga emitiendo JSON válido.

Hay una grieta más: el modo JSON solo garantiza JSON bien formado si la respuesta termina. Si llegas al límite de max_tokens a mitad de un objeto, obtienes una salida truncada e imposible de parsear, así que el análisis sigue necesitando una protección.

JunoPide JSON El modo JSON restringe la sintaxis para que el modelo deje de envolver los datos en bloques de código y charla, pero nunca fija los campos, así que el modelo puede seguir renombrándolos u omitiéndolos. La clave response_format es la forma de OpenAI; otros proveedores la escriben distinto. Y la garantía solo vale para una respuesta completa, así que una respuesta truncada por max_tokens llega imposible de parsear. Protege el análisis de todos modos.

"Responde como JSON" en el prompt es una sugerencia, y las sugerencias fallan bajo carga: un bloque de código aquí, un preámbulo allá, un comentario al final cuando el modelo se pone conversador, cada uno una excepción de json.loads en producción. El modo JSON (aquí response_format={"type": "json_object"}) reemplaza la sugerencia por una restricción sobre la sintaxis generada, de modo que los bytes que regresan se puedan parsear como JSON.

python
import json

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": 'Extract the city and the temperature. Reply as JSON: { "city": string, "tempC": number }.'},
        {"role": "user", "content": "It's about 18 degrees in Oslo right now."},
    ],
    response_format={"type": "json_object"},  # restringe la salida a sintaxis JSON válida
)

data = json.loads(response.choices[0].message.content)
print(data["city"], data["tempC"])  # "Oslo" 18

Hay que ser preciso sobre qué restringe esto. El modo JSON fija la sintaxis, no el esquema, y solo en una respuesta completa. El modelo sigue eligiendo los nombres de los campos, puede omitir un campo requerido y puede anidar como quiera.

La garantía depende de que la generación termine: si el modelo choca con max_tokens a mitad de un objeto, obtienes una cadena truncada que no es JSON válido, lo cual significa que el único modo de falla que el modo JSON no elimina es precisamente el que tu lógica de reintentos más necesita manejar. La clave response_format que se muestra es de OpenAI; el equivalente en otros proveedores tiene otro nombre, así que trata el concepto como portable y el campo literal como no portable. Para garantías de forma necesitas un esquema, que es el tema de la siguiente sección.

JunoPide JSON El modo JSON restringe la sintaxis en una respuesta terminada, nada más: el modelo sigue nombrando, omitiendo y anidando campos a su gusto, y una generación interrumpida por max_tokens te entrega una salida truncada e imposible de parsear. Ese caso de truncamiento es el que tu manejo de errores tiene que cubrir, porque el modo no lo hará. La forma de response_format es de OpenAI, así que traslada la idea, no la clave. Para la forma, necesitas un esquema.

Fija la forma con un esquema ​

El modo JSON mantiene la sintaxis válida, pero el modelo todavía podría renombrar un campo, omitirlo o anidar las cosas de otra manera. Para eliminar ese margen, dale un esquema: una descripción exacta de los campos y tipos que debe tener la salida, un formulario que el modelo está obligado a completar. Con strict: true, la salida queda garantizada para coincidir con ese formulario.

python
import json

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": "Extract the contact details from the message."},
        {"role": "user", "content": "Hi, I'm Mara Lin, reach me at [email protected]."},
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "contact",
            "strict": True,  # aplica el esquema de forma exacta
            "schema": {
                "type": "object",
                "properties": {
                    "name": {"type": "string"},
                    "email": {"type": "string"},
                },
                "required": ["name", "email"],
                "additionalProperties": False,
            },
        },
    },
)

contact = json.loads(response.choices[0].message.content)
# {"name": "Mara Lin", "email": "[email protected]"}

¿Cómo puede un esquema ser una garantía firme si el modelo solo predice tokens? Porque el proveedor restringe qué tokens puede predecir. En cada paso el modelo sigue calificando a todos los tokens posibles, pero el sistema elimina los que romperían tu esquema, y el modelo elige entre lo que queda.

Si el esquema dice que el siguiente campo debe ser email, los tokens que abrirían cualquier otro campo se quitan de la mesa antes de que el modelo elija. Se eliminan los tokens que no cumplen con la forma, así que el modelo no puede desviarse de ella.

Hay un efecto más sutil que vale la pena conocer. Los nombres de los campos que elijas pasan a ser parte de lo que el modelo lee al predecir el valor, así que un nombre claro guía hacia una mejor respuesta. Si le pides que rellene tempC, el modelo se inclina hacia un número en Celsius; si le pides que rellene value, tiene mucho menos con qué guiarse. Nombrar los campos con claridad es en parte instrucción, en parte esquema.

JunoFija la forma con un esquema Un esquema es el formulario que el modelo tiene que completar, y con strict: true obtiene exactamente los campos y tipos indicados, porque el sistema elimina cualquier token que rompería la forma antes de que el modelo elija. Eso es una restricción real, no una petición amable. Nombra tus campos con claridad también, ya que el nombre del campo es contexto que el modelo lee al predecir el valor. Me tomó un tiempo confiar en que un nombre como tempC realmente influye.

El modo JSON fija la sintaxis pero deja al modelo libre de renombrar, omitir o reanidar campos. Un esquema cierra esa brecha: una descripción exacta de campos y tipos, y con strict: true la salida queda garantizada para coincidir con ella.

python
import json

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": "Extract the contact details from the message."},
        {"role": "user", "content": "Hi, I'm Mara Lin, reach me at [email protected]."},
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "contact",
            "strict": True,  # aplica el esquema de forma exacta
            "schema": {
                "type": "object",
                "properties": {
                    "name": {"type": "string"},
                    "email": {"type": "string"},
                },
                "required": ["name", "email"],
                "additionalProperties": False,
            },
        },
    },
)

contact = json.loads(response.choices[0].message.content)
# {"name": "Mara Lin", "email": "[email protected]"}

El mecanismo se llama decodificación restringida: la poda de tokens aplicada al paso de muestreo. En cada posición el modelo produce su calificación habitual sobre todos los tokens, luego el sistema enmascara cualquier token que haría que la salida deje de coincidir con el esquema, y el modelo muestrea entre los que sobreviven. Si la gramática dice que el siguiente token debe abrir el campo email, los tokens que abrirían cualquier otra cosa se anulan antes del sorteo. El modelo no puede desviarse de la forma porque las jugadas que no calzan se eliminan del tablero, no se desalientan solo en el prompt.

Dos recursos prácticos. Los nombres de los campos son instrucción, así que nómbralos según el valor que quieres. tempC orienta al modelo hacia Celsius mientras que value lo deja adivinando, y una descripción en el campo orienta aún más. Y la misma restricción impone un enum (una lista fija de valores permitidos) o un rango numérico, que es lo que hace confiable la clasificación: en la posición de la etiqueta, solo tus etiquetas listadas sobreviven a la máscara, así que el modelo no puede inventar una categoría que no esté en la lista.

JunoFija la forma con un esquema Con strict: true, la decodificación restringida elimina cada token que rompería el esquema antes de que el modelo muestree, así que la forma queda impuesta, no solicitada. Aprovéchalo: los nombres y descripciones de los campos son instrucciones, así que nombra tempC y no value, y el modelo lo llena mejor. La misma máscara impone un enum, por eso la clasificación se sostiene: el modelo no puede inventar una etiqueta que no esté en tu lista.

El modo JSON te da bytes parseables; un esquema te da una forma conocida. Con strict: true la salida queda garantizada para coincidir con el conjunto de campos y tipos que declaras, y esa es la diferencia entre datos a los que puedes acceder directamente por índice y datos que tienes que sondear a la defensiva.

python
import json

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": "Extract the contact details from the message."},
        {"role": "user", "content": "Hi, I'm Mara Lin, reach me at [email protected]."},
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "contact",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "name": {"type": "string"},
                    "email": {"type": "string"},
                },
                "required": ["name", "email"],
                "additionalProperties": False,
            },
        },
    },
)

contact = json.loads(response.choices[0].message.content)

El mecanismo es la decodificación restringida, y conviene entenderlo desde la base porque sus costos no son gratuitos. El modelo emite una probabilidad para cada token de su vocabulario en cada paso. La decodificación restringida compila tu esquema en una gramática (un conjunto de reglas sobre qué secuencias de tokens son legales), y luego en cada paso construye una máscara que pone en cero la probabilidad de todo token ilegal, así el muestreo solo puede caer en un token que mantenga válida la salida hasta ese momento. La forma queda impuesta por construcción, no por petición.

Esa compilación no es gratuita, y se refleja en latencia. La primera llamada contra un esquema nuevo paga un costo único por construir la gramática, así que la latencia de arranque en frío sobre un esquema recién creado es mayor que en estado estable. Mantén tus esquemas estables y reutilízalos en lugar de generarlos por cada solicitud, o pagarás esa compilación una y otra vez.

additionalProperties: false y una lista required completa no son decoración: son lo que permite que el sistema rechace de plano campos extra o faltantes, y en los proveedores que admiten un rechazo dirigido por esquema, también son lo que le da al modelo una manera limpia de devolver un rechazo estructurado en lugar de un objeto malformado. Si los omites, amplías lo que cuenta como válido, justo lo contrario de por qué recurriste al modo estricto.

Algunas realidades de producción. El soporte del modo estricto es desigual: algunos proveedores imponen una gramática real, otros la aproximan o solo admiten un subconjunto de JSON Schema (sin pattern, con anidamiento limitado), así que prueba lo que tu proveedor realmente respeta en vez de asumir que sigue la especificación al pie de la letra. La salida parcial y en streaming es el caso incómodo: mientras los tokens se transmiten, tienes en tus manos un objeto sintácticamente incompleto, así que o bien esperas hasta completarlo antes de parsear, o usas un analizador incremental que tolere una estructura a medio construir. Y esto es el mismo mecanismo que el uso de herramientas: el esquema de argumentos de una función se restringe exactamente igual, así que todo lo aprendido aquí se traslada directamente a hacer confiables las llamadas a herramientas.

JunoFija la forma con un esquema La decodificación restringida compila tu esquema en una gramática y pone en cero cada token ilegal antes de muestrear, así que la forma queda impuesta por construcción. Esa compilación cuesta latencia en la primera llamada contra un esquema nuevo, así que reutiliza esquemas en vez de crear uno por solicitud. Mantén additionalProperties: false y una lista required completa, son lo que permite el rechazo y, en algunos proveedores, un rechazo estructurado limpio. El soporte estricto varía, el streaming te entrega medio objeto, y la misma máscara impulsa los argumentos de las llamadas a herramientas, así que lo que aprendes aquí rinde el doble.

Valida de todos modos ​

Un esquema restringe la forma, pero de todas maneras trata la salida como datos provenientes del mundo exterior. La forma puede ser válida mientras el contenido está mal: un correo extraído que en realidad tiene un error de tipeo, un número que el modelo adivinó, un campo dejado en blanco porque la entrada no lo contenía. Y la llamada puede fallar igual por motivos comunes, como cortarse por max_tokens y llegar como JSON truncado. Analiza a la defensiva: una forma válida no es un valor correcto.

python
import json

def parse_contact(raw):
    try:
        data = json.loads(raw)
        if not data.get("name") or not data.get("email"):
            return None  # presente pero vacío
        return data
    except json.JSONDecodeError:
        return None  # no es JSON válido (por ejemplo, una respuesta truncada)

contact = parse_contact(response.choices[0].message.content)
if not contact:
    pass  # maneja la falla: reintenta, vuelve a preguntar o muestra un error amigable

Esta es la lección de la alucinación con otro disfraz: que la forma esté bien no hace que los valores estén bien. Un esquema te garantiza obtener un campo name; no garantiza que el nombre sea correcto. Un try/except alrededor del análisis más una verificación de los valores es un seguro barato contra la respuesta que está bien formada y aun así está mal.

JunoValida de todos modos Un esquema garantiza la forma, nunca la veracidad de los valores, así que un registro válido puede seguir teniendo un valor equivocado o vacío, y una llamada puede llegar truncada. Envuelve el análisis en try/except y revisa los valores antes de confiar en ellos. Decide de antemano qué pasa cuando falla la validación, un reintento o un error amigable, para que no sea una carrera contra el tiempo después.

El modo estricto garantiza la forma, no el contenido. La salida puede coincidir con el esquema y aun así estar mal: un correo que parece plausible pero tiene un error de tipeo, un número inventado para llenar un campo obligatorio, una cadena vacía donde la entrada no tenía nada. Y el análisis puede fallar directamente cuando una respuesta se trunca por max_tokens. Así que validas, cada vez.

python
import json

def parse_contact(raw):
    try:
        data = json.loads(raw)
    except json.JSONDecodeError:
        return None, "unparseable"  # truncado o malformado

    if not data.get("name") or not data.get("email"):
        return None, "empty_field"  # presente pero en blanco
    if "@" not in data["email"]:
        return None, "bad_email"  # la forma está bien, el valor no
    return data, None

contact, error = parse_contact(response.choices[0].message.content)
if error == "unparseable":
    pass  # reintenta una vez, probablemente truncamiento: sube max_tokens o acorta la entrada
elif error:
    pass  # registra la falla a nivel de contenido y usa un plan alternativo

El patrón es un análisis defensivo que distingue los modos de falla, porque necesitan un manejo distinto. Un JSONDecodeError suele significar truncamiento, así que la solución es subir max_tokens o achicar la entrada y reintentar. Un valor vacío o fuera de rango es una falla de contenido, no de formato, así que reintentar la misma llamada rara vez ayuda; regístralo y usa un plan alternativo.

Separa "no se pudo analizar" de "se analizó pero está mal", porque la solución difiere. Esto se conecta con la alucinación: la decodificación restringida eliminó el modo de falla de salida malformada y dejó totalmente intacto el de valor incorrecto.

JunoValida de todos modos El modo estricto fija la forma, no el contenido, así que valida cada vez: un registro puede estar bien formado y contener un error de tipeo, una suposición o un espacio en blanco. Separa las fallas, porque un JSONDecodeError suele significar truncamiento (sube max_tokens o acorta la entrada y reintenta), mientras que un valor incorrecto es una falla de contenido que reintentar la misma llamada no arreglará. La decodificación restringida eliminó el problema de la salida malformada y dejó intacto el del valor incorrecto.

La decodificación restringida cierra el modo de falla de salida malformada y no cierra nada más. La forma está garantizada; el contenido no. Un campo obligatorio que la entrada nunca proporcionó se llena con una suposición confiada, un número cae fuera de cualquier rango razonable, un correo se analiza como cadena pero tiene un error de tipeo.

Incluso la garantía de formato se pierde ante el truncamiento. Así que la validación no es higiene opcional, es la capa que atrapa lo que el esquema estructuralmente no puede.

python
import json

def parse_contact(raw, retry):
    try:
        data = json.loads(raw)
    except json.JSONDecodeError:
        return None, "truncated"  # generación incompleta, no un problema de contenido

    if not data.get("name") or "@" not in data.get("email", ""):
        return None, "invalid_value"  # la forma se sostuvo, el valor no
    return data, None

contact, failure = parse_contact(raw, retry=False)
if failure == "truncated":
    pass  # sube max_tokens o recorta la entrada, luego reintenta la llamada
elif failure == "invalid_value":
    pass  # ruta de reparación: vuelve a preguntar devolviendo la salida mala, o enruta a un plan alternativo

Tres cosas separan a un validador sólido de un try/except que se traga todo:

  • Clasifica la falla: el truncamiento es un problema de presupuesto que se arregla con un reintento con más max_tokens, mientras que un valor inválido es un problema de contenido que un reintento ciego reproducirá.
  • Construye una ruta de reparación para el caso de nivel de valor, en vez de solo un plan alternativo. Devolver la salida inválida con una instrucción para corregirla a menudo la recupera en una llamada extra, lo cual es más barato que fallar la solicitud, pero limita los reintentos para que una entrada persistentemente mala no entre en bucle.
  • Limita el costo: cada reintento es otra llamada facturada y otro viaje de ida y vuelta en latencia, así que un presupuesto de reintentos es parte del diseño, no una ocurrencia tardía.

Valida los valores, no solo el análisis. Esta es la historia de contención de alucinación aplicada a datos estructurados: la decodificación restringida te da un sobre limpio y no te dice nada sobre lo que hay dentro, así que el sobre es justo donde los equipos dejan de validar y se queman. La validación de esquema, las verificaciones de rango y semántica, y un bucle de reparación acotado son las tres capas, y atrapan cosas distintas: el esquema atrapa la forma, las verificaciones atrapan los valores sin sentido, el bucle de reparación recupera los rescatables.

JunoValida de todos modos El modo estricto elimina la salida malformada y deja totalmente intactos los valores incorrectos, así que valida el contenido, no solo el análisis. Clasifica la falla: el truncamiento se arregla con presupuesto (más max_tokens, reintento), un valor inválido es una falla de contenido que un reintento ciego solo reproduce, así que construye una ruta de reparación que devuelva la salida mala, y limita los reintentos para que una entrada mala no dispare tu factura. El sobre limpio es justo donde la gente deja de revisar y se quema.

Dos patrones: clasificar y extraer ​

La mayor parte del trabajo de salida estructurada tiene una de estas dos formas.

La clasificación ordena una entrada en una de un conjunto fijo de etiquetas. Un enum en el esquema restringe la salida exactamente a esas etiquetas, usando el mismo truco de poda de tokens: en la posición de la etiqueta, solo se pueden predecir los valores permitidos, así que el modelo no puede inventar una categoría que no esté en tu lista.

python
# fragmento de esquema para clasificación
{"type": "string", "enum": ["billing", "technical", "general"]}

La extracción saca campos específicos de texto libre, como el ejemplo de contacto de antes: un nombre, una fecha, un monto, una lista de nombres de productos. Juntas, clasificar y extraer cubren una gran parte de las funciones reales de IA: enrutar tickets de soporte, etiquetar contenido, convertir correos en registros, leer recibos. Ambas convierten a un generador de texto impreciso en un componente confiable sobre el que tu código puede construir.

JunoDos patrones: clasificar y extraer La clasificación ordena una entrada en una de un conjunto fijo de etiquetas, fijada con un enum para que el modelo no pueda inventar una categoría fuera de tu lista. La extracción saca campos con nombre de texto libre hacia un registro. Ambas convierten a un generador de texto impreciso en un componente confiable, y entre las dos cubren una gran parte de las funciones prácticas de IA.

Casi todo lo que construyes con salida estructurada tiene una de estas dos formas, y nombrarlas te ayuda a elegir el esquema correcto.

La clasificación asigna una entrada a una etiqueta de un conjunto fijo. El enum hace todo el trabajo: la decodificación restringida enmascara cada token excepto tus etiquetas listadas en la posición de la etiqueta, así que el modelo devuelve una de ellas o nada más.

python
# clasificación: una etiqueta de un conjunto cerrado
{"type": "string", "enum": ["billing", "technical", "general"]}

La extracción saca campos con nombre de texto libre hacia un registro, como los ejemplos de contacto y de ticket. Las dos se combinan: un solo esquema puede clasificar y extraer a la vez, que es lo que ocurre en la mayoría de las funciones reales. Los conjuntos cerrados llevan un enum; los valores abiertos llevan un campo con tipo.

La decisión que debes tomar consciente: cuando un valor realmente es un conjunto fijo (estado, categoría, prioridad), usa un enum para que el modelo no pueda desviarse, y cuando es abierto (un nombre, un resumen), usa un campo simple con tipo y acepta que estás confiando lo suficiente en el valor como para validarlo. Confundirlos, un enum donde el mundo real tiene más casos, o un campo libre donde un conjunto cerrado habría atrapado errores, es donde estas funciones fallan silenciosamente.

JunoDos patrones: clasificar y extraer Dos formas cubren la mayoría de esto: la clasificación asigna a una etiqueta de un conjunto cerrado (el enum hace la restricción) y la extracción saca campos con nombre hacia un registro, y un solo esquema puede hacer ambas cosas a la vez. Elige con criterio: enum para conjuntos fijos para que el modelo no se desvíe, campo simple con tipo para valores abiertos que vas a validar. Un enum al que le falta un caso real del mundo es una fuente silenciosa de etiquetas equivocadas.

La salida estructurada se reduce a dos patrones, y la distinción es una palanca de diseño, no solo vocabulario. La clasificación asigna la entrada a una etiqueta de un conjunto cerrado, impuesta por un enum que la decodificación restringida reduce a una elección forzada entre tus valores. La extracción saca campos con tipo de texto libre. La mayoría de los esquemas de producción combinan ambas cosas.

python
# clasificación: la decodificación restringida permite solo estos tokens en la posición de la etiqueta
{"type": "string", "enum": ["billing", "technical", "general"]}

La palanca está en dónde trazas el límite del conjunto cerrado, porque el enum es una garantía de corrección con un filo cortante. Un valor que realmente está acotado (un estado, una prioridad) pertenece a un enum para que el modelo no pueda emitir nada fuera de la lista, y eso convierte una generación abierta en una verificación en la que tu código puede confiar.

Pero el enum fuerza una elección incluso cuando ninguna calza: si la entrada real no coincide con ninguna etiqueta, el modelo está obligado a elegir la más cercana equivocada en vez de decirte que ninguna aplica. Un enum sin salida de escape convierte "no aplica" en una etiqueta equivocada con aparente confianza. Así que para cualquier clasificador que enfrente entradas reales desordenadas, agrega una salida de escape explícita, un miembro other o unknown, y léelo como la señal para enrutar hacia otro lado.

La misma precaución aplica a la confianza: si una decisión depende de la etiqueta, haz que el modelo también emita un campo de confianza o una breve justificación, para que una decisión al límite sea visible en vez de disfrazarse en un valor de enum que se ve limpio. Son los mismos instintos que en el uso de herramientas, donde el modelo elige una herramienta de un conjunto cerrado y enfrentas el mismo problema idéntico de "qué pasa si ninguna aplica".

JunoDos patrones: clasificar y extraer La clasificación es un conjunto cerrado impuesto por un enum, la extracción son campos con tipo sacados de texto libre, y el enum es una garantía con un filo cortante: fuerza una elección incluso cuando nada calza, disfrazando "no coincide" en una etiqueta equivocada con aparente confianza. Agrega un miembro other o unknown y enruta según él, y emite un campo de confianza cuando una decisión depende de la etiqueta. Es la misma forma que elegir una herramienta de un conjunto cerrado en el uso de herramientas.

En la práctica ​

Convertir un correo de soporte desordenado en un ticket estructurado, combinando clasificación y extracción en un solo esquema:

python
import json

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": "Turn the support email into a ticket."},
        {"role": "user", "content": email_text},
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "technical", "general"]},
                    "urgency": {"type": "string", "enum": ["low", "medium", "high"]},
                    "summary": {"type": "string"},
                },
                "required": ["category", "urgency", "summary"],
                "additionalProperties": False,
            },
        },
    },
)

ticket = json.loads(response.choices[0].message.content)
# {"category": "billing", "urgency": "high", "summary": "Double-charged for last month's subscription."}

Una sola llamada clasifica el correo de dos maneras y extrae un resumen, devolviendo un registro que tu código puede enrutar y guardar, con la forma garantizada y los valores todavía dignos de revisión. Hasta ahora todo ha sido texto que entra y texto que sale. A continuación le das al modelo un sentido completamente distinto: en Embeddings, el texto se convierte en números que puedes comparar por significado, la base de la búsqueda y del trabajo con tus propios documentos.

JunoEn la práctica Una sola llamada con un esquema estricto puede clasificar un correo de dos maneras y extraer un resumen a la vez, devolviendo un registro que tu código puede enrutar y guardar. La forma está garantizada; los valores todavía valen la pena revisarlos. El uso de herramientas se apoya en este mismo truco más adelante: los argumentos que un modelo envía a una herramienta también son salida estructurada.

Una función real suele combinar ambos patrones en un solo esquema. Aquí un correo de soporte se convierte en un ticket: dos clasificaciones y una extracción en una sola llamada.

python
import json

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": "Turn the support email into a ticket."},
        {"role": "user", "content": email_text},
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "technical", "general"]},
                    "urgency": {"type": "string", "enum": ["low", "medium", "high"]},
                    "summary": {"type": "string"},
                },
                "required": ["category", "urgency", "summary"],
                "additionalProperties": False,
            },
        },
    },
)

ticket = json.loads(response.choices[0].message.content)
# {"category": "billing", "urgency": "high", "summary": "Double-charged for last month's subscription."}

Los dos enums están fuertemente restringidos, así que category y urgency siempre son enrutables. El summary es un campo abierto, así que es el que debes validar antes de confiar en él. Esa combinación, etiquetas impuestas más un campo de texto libre verificado, es la forma de la mayoría de las funciones de extracción. A continuación, Embeddings le da al modelo un sentido distinto: texto convertido en números que puedes comparar por significado, la base de la búsqueda y del trabajo con tus propios documentos.

JunoEn la práctica Un solo esquema estricto puede clasificar de dos maneras y extraer un resumen en una sola llamada, devolviendo un registro que puedes enrutar y guardar. Los enums están impuestos, así que las etiquetas son seguras para actuar sobre ellas; el summary abierto es el campo a validar. Esa mezcla de etiquetas fijadas y texto libre verificado es la forma cotidiana de una función de extracción.

La forma cotidiana en producción es un compuesto: clasificar en un par de ejes y extraer un campo de texto libre, todo en un solo esquema y una sola llamada.

python
import json

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": "Turn the support email into a ticket."},
        {"role": "user", "content": email_text},
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "technical", "general"]},
                    "urgency": {"type": "string", "enum": ["low", "medium", "high"]},
                    "summary": {"type": "string"},
                },
                "required": ["category", "urgency", "summary"],
                "additionalProperties": False,
            },
        },
    },
)

ticket = json.loads(response.choices[0].message.content)
# {"category": "billing", "urgency": "high", "summary": "Double-charged for last month's subscription."}

La restricción no es uniforme entre los campos, y ese es justamente el punto de diseño. Los enums son garantías firmes, así que category y urgency son seguros para enrutar sin más verificaciones. El summary es una cadena sin restricciones, así que es exactamente donde un valor alucinado o desacertado puede esconderse detrás de un esquema limpio, y el campo que merece una pasada de validación. Dos etiquetas impuestas con un campo summary abierto es también el esquema más expuesto al truncamiento: un resumen generado largo es lo que te lleva a chocar con max_tokens y vuelve imposible de parsear todo el objeto, así que dimensiona el presupuesto para el campo de texto libre, no para las etiquetas.

Este es el mismo mecanismo que el uso de herramientas: una llamada a una herramienta es un modelo emitiendo argumentos estructurados contra el esquema de una función, restringido de manera idéntica, así que los instintos de validación, reparación y salida de escape en enums que viste aquí se trasladan tal cual a hacer confiables a los agentes. Desde aquí, Embeddings cambia al modelo a un modo distinto: texto como vectores que comparas por significado, la base de la búsqueda y de anclar respuestas en tus propios documentos.

JunoEn la práctica Un esquema estricto, dos enums impuestos y un summary abierto: las etiquetas son seguras para enrutar, el campo de texto libre es donde se esconde un valor alucinado y donde una generación larga hace que max_tokens provoque truncamiento, así que preséntale un presupuesto y valídalo específicamente. Este es el mismo mecanismo que el uso de herramientas, argumentos restringidos contra el esquema de una función, así que cada hábito de aquí, validación, reparación, salidas de escape en enums, se traslada directamente a los agentes.