Skip to content
This page has been auto-translated and may contain errors.View in English

Embeddings ​

docs.scrimba.com

Primero, el término. Un embedding es una lista de números que representa un fragmento de texto y captura su significado, de modo que textos con significados parecidos se convierten en números parecidos. Este capítulo trata sobre cómo convertir palabras en algo que una computadora puede comparar, y es lo que permite que la búsqueda funcione por significado en lugar de por palabras clave.

El texto como vectores ​

¿Cómo sabe una computadora que "perro" y "cachorro" están relacionados, mientras que "perro" y "engrapadora" no lo están? Las palabras no comparten ninguna letra relevante.

El truco consiste en convertir el texto en números que capturen su significado, de modo que significados parecidos terminen siendo números parecidos. Esa lista de números es un embedding, también llamado vector. Un modelo lee el texto y devuelve el vector.

Tú no interpretas los números directamente. Lo que importa es la relación entre ellos.

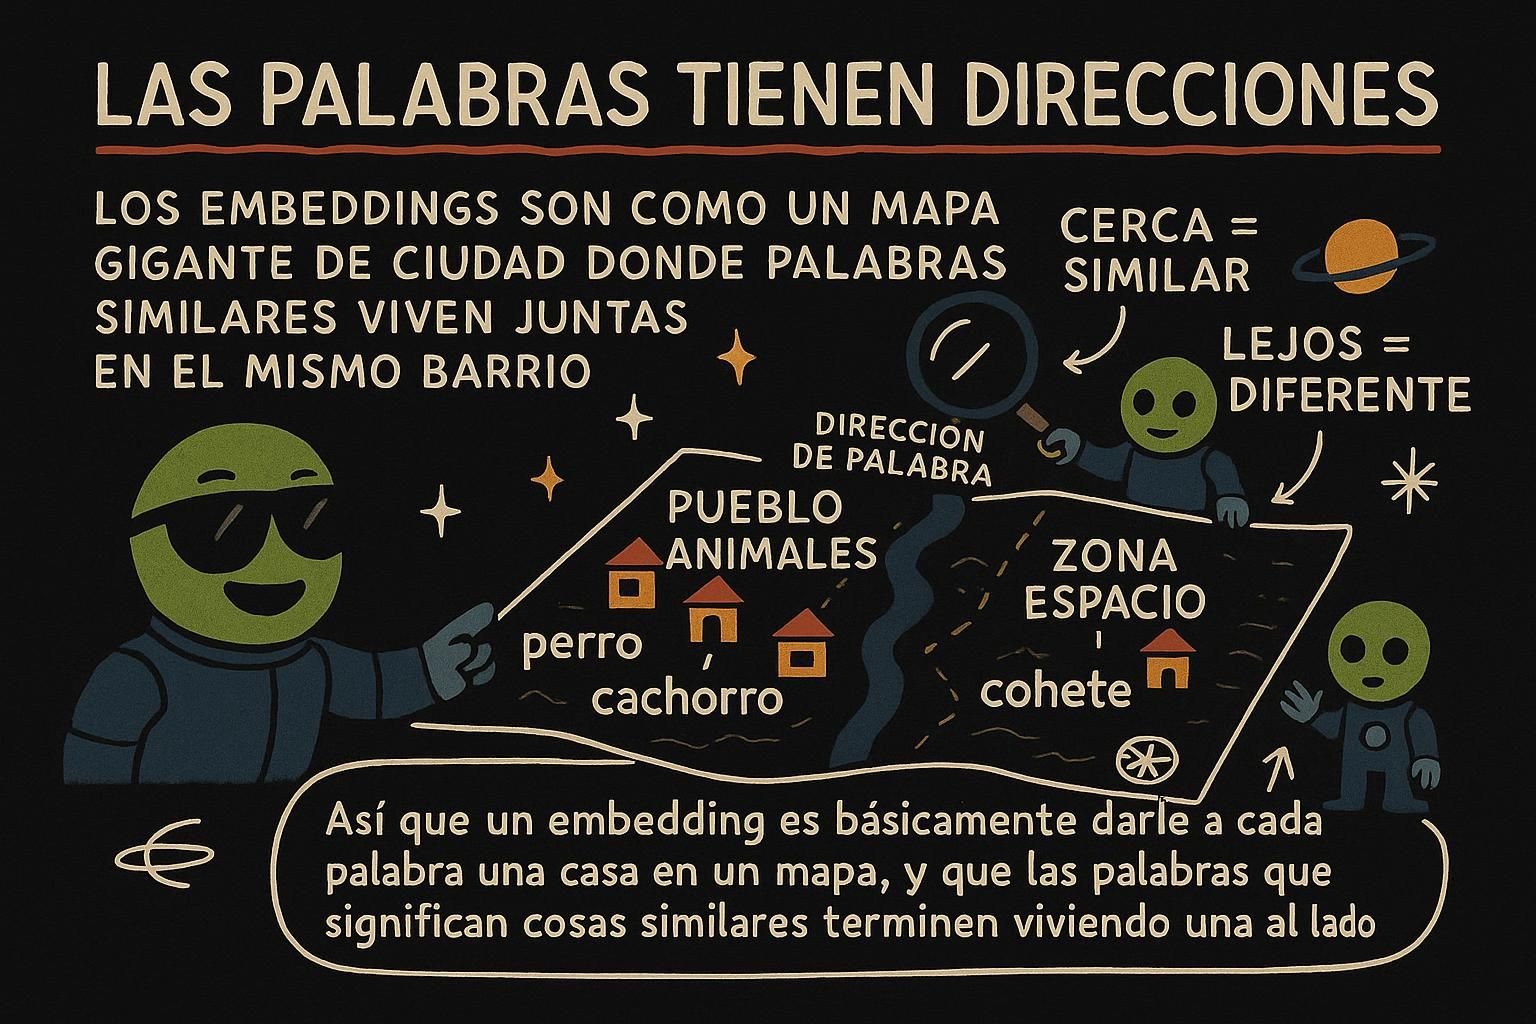
Una imagen mental aproximada: imagina cada fragmento de texto colocado como un punto en el espacio, donde las cosas con significados parecidos quedan cerca unas de otras. "Perro" y "cachorro" caen en el mismo vecindario. "Engrapadora" queda del otro lado de la ciudad. Los embeddings reales usan cientos o miles de dimensiones en lugar de las dos o tres que puedes imaginar, pero la intuición se mantiene: cercanía significa similitud.

¿De dónde salen esos números, y por qué coinciden con el significado? Un modelo de embeddings es un pariente cercano del modelo predictivo que vimos en Cómo funcionan los LLM, entrenado con una enorme cantidad de texto. Para volverse bueno en su tarea, tuvo que aprender qué palabras e ideas aparecen en contextos parecidos, la vieja idea de que conoces una palabra por la compañía que frecuenta.

"Perro" y "cachorro" aparecen en el mismo tipo de oraciones, así que el modelo aprendió a representarlos de forma parecida. "Engrapadora" frecuenta otra compañía, así que queda en otro lugar. Los cientos de números son direcciones de significado aprendidas, cada una capturando algún eje de cómo varía el texto, ninguna etiquetada de una forma que un humano pueda leer. Nunca decodificas los números, solo mides qué tan cerca están dos vectores.

JunoEl texto como vectores Un embedding es una lista de números, un vector, que representa el significado de un fragmento de texto, producido por un modelo entrenado con enormes cantidades de texto. Aprendió a colocar cerca palabras e ideas que aparecen en contextos parecidos, de modo que significados similares obtienen vectores similares. Nunca lees los números directamente, solo mides qué tan cerca están dos de ellos, y esa cercanía refleja el significado.

Quieres una búsqueda que funcione por significado en lugar de por ortografía, de modo que "que me devuelvan mi dinero" encuentre una línea sobre reembolsos. La estrategia consiste en convertir cada fragmento de texto en un vector, una lista de números de longitud fija donde los significados parecidos quedan cerca entre sí. Un modelo de embeddings lee el texto y produce ese vector, y todo el punto es que la distancia entre vectores representa qué tan parecidos son en significado.

El vector tiene una longitud fija, su dimensión, a menudo entre varios cientos y un par de miles de números. Todo texto que conviertas en embedding con el mismo modelo sale con la misma longitud, y eso es lo que te permite comparar cualquier par de ellos. Esas dimensiones son direcciones de significado aprendidas, no categorías etiquetadas por humanos, así que no interpretas la dimensión 47 como "formalidad". Tratas el vector como un punto opaco y mides distancias.

Antes de convertir algo real en embedding, hay un paso que decide si todo el sistema funciona: el chunking. Casi nunca conviertes un documento completo en un solo vector, porque un solo vector para un manual de 20 páginas mezcla todos sus temas en un único punto promedio que no coincide bien con nada. En cambio, divides el documento en chunks, pasajes de más o menos un párrafo a una página, y conviertes cada chunk en embedding por separado. Convierte en embedding los chunks, no documentos completos, para que cada vector cargue una sola idea concreta.

El tamaño del chunk es una decisión de compromiso real que debes tomar de forma deliberada. Los chunks demasiado grandes promedian varias ideas juntas y recuperan resultados imprecisos. Los chunks demasiado pequeños pierden el contexto circundante que le daba sentido a una oración. Un punto de partida común es unos pocos cientos de tokens por chunk con un pequeño traslape entre chunks vecinos, de modo que una oración dividida en el límite entre dos chunks todavía aparezca completa en al menos uno de ellos, y luego ajustas según lo que tu recuperación efectivamente devuelve.

JunoEl texto como vectores Un embedding convierte el texto en un vector de longitud fija donde la distancia representa la similitud de significado, y todos los vectores de un mismo modelo comparten longitud para que puedas compararlos. Las dimensiones son direcciones aprendidas, no etiquetas, así que trata el vector como un punto opaco. Esto es lo que más importa: divide tus documentos en pasajes del tamaño de un párrafo y convierte cada chunk en embedding, porque un solo vector para un documento entero promedia todo hasta volverlo confuso.

La búsqueda por significado descansa en una sola idea: mapear el texto a un espacio vectorial (un espacio de coordenadas de dimensión fija donde cada punto es una lista de números) de tal forma que la similitud semántica se convierta en proximidad geométrica. Un modelo de embeddings es ese mapeo: lee texto y devuelve un vector.

Todo lo que construyas encima, indexación, recuperación, ranking, es geometría sobre esos vectores. Si te equivocas en el mapeo, nada de lo que sigue puede compensarlo.

La primera palanca de diseño es qué conviertes en embedding, y eso es el chunking: dividir los documentos fuente en pasajes antes de generar los embeddings, en lugar de convertir archivos completos. La razón es que un embedding es una compresión con pérdida de su entrada en un solo punto, así que cuantas más ideas distintas contenga un chunk, más se promedian hacia un centroide vago que no recupera nada con precisión. Ajusta el tamaño del chunk a la unidad sobre la que un usuario preguntará, normalmente un pasaje de unos pocos cientos de tokens, con un pequeño traslape para que un dato que quede a caballo entre dos chunks sobreviva en al menos uno de ellos.

La estrategia de chunking es lo que define si la calidad de la recuperación se gana o se pierde, más incluso que la elección del modelo:

  • Las ventanas de tamaño fijo son económicas, pero cortan oraciones a mitad de una idea.
  • La división consciente de la estructura (por encabezados, párrafos o bloques de código) mantiene cada chunk coherente y suele recuperar mejor, a costa de un pipeline más elaborado.

Sea lo que elijas, guarda la fuente y la posición del chunk junto a su vector, porque en el momento de la recuperación necesitas poder señalar de dónde vino un dato, y un vector desnudo no puede decírtelo.

Una propiedad más que conviene internalizar: las dimensiones del embedding no son ejes interpretables, así que no puedes depurar la recuperación leyendo un vector. Depuras embeddings inspeccionando lo que recuperan, nunca leyendo los números. Cuando una consulta trae el chunk equivocado, la solución está en el chunking, en el modelo o en la consulta, examinados a través de los resultados recuperados, no de las coordenadas en sí.

JunoEl texto como vectores Un modelo de embeddings mapea el texto a un espacio vectorial donde la similitud semántica se convierte en distancia geométrica, y cada paso posterior es geometría sobre esos puntos. El chunking es la palanca que decide la calidad de la recuperación: dimensiona los chunks según la unidad sobre la que preguntará el usuario, divide según la estructura cuando puedas, y guarda la fuente y la posición de cada chunk junto a su vector para poder rastrear un dato hasta su origen. No puedes leer un vector para depurarlo, así que cuando la recuperación falla, inspecciona lo que volvió, no los números.

Generar un embedding ​

Le pides el vector a un modelo de embeddings, de forma muy parecida a una llamada normal a un modelo, pero con un endpoint y un modelo distintos.

python
from openai import OpenAI

client = OpenAI()

EMBED_MODEL = "text-embedding-3-small"  # punto de cambio para el modelo de embeddings

def embed(text):
    response = client.embeddings.create(model=EMBED_MODEL, input=text)
    return response.data[0].embedding  # una lista de números

vector = embed("un perro pequeño y juguetón")
print(len(vector))  # por ejemplo, 1536 números

El resultado es una lista de números. Una regla importa más que las demás: compara siempre embeddings generados por el mismo modelo. Los vectores de modelos distintos viven en espacios distintos y no son comparables, como medidas en unidades diferentes. Mezclar modelos da puntajes sin sentido, siempre.

Y como toda llamada a un modelo, se te cobra por tokens, así que convertir en embedding una colección grande de documentos tiene un costo que vale la pena estimar de antemano, antes de correrlo sobre miles de documentos.

JunoGenerar un embedding Generas un embedding llamando a un modelo de embeddings, que te devuelve una lista de números para tu texto. Compara siempre vectores generados por el mismo modelo, porque modelos distintos producen vectores que no son comparables, como comparar centímetros con pulgadas. El embedding se cobra por tokens, así que una colección grande tiene un costo real que conviene revisar primero.

La llamada en sí es un endpoint distinto con la misma forma que una llamada de chat: envías texto, recibes un vector de vuelta.

python
from openai import OpenAI

client = OpenAI()

EMBED_MODEL = "text-embedding-3-small"

def embed_batch(texts):
    # envía muchos textos en una sola solicitud, recibe un vector por texto
    response = client.embeddings.create(model=EMBED_MODEL, input=texts)
    return [item.embedding for item in response.data]

chunks = ["un perro pequeño y juguetón", "un perro joven", "un artículo de oficina"]
vectors = embed_batch(chunks)  # un vector por chunk, en el mismo orden de entrada

La forma varía según el proveedor, pero la idea de solicitud y respuesta es la misma en todas partes. Dos puntos prácticos más allá de la llamada básica. Primero, convierte en embedding por lotes: la mayoría de los endpoints aceptan una lista de textos en una sola solicitud y devuelven un vector por cada uno, lo cual es más rápido y económico que una llamada por chunk, porque pagas menos overhead de solicitud y te topas menos con los límites de tasa. Cuando indexas un corpus grande, procesar por lotes es lo que mantiene el costo y el tiempo real dentro de lo razonable.

Segundo, la regla del mismo modelo tiene una compañera: el modelo y la dimensión son una decisión, no algo que se deja por defecto. Los modelos de embeddings más grandes, con más dimensiones, capturan distinciones más finas, pero cuestan más de calcular, almacenar y comparar. Elige el modelo y la dimensión más pequeños que aun así logren separar tus datos.

Algunos modelos incluso te permiten pedir un vector más corto para intercambiar un poco de precisión por almacenamiento más económico y búsquedas más rápidas. Lo que elijas se vuelve un contrato: si cambias el modelo más adelante, tendrás que regenerar cada vector almacenado.

JunoGenerar un embedding Generar un embedding es una solicitud que toma texto y devuelve un vector, y la misma forma funciona en distintos proveedores. Agrupa tus textos en una sola llamada cuando puedas, porque reduce el overhead de solicitud y la presión sobre los límites de tasa en un corpus grande. El modelo y la dimensión son una decisión real: elige el más pequeño que aun así separe tus datos, y recuerda que el modelo se vuelve un contrato, ya que cambiarlo significa volver a generar los embeddings de todo lo que guardaste.

La superficie de la API es pequeña. Envías texto, recibes un vector de flotantes, y las decisiones interesantes están alrededor de esa llamada, no dentro de ella.

python
from openai import OpenAI

client = OpenAI()

EMBED_MODEL = "text-embedding-3-small"

def embed_batch(texts):
    # una solicitud, muchos vectores de vuelta, en el orden de entrada
    response = client.embeddings.create(model=EMBED_MODEL, input=texts)
    return [item.embedding for item in response.data]

La forma de la solicitud y la respuesta varía según el proveedor, pero todo endpoint de embeddings sigue este mismo contrato: entran lotes, salen vectores. Procesar por lotes no es un lujo a escala, es la diferencia entre un trabajo de indexación que termina y uno que se estanca toda la tarde: cada solicitud carga un overhead fijo y cuenta contra un límite de tasa, así que amortiza ambos enviando lotes grandes, y luego retrocede y reintenta ante las fallas parciales que un trabajo grande inevitablemente tendrá.

El modelo y la dimensión son un compromiso arquitectónico con consecuencias a largo plazo. Los vectores de mayor dimensión almacenan más distinción, pero cuestan más en cada eje que importa en producción: el almacenamiento por vector, la memoria del índice y el tiempo por comparación escalan con la dimensión. Algunos modelos soportan embeddings tipo Matryoshka (vectores que puedes truncar a una longitud más corta y aun así usar), que te permiten conservar vectores completos para precisión y servir un prefijo truncado para una primera búsqueda económica. Vale la pena cuando tu corpus es lo bastante grande como para que el almacenamiento y la latencia de consulta, y no la calidad del modelo, sean la restricción que te limita.

El compromiso que muerde más adelante es el versionado. Un embedding almacenado queda ligado para siempre a una versión exacta del modelo.

Los vectores de dos versiones de modelo no son comparables, así que no puedes convertir en embedding una consulta nueva con un modelo más reciente y compararla contra un índice construido con el anterior. El resultado es silencioso: los puntajes parecen plausibles y los rankings están mal. Trata la versión del modelo como parte del esquema de tu índice, guárdala junto a los vectores, y planea regenerar los embeddings como una migración, algo que se cubre más adelante en este capítulo, en la discusión sobre actualidad de los datos.

JunoGenerar un embedding La llamada de embedding es un contrato de lotes de entrada y vectores de salida que varía en forma según el proveedor, pero no en idea, y procesar por lotes con reintentos es lo que hace que un trabajo de indexación grande termine en lugar de estancarse. El modelo y la dimensión escalan el almacenamiento, la memoria y la latencia de consulta, así que recurre a vectores truncables cuando la restricción sea la escala y no la calidad. La versión es un compromiso permanente: los vectores de distintas versiones de modelo fallan al compararse de forma silenciosa, así que guarda la versión en tu esquema y trata la regeneración de embeddings como una migración planeada.

Medir la similitud ​

Para saber qué tan relacionados están dos fragmentos de texto, mides qué tan cerca están sus vectores. La medida estándar es la similitud coseno, que devuelve un número entre -1 y 1: más cerca de 1 significa más similar, cerca de 0 significa que no están relacionados. No necesitas conocer las matemáticas detrás para usarla. Piénsalo como comparar hacia dónde apuntan dos vectores.

La dirección es lo que carga el significado aquí, por eso el coseno compara el ángulo en lugar de la distancia bruta. Dos textos sobre reembolsos apuntan hacia el mismo lado, sin importar si uno es una frase corta y el otro un párrafo largo.

python
import math

def cosine_similarity(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    mag_a = math.sqrt(sum(x * x for x in a))
    mag_b = math.sqrt(sum(x * x for x in b))
    return dot / (mag_a * mag_b)

perro = embed("un perro pequeño y juguetón")
cachorro = embed("un perro joven")
engrapadora = embed("un artículo de oficina para unir papel")

print(cosine_similarity(perro, cachorro))     # más alto, los dos son cercanos en significado
print(cosine_similarity(perro, engrapadora))  # más bajo, los dos no están relacionados

Los números confirman la intuición: perro y cachorro puntúan más alto, perro y engrapadora puntúan más bajo. Comparar el vector de una consulta contra vectores almacenados es el corazón de la búsqueda semántica. Esa única función es la maniobra sobre la que se construye el resto del capítulo.

JunoMedir la similitud La similitud coseno puntúa qué tan cerca están dos vectores, entre -1 y 1, donde más cerca de 1 significa más similar. Puedes usarla sin conocer las matemáticas, compara hacia dónde apuntan dos vectores, por eso una frase corta y un párrafo largo sobre lo mismo igual coinciden. Comparar el vector de una consulta contra vectores almacenados es la maniobra central de la búsqueda semántica.

Ya tienes vectores, ahora necesitas un número que diga qué tan cerca están dos de ellos. El estándar es la similitud coseno: mide el ángulo entre dos vectores, ignorando su longitud, y devuelve un valor entre -1 y 1 donde más alto significa más parecidos. El ángulo, no la distancia, es lo que quieres, porque un pasaje largo y una frase corta sobre el mismo tema deberían puntuar como similares aunque sus vectores tengan magnitudes distintas.

python
def dot(a, b):
    return sum(x * y for x, y in zip(a, b))

# si los vectores están normalizados a longitud 1, la similitud coseno equivale a su producto punto
score = dot(query_vector, doc_vector)  # no se necesita división

Aquí está la jugada que rinde frutos a escala: normaliza tus vectores a longitud 1 cuando los almacenes. Una vez que cada vector tiene la misma longitud, la división en la similitud coseno desaparece y el puntaje se convierte en un simple producto punto, que es una multiplicación y una suma por dimensión, mucho más rápido de ejecutar sobre un conjunto grande. Normaliza una vez al almacenar, y luego compara con un producto punto. Muchos modelos de embeddings devuelven vectores ya normalizados, pero no lo asumas, verifícalo.

El otro cambio respecto al ejemplo de juguete: casi nunca quieres solo la coincidencia más cercana. Quieres recuperación top-k, los k resultados con puntaje más alto, normalmente entre tres y diez. Un vector puede quedarse justo por debajo, mientras que el segundo y el tercero juntos contienen la respuesta, y devolver un conjunto pequeño le da margen de trabajo a la siguiente etapa. Devolver solo el primero descarta contexto que después vas a querer haber conservado.

JunoMedir la similitud La similitud coseno compara el ángulo entre dos vectores, entre -1 y 1, ignorando la longitud, así que una frase corta y un pasaje largo sobre el mismo tema igual coinciden. Normaliza tus vectores a longitud 1 al momento de almacenarlos y la comparación se reduce a un producto punto rápido, lo cual se nota al escalar sobre un conjunto grande. Y recupera top-k, entre tres y diez resultados, no solo el mejor, porque la respuesta a menudo está repartida entre los primeros.

Necesitas una métrica de similitud, y la similitud coseno (el coseno del ángulo entre dos vectores, en el rango de -1 a 1) es la opción por defecto porque ignora la magnitud, así que la longitud del documento no ahoga el tema. Esa elección tiene una consecuencia de rendimiento que conviene diseñar con cuidado: el coseno sobre vectores sin normalizar cuesta un producto punto más dos cálculos de magnitud por comparación, y pagas ese costo por cada vector del índice en cada consulta.

python
import numpy as np

# normaliza al momento de escribir, una vez por vector
def normalize(v):
    v = np.asarray(v, dtype=np.float32)
    return v / np.linalg.norm(v)

# al momento de la consulta, el coseno sobre vectores normalizados es un solo producto matriz-vector
def search(query_vec, matrix):
    return matrix @ query_vec  # un puntaje por fila, vectorizado

La optimización consiste en normalizar cada vector a longitud unitaria al momento de escribirlo, lo cual hace que la similitud coseno sea idéntica a un producto punto y te permite puntuar todo el corpus como una sola multiplicación matriz-vector en lugar de un bucle en Python. Normaliza al escribir y la similitud se convierte en un producto punto sobre todo el índice a la vez. Esta es la línea base de fuerza bruta: exacta, directa y lineal en el tamaño del corpus, lo cual está bien hasta unos cientos de miles de vectores aproximadamente y se derrumba por encima de eso, la señal para pasar a un índice aproximado que se cubre más adelante.

Dos realidades de producción que la métrica de juguete oculta. Primero, casi nunca quieres el argmax, quieres top-k con un umbral de puntaje, porque la brecha entre el primer y el segundo resultado te dice qué tan confiable es la coincidencia, y un resultado top que aun así puntúa bajo significa que nada en tu corpus respondió realmente la consulta. Devuelve eso como "sin buena coincidencia" en lugar de entregar la fila menos mala. Segundo, la similitud coseno es relativa, no absoluta: un puntaje de 0.4 solo tiene sentido frente a la distribución de puntajes que produce tu corpus y tu modelo, así que calibra los umbrales de forma empírica para cada índice en lugar de copiar un número mágico de un blog.

JunoMedir la similitud La similitud coseno ignora la magnitud, así que la longitud no ahoga el tema, pero el coseno de fuerza bruta es lineal en el tamaño del corpus y solo se sostiene hasta unos cientos de miles de vectores antes de necesitar un índice aproximado. Normaliza al escribir y la métrica se convierte en un producto punto que puedes ejecutar como una sola multiplicación matriz-vector sobre todo el corpus. Recupera top-k con un umbral, trata un puntaje top bajo como ausencia de coincidencia en lugar de la fila menos mala, y calibra ese umbral por índice porque los números son relativos, no absolutos.

Búsqueda semántica ​

Junta las piezas y puedes buscar por significado en lugar de por palabras clave. Convierte tus documentos en embeddings una vez y guarda los vectores. Cuando llega una consulta, convierte esa consulta en embedding también, y luego devuelve los documentos cuyos vectores estén más cerca.

python
docs = [
    "Restablece tu contraseña desde la página de configuración de la cuenta.",
    "Nuestra política de reembolsos permite devoluciones dentro de 30 días.",
    "Contacta a soporte por correo electrónico para preguntas de facturación.",
]

# convierte cada documento en embedding una vez, de antemano
index = [{"text": text, "vector": embed(text)} for text in docs]

def search(query):
    query_vector = embed(query)
    scored = [{"text": item["text"], "score": cosine_similarity(query_vector, item["vector"])} for item in index]
    return sorted(scored, key=lambda x: x["score"], reverse=True)[0]  # la coincidencia más cercana

print(search("¿cómo hago para que me devuelvan mi dinero?"))
# devuelve la línea de política de reembolsos, aunque no comparte palabras clave con la consulta

La consulta "¿cómo hago para que me devuelvan mi dinero?" encuentra la línea de reembolsos aunque no comparte palabras importantes con ella. La búsqueda semántica coincide por significado, no por ortografía. La búsqueda por palabras clave la habría pasado por alto completamente, porque la consulta y el documento no tienen palabras importantes en común.

El patrón siempre es el mismo: convierte en embedding una vez y conserva los vectores, convierte la consulta en embedding en el momento de la solicitud, puntúa, ordena, devuelve la más cercana. Ese es el ciclo de la búsqueda semántica, y lo reutilizarás durante el resto de este manual.

JunoBúsqueda semántica La búsqueda semántica convierte tus documentos en embeddings una vez y almacena los vectores, luego convierte cada consulta entrante en embedding y devuelve los documentos más cercanos por similitud coseno. Coincide por significado, así que "que me devuelvan mi dinero" encuentra una línea de "política de reembolsos" que no comparte palabras clave. Esa coincidencia basada en el significado es lo que la búsqueda por palabras clave no puede hacer.

La versión de juguete guarda los vectores en una lista de Python y puntúa cada uno en cada consulta. Eso funciona para una demo y se rompe en cuanto tu corpus crece, porque un escaneo lineal vuelve a ejecutar la comparación completa sobre cada vector en cada consulta, y además estás reconstruyendo el índice en memoria en cada reinicio.

La solución es una base de datos vectorial: un almacén construido para guardar vectores y responder "encuentra los k más cercanos a este vector de consulta" rápidamente y desde disco. En lugar de tu propia lista y tu bucle, escribes los vectores una vez y la base de datos se encarga de la búsqueda, la persistencia y la actualización de entradas individuales.

python
# la forma varía según la base de datos vectorial, pero el patrón es el mismo en todas partes
index.upsert([
    {"id": "doc-1", "vector": embed(chunk), "metadata": {"source": "faq.md", "section": "reembolsos"}}
    for chunk in chunks
])

results = index.query(vector=embed(user_question), top_k=5)  # los 5 más cercanos, no solo 1

Dos cosas que la base de datos te da y que la lista no:

  • Devuelve resultados top-k en una sola llamada, los varios más cercanos en lugar de solo el mejor, que es justo lo que alimenta a la siguiente etapa.
  • Almacena metadata junto a cada vector, el archivo fuente, la sección y la marca de tiempo, de modo que un resultado pueda señalar de dónde vino y puedas filtrar por ello.

Guarda los vectores en una base de datos vectorial, no en una lista de Python, en el momento en que tengas datos reales. La lista es para aprender el mecanismo, no para operarlo.

JunoBúsqueda semántica La búsqueda semántica consiste en convertir en embedding una vez, almacenar, convertir la consulta en embedding, y devolver los más cercanos, pero una lista de Python y un bucle solo sobreviven a una demo, porque escanear cada vector por consulta y reconstruir en cada reinicio no escala. Cambia a una base de datos vectorial en el momento en que tengas datos reales: hace búsquedas top-k rápidas desde disco y almacena metadata junto a cada vector para que los resultados señalen su origen. La lista enseña el mecanismo, la base de datos lo opera.

El ciclo de referencia, convertir en embedding una vez, almacenar, convertir la consulta en embedding, puntuar, ordenar, devolver, es correcto y no sobrevive al contacto con la escala. Un escaneo de fuerza bruta es lineal en el tamaño del corpus por consulta, así que con un millón de vectores y cualquier tasa de consultas real estás gastando un segundo de CPU por búsqueda que no tienes disponible. Todo lo relacionado con la búsqueda en producción se trata de evitar comparar la consulta contra cada vector.

Eso es lo que te da la búsqueda de vecino más cercano aproximado (ANN: algoritmos que encuentran los vectores más cercanos rápidamente, aceptando una pequeña probabilidad de pasar por alto el verdadero vecino más cercano). Dos familias dominan:

  • HNSW (Hierarchical Navigable Small World) construye un grafo por capas de los vectores y lo recorre de lo grueso a lo fino, dando baja latencia de consulta a costa de un uso alto de memoria.
  • IVF (inverted file) agrupa los vectores en clústeres y busca solo en los clústeres más cercanos, usando menos memoria pero necesitando que sus centros de clúster se reentrenen a medida que los datos cambian.

Por encima de unos cientos de miles de vectores, ANN no es opcional, es el índice. El compromiso que estás ajustando es recall (la fracción de verdaderos vecinos más cercanos que el índice efectivamente devuelve) contra latencia y memoria: empuja el recall hacia 1.0 y las consultas se vuelven más lentas, relájalo y pierdes silenciosamente chunks relevantes.

El modo de falla que el ciclo de juguete oculta por completo es la actualidad de los datos. Un índice es una fotografía en el tiempo, así que cuando un documento fuente cambia, su vector almacenado queda desactualizado y sigue siendo recuperado como si estuviera vigente. Necesitas un pipeline de regeneración de embeddings que se dispare con el cambio del documento: detectar la edición, volver a dividir en chunks y volver a generar los embeddings de ese documento, e insertar los vectores nuevos mientras eliminas los viejos, idealmente rastreado con un hash de contenido para regenerar solo lo que realmente cambió en lugar de todo el corpus en cada edición. Los vectores desactualizados son la manera silenciosa en que un sistema de recuperación empieza a mentir.

La última brecha es la coincidencia exacta. La búsqueda vectorial está construida para pasarla por alto: una consulta con el número de orden A-10293 o un código de error se convierte en embedding hacia una región difusa y puede no hacer emerger el único documento que contiene esa cadena exacta. La búsqueda híbrida ejecuta búsqueda por palabras clave (que acierta en tokens exactos) junto con búsqueda vectorial (que acierta en significado) y combina los rankings, de modo que identificadores, nombres y términos raros no se pierdan en la difusión semántica. Recurre a ella siempre que tu corpus contenga cosas que los usuarios vayan a escribir de forma literal.

JunoBúsqueda semántica Un escaneo de fuerza bruta muere a escala, así que por encima de unos cientos de miles de vectores usas vecino más cercano aproximado, HNSW para baja latencia con alto uso de memoria o IVF para lo contrario, y ajustas el recall contra la latencia sabiendo que un recall más alto cuesta velocidad. Construye un pipeline de regeneración de embeddings que se dispare con el cambio del documento y use un hash de contenido, porque un índice es una fotografía en el tiempo y los vectores desactualizados se recuperan como si estuvieran vigentes. Y agrega búsqueda híbrida de palabras clave más vector siempre que los usuarios escriban cadenas exactas como números de orden, ya que la búsqueda vectorial pura las pasa de largo.

Para qué no sirven los embeddings ​

Los embeddings son una herramienta de similitud, no una herramienta de razonamiento. Algunos límites que hay que tener presentes para usar la herramienta correcta en cada caso:

  • No hacen coincidencia exacta. Para encontrar un número de orden exacto o un código de error, una búsqueda por palabras clave o en base de datos funciona mejor.
  • No razonan. Te dicen que dos cosas están relacionadas, no por qué, y no si una se deriva lógicamente de la otra.
  • Se desactualizan. Si tus documentos cambian, tienes que volver a generar sus embeddings, o tu búsqueda apuntará a contenido viejo.

Los embeddings encuentran lo que está relacionado, no juzgan qué es verdadero o actual. Cada uno de estos vacíos tiene una herramienta mejor, y saber cuál usar es la mitad de la habilidad.

JunoPara qué no sirven los embeddings Los embeddings miden similitud, no razonan y no hacen coincidencia exacta. Para un número de orden exacto o un código de error, usa búsqueda por palabras clave o en base de datos. Y cuando tus documentos cambien, vuelve a generar sus embeddings, o tu búsqueda apuntará a contenido desactualizado.

La trampa con una herramienta que funciona tan bien es querer usarla para todo. Tres límites marcan dónde detenerse y elegir otra cosa.

La coincidencia exacta es el primero. Los embeddings mapean un ID de orden o un código de error al mismo espacio semántico difuso que todo lo demás, así que A-10293 cae cerca de otras cadenas con forma de número de orden, no exactamente sobre sí mismo. Para identificadores, códigos y cualquier valor que un usuario escriba literalmente, la búsqueda por palabras clave o en base de datos es la herramienta adecuada, y la búsqueda híbrida (búsqueda por palabras clave y vectorial ejecutadas juntas) es cómo obtienes ambas cosas a la vez.

El razonamiento es el segundo. La similitud no es inferencia: que dos chunks puntúen alto significa que tratan de cosas relacionadas, no que uno responde una pregunta o se deriva lógicamente del otro. El razonamiento ocurre en el modelo al que le entregas los chunks recuperados, no en la recuperación. La recuperación encuentra candidatos, el modelo hace el pensamiento.

La actualidad de los datos es el tercero y el que muerde en silencio. Tu índice es una fotografía tomada en el momento en que generaste los embeddings, así que los documentos editados siguen devolviendo su redacción vieja hasta que vuelvas a generar sus embeddings. Trata la regeneración de embeddings ante cambios como parte del sistema, no como algo que haces a mano cuando alguien nota que las respuestas están mal.

JunoPara qué no sirven los embeddings Los embeddings son una herramienta de similitud, así que pasan por alto coincidencias exactas como los IDs de orden, que necesitan búsqueda por palabras clave o un híbrido de ambas, y no razonan, eso lo hace el modelo al que le entregas los chunks. El silencioso es la actualidad de los datos: un índice es una fotografía, así que los documentos editados siguen devolviendo redacción desactualizada hasta que vuelvas a generar sus embeddings. Incorpora la regeneración de embeddings al sistema en lugar de esperar a que alguien note respuestas equivocadas.

Saber dónde se detienen los embeddings es lo que mantiene confiable a un sistema de recuperación, y tres límites importan en producción.

La coincidencia exacta es un punto ciego estructural, no un problema de ajuste. Los embeddings comprimen la entrada hacia vecindarios semánticos, así que identificadores, códigos, SKUs y nombres propios poco comunes se difuminan hacia cadenas de apariencia similar en lugar de caer exactamente sobre sí mismos. La búsqueda vectorial pura puede posicionar una coincidencia casi correcta por encima de la coincidencia exacta. La solución es una recuperación híbrida que fusiona un índice léxico (por palabras clave o BM25, un ranking clásico basado en frecuencia de términos) con el índice vectorial, de modo que los tokens exactos se comparen exactamente mientras el significado se compara semánticamente, y no arriesgas la búsqueda de una orden a la geometría.

El desvío es el límite que se erosiona en silencio. El desvío de embeddings (embedding drift) es el desajuste que ocurre cuando cambia la versión del modelo detrás de tu índice: los vectores de dos versiones ocupan espacios distintos y no son comparables, así que una consulta convertida en embedding con un modelo nuevo, comparada contra un índice construido con el anterior, devuelve resultados sin sentido que parecen plausibles. Fija la versión del modelo en el esquema de tu índice, y trata cualquier actualización de modelo como una migración completa de regeneración de embeddings, no como un simple reemplazo, porque no se lanza ningún error, solo resultados silenciosamente peores.

La evaluación es el límite que la gente omite hasta que la recuperación ya está fallando. No puedes juzgar a simple vista si la recuperación funciona bien, tienes que medirlo: reserva un conjunto de consultas con chunks relevantes conocidos y calcula recall@k (si el chunk correcto quedó entre los primeros k) y precisión (qué proporción de lo que devolviste era relevante). Si no estás midiendo recall@k, no sabes si la recuperación funciona.

Ese conjunto de evaluación también es lo que te dice si una nueva estrategia de chunking, un nuevo modelo o una nueva ponderación híbrida realmente ayudó, en lugar de simplemente cambiar un conjunto de fallas por otro que todavía no has notado. La calidad de la recuperación es la base sobre la que se sostiene RAG, así que merece una prueba real, no una impresión.

JunoPara qué no sirven los embeddings Los embeddings tienen un punto ciego estructural para las coincidencias exactas, así que fusiona un índice léxico con el vectorial para identificadores y códigos en lugar de confiar en la geometría. El desvío de embeddings es el silencioso: los vectores de distintas versiones de modelo no se comparan entre sí, así que fija la versión y trata las actualizaciones como una regeneración completa. Y mide la recuperación con recall@k sobre un conjunto reservado, porque no puedes juzgar a simple vista si funciona, y esa evaluación también es cómo distingues una mejora real de un simple cambio lateral.

En la práctica ​

El flujo completo vive en la función search de arriba: convierte en embedding un pequeño conjunto de entradas de preguntas frecuentes una vez, y luego responde consultas por significado. El patrón es el mismo a cualquier escala, solo cambia el almacenamiento a medida que creces.

En el siguiente capítulo tomas las coincidencias más cercanas y las entregas a un modelo, para que responda a partir de tus documentos en lugar de a partir de su memoria. Esa técnica es RAG, y está construida directamente sobre lo que escribiste aquí.

JunoEn la práctica La búsqueda semántica es el flujo completo: convierte tus documentos en embeddings una vez, y luego, por cada consulta, convierte esa consulta en embedding y devuelve las más cercanas por similitud coseno. Entrega esas coincidencias más cercanas a un modelo y podrá responder a partir de tus documentos en lugar de su memoria. Eso es la recuperación, el siguiente capítulo, construido directamente sobre esto.

El mecanismo ya está resuelto: divide en chunks, genera embeddings por lotes, almacena en una base de datos vectorial, recupera top-k por similitud. Lo que cambia al pasar a producción es la infraestructura alrededor: la regeneración de embeddings ante cambios, la metadata sobre la que filtras, la versión del modelo que fijas.

Los chunks recuperados no son el final. En el siguiente capítulo los entregas a un modelo como contexto para que responda a partir de tus documentos en lugar de a partir de su entrenamiento congelado. Eso es RAG, y la calidad de sus respuestas está limitada por la recuperación que construyes aquí.

JunoEn la práctica El ciclo es dividir en chunks, generar embeddings por lotes, almacenar en una base de datos vectorial, recuperar top-k, y producción es la infraestructura alrededor de eso: regeneración de embeddings ante cambios, filtros de metadata, una versión de modelo fijada. Esos chunks recuperados se convierten en contexto para un modelo en el siguiente capítulo, que es RAG. Sus respuestas son tan buenas como la recuperación que armes aquí.

Todo lo visto aquí, chunking, normalización, indexación ANN, recuperación híbrida, actualidad de los datos y evaluación con recall@k, es la capa de recuperación, y es la parte de un sistema de IA que determina, en silencio, si las respuestas son buenas o no. El modelo que está por encima solo puede razonar sobre lo que la recuperación le entrega, así que una respuesta equivocada dicha con confianza suele ser una falla de recuperación disfrazada de generación.

Ese es el puente hacia el siguiente capítulo. RAG es esta capa de recuperación alimentando contexto fundamentado a un modelo, y cada modo de falla de aquí, vectores desactualizados, coincidencias exactas perdidas, recall bajo, se manifiesta ahí como una respuesta equivocada. Construye la recuperación para que sea medible y esté actualizada, y RAG tendrá algo sólido sobre lo cual sostenerse.

JunoEn la práctica La capa de recuperación, desde el chunking hasta el recall@k, es lo que decide si las respuestas son buenas, porque el modelo solo razona sobre lo que la recuperación le entrega. Una respuesta equivocada dicha con confianza suele ser una recuperación fallando disfrazada, así que el vector desactualizado o la coincidencia exacta perdida es el verdadero problema. RAG, en el siguiente capítulo, es esta capa alimentando a un modelo, y es tan sólida como lo que construyas aquí.