Skip to content
This page has been auto-translated and may contain errors.View in English

Embeddings ​

docs.scrimba.com

Primeiro, o termo. Um embedding é uma lista de números que representa um trecho de texto e captura seu significado, de modo que textos com significados parecidos se transformam em números parecidos. Este capítulo trata de como transformar palavras em algo que um computador consegue comparar, e é isso que permite que a busca faça correspondência por significado em vez de por palavras-chave.

Texto como vetores ​

Como um computador sabe que "cachorro" e "filhote" estão relacionados, enquanto "cachorro" e "grampeador" não têm nada a ver? As palavras não compartilham nenhuma letra relevante.

O truque é transformar o texto em números que capturam seu significado, de modo que significados parecidos acabem em números parecidos. Essa lista de números é um embedding, também chamado de vetor. Um modelo lê o texto e gera o vetor.

Você não interpreta os números por conta própria. O que importa é a relação entre eles.

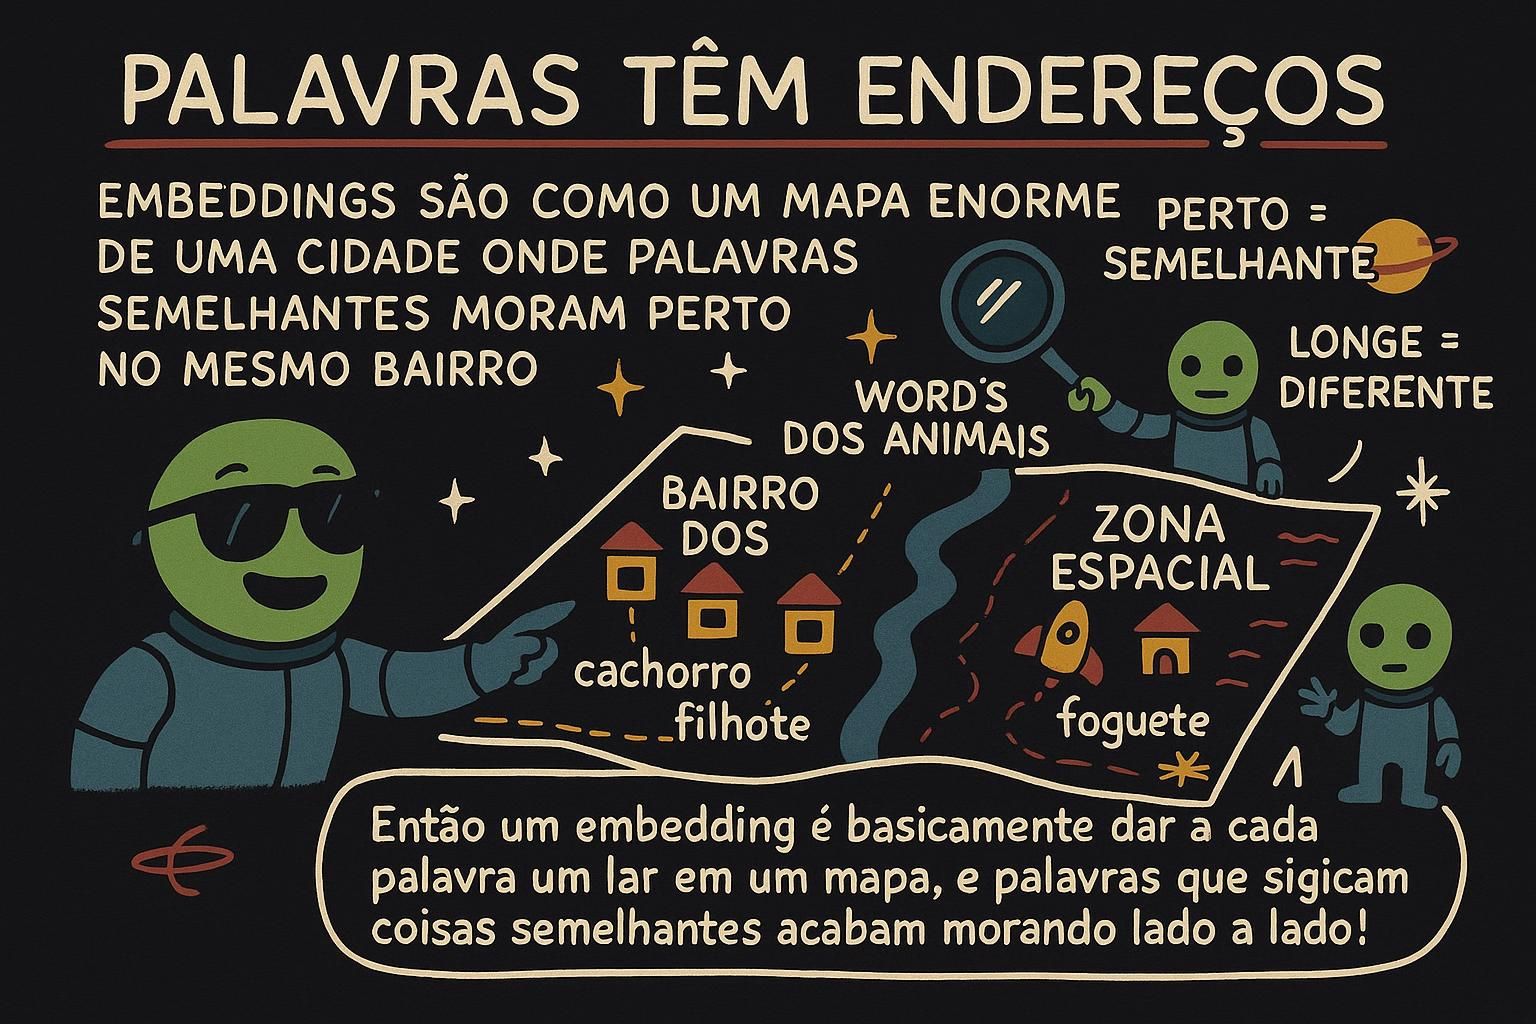
Uma imagem mental aproximada: imagine cada trecho de texto como um ponto no espaço, onde coisas com significados parecidos ficam próximas umas das outras. "Cachorro" e "filhote" caem na mesma vizinhança. "Grampeador" fica do outro lado da cidade. Embeddings reais usam centenas ou milhares de dimensões, não apenas as duas ou três que você consegue imaginar, mas a intuição se mantém: proximidade significa similaridade.

De onde vêm esses números, e por que eles se alinham com o significado? Um modelo de embedding é um primo próximo do modelo de previsão que você viu em Como os LLMs funcionam, treinado com uma quantidade enorme de texto. Para ficar bom na sua tarefa, ele precisou aprender quais palavras e ideias aparecem em contextos parecidos — a velha observação de que você conhece uma palavra pela companhia que ela mantém.

"Cachorro" e "filhote" aparecem nos mesmos tipos de frases, então o modelo aprendeu a representá-los de forma parecida. "Grampeador" mantém outra companhia, então fica em outro lugar. Os centenas de números são direções de significado aprendidas, cada uma capturando algum eixo de como o texto varia, nenhuma delas rotulada de um jeito que um humano conseguiria ler. Você nunca decodifica os números, você só mede o quão próximos dois vetores estão.

JunoTexto como vetores Um embedding é uma lista de números, um vetor, que representa o significado de um trecho de texto, produzido por um modelo treinado com quantidades enormes de texto. Ele aprendeu a colocar palavras e ideias que aparecem em contextos parecidos próximas umas das outras, então significados parecidos geram vetores parecidos. Você nunca lê os números, só mede o quão próximos dois deles estão, e essa proximidade reflete significado.

Você quer uma busca que faça correspondência por significado em vez de ortografia, de modo que "quero meu dinheiro de volta" encontre uma linha sobre reembolsos. A jogada é transformar cada trecho de texto em um vetor, uma lista de números de tamanho fixo em que significados parecidos ficam próximos entre si. Um modelo de embedding lê o texto e produz esse vetor, e o objetivo de tudo isso é que a distância entre vetores represente a similaridade de significado.

O vetor tem um tamanho definido, sua dimensão, geralmente de algumas centenas a alguns milhares de números. Todo texto que você transforma em embedding com o mesmo modelo sai com o mesmo tamanho, e é isso que permite comparar quaisquer dois deles. Essas dimensões são direções de significado aprendidas, não categorias rotuladas por humanos, então você não interpreta a dimensão 47 como "formalidade". Você trata o vetor como um ponto opaco e mede distâncias.

Antes de transformar qualquer coisa de verdade em embedding, há uma etapa que decide se tudo vai funcionar: o chunking. Você raramente transforma um documento inteiro em um único vetor, porque um vetor para um manual de 20 páginas borra todos os tópicos dele em um único ponto médio que não corresponde bem a nada. Em vez disso, você divide o documento em chunks, trechos com aproximadamente um parágrafo a uma página, e transforma cada chunk em embedding separadamente. Transforme chunks em embedding, não documentos inteiros, para que cada vetor carregue uma ideia bem definida.

O tamanho do chunk é um trade-off real que você define de forma deliberada. Chunks muito grandes fazem a média de várias ideias juntas e recuperam resultados vagos. Chunks muito pequenos perdem o contexto ao redor que dava sentido a uma frase. Um ponto de partida comum é algumas centenas de tokens por chunk, com uma pequena sobreposição entre chunks vizinhos, de modo que uma frase dividida por uma fronteira ainda apareça inteira em um deles — depois você ajusta com base no que sua recuperação realmente retorna.

JunoTexto como vetores Um embedding transforma texto em um vetor de tamanho fixo em que a distância representa similaridade de significado, e todo vetor do mesmo modelo compartilha esse tamanho, o que permite compará-los. As dimensões são direções aprendidas, não rótulos, então trate o vetor como um ponto opaco. Aqui está a jogada mais importante: divida seus documentos em trechos do tamanho de um parágrafo e transforme cada chunk em embedding, porque um vetor para um documento inteiro faz a média de tudo até virar uma papa sem sentido.

A busca que faz correspondência por significado se apoia em uma ideia: mapear o texto em um espaço vetorial (um espaço de coordenadas de dimensão fixa em que cada ponto é uma lista de números) de modo que a similaridade semântica se torne proximidade geométrica. Um modelo de embedding é esse mapa: ele lê o texto e retorna um vetor.

Tudo o que você constrói em cima disso — indexação, recuperação, ranqueamento — é geometria sobre esses vetores. Se o mapeamento sair errado, nada depois disso consegue recuperar a situação.

A primeira alavanca de design é o que você transforma em embedding, e isso é o chunking: dividir documentos-fonte em trechos antes de gerar o embedding, em vez de transformar arquivos inteiros. A razão é que um embedding é uma compressão com perdas da sua entrada em um único ponto, então quanto mais ideias distintas um chunk contiver, mais elas se misturam em um centroide vago que não recupera nada com precisão. Ajuste o tamanho do chunk à unidade sobre a qual um usuário vai perguntar, geralmente um trecho de algumas centenas de tokens, com uma pequena sobreposição para que um fato que atravesse uma fronteira sobreviva em pelo menos um chunk.

A estratégia de chunking é onde a qualidade da recuperação é ganha ou perdida, mais até do que a escolha do modelo:

  • Janelas de tamanho fixo são baratas, mas cortam frases no meio do raciocínio.
  • Divisão sensível à estrutura (por títulos, parágrafos ou blocos de código) mantém cada chunk coerente e tende a recuperar melhor, ao custo de um pipeline mais elaborado.

Seja qual for sua escolha, armazene a origem e a posição do chunk junto com seu vetor, porque no momento da recuperação você precisa apontar de volta para de onde um fato veio, e um vetor puro não consegue te dizer isso.

Mais uma propriedade para internalizar: as dimensões de um embedding não são eixos interpretáveis, então você não consegue depurar a recuperação lendo um vetor. Você depura embeddings inspecionando o que eles recuperam, nunca lendo os números. Quando uma consulta traz o chunk errado, o ajuste está no chunking, no modelo ou na consulta, examinados através dos resultados recuperados, não das coordenadas em si.

JunoTexto como vetores Um modelo de embedding mapeia texto em um espaço vetorial em que a similaridade semântica se torna distância geométrica, e toda etapa posterior é geometria sobre esses pontos. O chunking é a alavanca que decide a qualidade da recuperação: dimensione os chunks conforme a unidade sobre a qual o usuário pergunta, divida pela estrutura quando possível, e armazene a origem e a posição de cada chunk junto com seu vetor para que você consiga rastrear um fato até a fonte. Você não consegue ler um vetor para depurá-lo, então quando a recuperação sai errado, inspecione o que voltou, não os números.

Gerando um embedding ​

Você pede o vetor a um modelo de embedding, de um jeito bem parecido com uma chamada de modelo normal, mas com um endpoint e um modelo diferentes.

python
from openai import OpenAI

client = OpenAI()

EMBED_MODEL = "text-embedding-3-small"  # ponto de troca para o modelo de embedding

def embed(text):
    response = client.embeddings.create(model=EMBED_MODEL, input=text)
    return response.data[0].embedding  # uma lista de números

vector = embed("um cachorro pequeno e brincalhão")
print(len(vector))  # ex.: 1536 números

O resultado é uma lista de números. Uma regra importa mais do que todas as outras: sempre compare embeddings gerados pelo mesmo modelo. Vetores de modelos diferentes vivem em espaços diferentes e não são comparáveis, como medidas em unidades diferentes. Misturar modelos gera pontuações sem sentido, sempre.

E, como toda chamada de modelo, você é cobrado por tokens, então transformar uma grande coleção de documentos em embedding tem um custo que vale a pena estimar antes de rodar em milhares de documentos.

JunoGerando um embedding Você gera um embedding chamando um modelo de embedding, que devolve uma lista de números para seu texto. Sempre compare vetores gerados pelo mesmo modelo, porque modelos diferentes produzem vetores que não são comparáveis, como centímetros contra polegadas. O embedding é cobrado por tokens, então uma coleção grande tem um custo real que vale a pena checar antes.

A chamada em si é um endpoint diferente, mas com o mesmo formato de uma chamada de chat: você envia texto, recebe um vetor de volta.

python
from openai import OpenAI

client = OpenAI()

EMBED_MODEL = "text-embedding-3-small"

def embed_batch(texts):
    # envia vários textos em uma requisição, recebe um vetor por texto
    response = client.embeddings.create(model=EMBED_MODEL, input=texts)
    return [item.embedding for item in response.data]

chunks = ["um cachorro pequeno e brincalhão", "um cachorro jovem", "um material de escritório"]
vectors = embed_batch(chunks)  # um vetor por chunk, na mesma ordem de entrada

O formato varia de provedor para provedor, mas a ideia de requisição-e-resposta é a mesma em qualquer lugar. Dois pontos práticos além da chamada básica. Primeiro, gere embeddings em lotes (batches): a maioria dos endpoints aceita uma lista de textos em uma única requisição e retorna um vetor para cada, o que é mais rápido e mais barato do que uma chamada por chunk, porque você paga menos sobrecarga de requisição e bate menos nos limites de taxa. Ao indexar um corpus grande, o batching é o que mantém o custo e o tempo total sob controle.

Segundo, a regra do mesmo modelo tem uma parceira: modelo e dimensão são uma escolha, não um padrão default. Modelos de embedding maiores, com mais dimensões, capturam distinções mais sutis, mas custam mais para calcular, armazenar e comparar. Escolha o menor modelo e a menor dimensão que ainda separem bem seus dados.

Alguns modelos até deixam você pedir um vetor mais curto, trocando um pouco de precisão por armazenamento mais barato e busca mais rápida. Seja qual for a sua escolha, ela se torna um contrato: se você mudar o modelo depois, todo vetor armazenado precisa ser regenerado.

JunoGerando um embedding Gerar um embedding é uma requisição que recebe texto e retorna um vetor, e esse mesmo formato funciona em diferentes provedores. Agrupe seus textos em uma única chamada sempre que possível, porque isso reduz a sobrecarga de requisição e a pressão sobre limites de taxa em um corpus grande. Modelo e dimensão são uma escolha real: escolha o menor que ainda separe bem seus dados, e lembre-se de que o modelo se torna um contrato, já que trocá-lo significa regerar o embedding de tudo que você armazenou.

A superfície da API é pequena. Você envia texto, recebe um vetor de números de ponto flutuante, e as decisões interessantes estão em volta dessa chamada, não dentro dela.

python
from openai import OpenAI

client = OpenAI()

EMBED_MODEL = "text-embedding-3-small"

def embed_batch(texts):
    # uma requisição, vários vetores de volta, na ordem de entrada
    response = client.embeddings.create(model=EMBED_MODEL, input=texts)
    return [item.embedding for item in response.data]

O formato de requisição e resposta varia por provedor, mas todo endpoint de embedding segue esse mesmo contrato: lote de entrada, vetores de saída. O batching não é um luxo em escala, é a diferença entre um job de indexação que termina e um que fica travado a tarde inteira: cada requisição carrega uma sobrecarga fixa e conta contra um limite de taxa, então você amortiza os dois enviando lotes grandes, e depois recua e tenta de novo nas falhas parciais que um job grande vai enfrentar.

Modelo e dimensão são um compromisso arquitetural com consequências de longo prazo. Vetores de dimensão mais alta armazenam mais distinção, mas custam mais em todos os eixos que importam em produção: armazenamento por vetor, memória no índice e tempo por comparação escalam com a dimensão. Alguns modelos suportam embeddings Matryoshka (vetores que você pode truncar para um tamanho menor e ainda usar), que permitem manter vetores completos para precisão e servir um prefixo truncado para uma busca inicial barata. Vale a pena quando seu corpus é grande o suficiente para que armazenamento e latência de consulta, não a qualidade do modelo, sejam o fator limitante.

O compromisso que morde depois é o versionamento. Um embedding armazenado fica atrelado a uma versão exata do modelo, para sempre.

Vetores de duas versões de modelo não são comparáveis, então você não pode transformar uma nova consulta em embedding com um modelo mais novo e comparar com um índice construído com o antigo. O resultado é silencioso: as pontuações parecem plausíveis, mas os rankings estão errados. Trate a versão do modelo como parte do schema do seu índice, armazene-a junto com os vetores, e planeje a regeração de embeddings como uma migração — assunto tratado na discussão sobre atualidade mais adiante neste capítulo.

JunoGerando um embedding A chamada de embedding é um contrato de lote de entrada e vetores de saída, que varia em formato por provedor, mas não na ideia, e o batching com retentativas é o que faz um job de indexação grande terminar em vez de ficar travado. Modelo e dimensão escalam armazenamento, memória e latência de consulta, então recorra a vetores trunca­veis quando a escala, não a qualidade, for o fator limitante. A versão é um compromisso para sempre: vetores de versões de modelo diferentes falham silenciosamente ao serem comparados, então armazene a versão no seu schema e trate a regeração de embeddings como uma migração planejada.

Medindo similaridade ​

Para descobrir o quão relacionados dois trechos de texto estão, você mede o quão próximos seus vetores estão. A medida padrão é a similaridade de cosseno, que retorna um número de -1 a 1: mais próximo de 1 significa mais parecido, próximo de 0 significa sem relação. Você não precisa entender a matemática por trás disso para usá-la. Pense nisso como comparar a direção para onde dois vetores apontam.

A direção é o que carrega o significado aqui, e é por isso que o cosseno compara ângulo em vez de distância bruta. Dois textos sobre reembolsos apontam para o mesmo lugar, seja um uma frase curta ou um parágrafo longo.

python
import math

def cosine_similarity(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    mag_a = math.sqrt(sum(x * x for x in a))
    mag_b = math.sqrt(sum(x * x for x in b))
    return dot / (mag_a * mag_b)

cachorro = embed("um cachorro pequeno e brincalhão")
filhote = embed("um cachorro jovem")
grampeador = embed("um material de escritório para prender papel")

print(cosine_similarity(cachorro, filhote))    # mais alto, os dois têm significado próximo
print(cosine_similarity(cachorro, grampeador))  # mais baixo, os dois não têm relação

Os números confirmam a intuição: cachorro e filhote pontuam mais alto, cachorro e grampeador pontuam mais baixo. Comparar o vetor de uma consulta com vetores armazenados é o coração da busca semântica. Essa única função é a jogada sobre a qual o resto do capítulo se constrói.

JunoMedindo similaridade A similaridade de cosseno pontua o quão próximos dois vetores estão, de -1 a 1, onde mais próximo de 1 significa mais parecido. Você pode usá-la sem entender a matemática, ela compara a direção para onde dois vetores apontam, e é por isso que uma frase curta e um parágrafo longo sobre o mesmo assunto ainda combinam. Comparar o vetor de uma consulta com vetores armazenados é a jogada central da busca semântica.

Você tem vetores, agora precisa de um número que diga o quão próximos dois deles estão. O padrão é a similaridade de cosseno: ela mede o ângulo entre dois vetores, ignorando seu tamanho, e retorna um valor de -1 a 1, onde mais alto significa mais parecido. Ângulo, não distância, é o que você quer, porque um trecho longo e uma frase curta sobre o mesmo assunto devem pontuar como parecidos, mesmo que seus vetores tenham magnitudes diferentes.

python
def dot(a, b):
    return sum(x * y for x, y in zip(a, b))

# se os vetores forem normalizados para tamanho 1, a similaridade de cosseno equivale ao produto escalar
score = dot(query_vector, doc_vector)  # nenhuma divisão necessária

Aqui está a jogada que compensa em escala: normalize seus vetores para tamanho 1 ao armazená-los. Quando todo vetor tem o mesmo tamanho, a divisão na similaridade de cosseno desaparece e a pontuação se torna um simples produto escalar, que é uma multiplicação e uma soma por dimensão, e muito mais rápido de rodar em um conjunto grande. Normalize uma vez no armazenamento, depois compare com um produto escalar. Muitos modelos de embedding já retornam vetores normalizados, mas não assuma isso — verifique.

A outra diferença em relação ao exemplo de brinquedo: você raramente quer só o resultado mais próximo. Você quer recuperação top-k, os k resultados com maior pontuação, geralmente entre três e dez. Um vetor pode ser um quase-acerto enquanto o segundo e o terceiro juntos contêm a resposta, e retornar um conjunto pequeno dá espaço para a próxima etapa trabalhar. Retornar apenas o primeiro descarta um contexto que você vai sentir falta depois.

JunoMedindo similaridade A similaridade de cosseno compara o ângulo entre dois vetores de -1 a 1, ignorando o tamanho, então uma frase curta e um trecho longo sobre o mesmo assunto ainda combinam. Normalize seus vetores para tamanho 1 no momento do armazenamento e a comparação se reduz a um produto escalar rápido, o que faz diferença em um conjunto grande. E recupere top-k, de três a dez resultados, não só o melhor, porque a resposta muitas vezes está espalhada entre os primeiros.

Você precisa de uma métrica de similaridade, e a similaridade de cosseno (o cosseno do ângulo entre dois vetores, variando de -1 a 1) é o padrão porque ignora a magnitude, então o tamanho do documento não afoga o tópico. Essa escolha tem uma consequência de desempenho que vale a pena considerar no design: o cosseno sobre vetores brutos custa um produto escalar mais duas computações de magnitude por comparação, e você paga isso para cada vetor no índice a cada consulta.

python
import numpy as np

# normaliza no momento da escrita, uma vez por vetor
def normalize(v):
    v = np.asarray(v, dtype=np.float32)
    return v / np.linalg.norm(v)

# no momento da consulta, o cosseno sobre vetores normalizados é um único produto matriz-vetor
def search(query_vec, matrix):
    return matrix @ query_vec  # uma pontuação por linha, vetorizado

A otimização é normalizar cada vetor para tamanho unitário no momento da escrita, o que torna a similaridade de cosseno idêntica a um produto escalar e permite pontuar todo o corpus como uma única multiplicação matriz-vetor, em vez de um loop em Python. Normalize no momento da escrita e a similaridade se torna um produto escalar sobre o índice inteiro de uma vez. Essa é a base de força bruta: exata, direta e linear em relação ao tamanho do corpus, o que é adequado até algo em torno de algumas centenas de milhares de vetores e desmorona além disso — o sinal para migrar para um índice aproximado, tratado mais adiante.

Duas realidades de produção que a métrica de brinquedo esconde. Primeiro, você quase nunca quer o argmax, você quer top-k com um limite de pontuação, porque a diferença entre o primeiro e o segundo resultado indica o quanto você pode confiar na correspondência, e um resultado no topo que ainda pontua baixo significa que nada no seu corpus realmente respondeu à consulta. Retorne isso como "nenhuma correspondência boa" em vez de devolver a linha menos ruim. Segundo, a similaridade de cosseno é relativa, não absoluta: uma pontuação de 0,4 só tem significado em relação à distribuição de pontuações que seu corpus e modelo produzem, então calibre os limites empiricamente por índice, em vez de copiar um número mágico de algum blog.

JunoMedindo similaridade A similaridade de cosseno ignora magnitude, então o tamanho não afoga o tópico, mas o cosseno em força bruta é linear em relação ao tamanho do corpus e só se sustenta até algumas centenas de milhares de vetores antes de precisar de um índice aproximado. Normalize no momento da escrita e a métrica se torna um produto escalar que você pode rodar como uma única multiplicação matriz-vetor sobre todo o corpus. Recupere top-k com um limite, trate uma pontuação máxima baixa como ausência de correspondência em vez da linha menos ruim, e calibre esse limite por índice, porque os números são relativos, não absolutos.

Busca semântica ​

Junte as peças e você consegue buscar por significado em vez de por palavras-chave. Transforme seus documentos em embedding uma única vez e armazene os vetores. Quando uma consulta chega, transforme-a em embedding também, depois retorne os documentos cujos vetores estão mais próximos.

python
docs = [
    "Redefina sua senha na página de configurações da conta.",
    "Nossa política de reembolso permite devoluções em até 30 dias.",
    "Entre em contato com o suporte por e-mail para questões de cobrança.",
]

# transforma cada documento em embedding uma única vez, com antecedência
index = [{"text": text, "vector": embed(text)} for text in docs]

def search(query):
    query_vector = embed(query)
    scored = [{"text": item["text"], "score": cosine_similarity(query_vector, item["vector"])} for item in index]
    return sorted(scored, key=lambda x: x["score"], reverse=True)[0]  # a correspondência mais próxima

print(search("como faço para ter meu dinheiro de volta?"))
# retorna a linha sobre política de reembolso, mesmo sem compartilhar palavras-chave com a consulta

A consulta "como faço para ter meu dinheiro de volta?" encontra a linha sobre reembolso mesmo sem compartilhar nenhuma palavra importante com ela. A busca semântica faz correspondência por significado, não por ortografia. A busca por palavras-chave teria perdido isso completamente, porque a consulta e o documento não têm nenhuma palavra importante em comum.

O formato é sempre o mesmo: gere o embedding uma vez e guarde os vetores, gere o embedding da consulta no momento da requisição, pontue, ordene, retorne o mais próximo. Esse é o ciclo de busca semântica, e você vai reutilizá-lo pelo resto desta apostila.

JunoBusca semântica A busca semântica transforma seus documentos em embedding uma única vez e armazena os vetores, depois transforma cada consulta que chega em embedding e retorna os documentos mais próximos por similaridade de cosseno. Ela faz correspondência por significado, então "quero meu dinheiro de volta" encontra uma linha de "política de reembolso" que não compartilha nenhuma palavra-chave. Essa correspondência baseada em significado é algo que a busca por palavras-chave não consegue fazer.

A versão de brinquedo armazena vetores em uma lista Python e pontua todos eles a cada consulta. Isso funciona para uma demonstração e quebra no momento em que seu corpus cresce, porque uma busca linear reexecuta a comparação completa sobre cada vetor para cada consulta, e você também está reconstruindo o índice na memória a cada reinicialização.

A solução é um banco de dados vetorial: um armazenamento construído para guardar vetores e responder "encontre os k mais próximos deste vetor de consulta" rapidamente e a partir do disco. Em vez da sua própria lista e loop, você escreve os vetores uma vez e o banco de dados cuida da busca, da persistência e da atualização de entradas individuais.

python
# o formato varia conforme o banco vetorial, mas o padrão é o mesmo em todo lugar
index.upsert([
    {"id": "doc-1", "vector": embed(chunk), "metadata": {"source": "faq.md", "section": "reembolsos"}}
    for chunk in chunks
])

results = index.query(vector=embed(user_question), top_k=5)  # os 5 mais próximos, não só 1

Duas coisas que o banco de dados oferece que a lista não oferece:

  • Ele retorna resultados top-k em uma única chamada, os vários mais próximos em vez de apenas o melhor, que é o que você realmente alimenta na próxima etapa.
  • Ele armazena metadados junto com cada vetor, o arquivo de origem, a seção, o timestamp, para que um resultado possa apontar de volta para onde veio e você possa filtrar por isso.

Armazene vetores em um banco de dados vetorial, não em uma lista Python, a partir do momento em que você tiver dados de verdade. A lista serve para aprender o mecanismo, não para rodá-lo em produção.

JunoBusca semântica A busca semântica é gerar embedding uma vez, armazenar, gerar embedding da consulta, retornar os mais próximos, mas uma lista Python e um loop só sobrevivem a uma demonstração, porque escanear cada vetor por consulta e reconstruir a cada reinicialização não escala. Migre para um banco de dados vetorial no momento em que você tiver dados de verdade: ele faz busca top-k rápida a partir do disco e armazena metadados junto com cada vetor, para que os resultados apontem de volta para sua origem. A lista ensina o mecanismo, o banco de dados o executa.

O ciclo de referência — gere embedding uma vez, armazene, gere embedding da consulta, pontue, ordene, retorne — está correto e não sobrevive ao contato com escala. Uma busca por força bruta é linear em relação ao tamanho do corpus por consulta, então com um milhão de vetores e qualquer taxa real de consultas você está gastando um segundo de CPU por busca que você não tem disponível. Tudo em busca de produção gira em torno de não comparar a consulta com todos os vetores.

É isso que a busca por vizinhos mais próximos aproximados te dá (ANN: algoritmos que encontram os vetores mais próximos rapidamente, aceitando uma pequena chance de perder um vizinho verdadeiramente mais próximo). Duas famílias dominam:

  • HNSW (Hierarchical Navigable Small World) constrói um grafo em camadas de vetores e o percorre do grosseiro para o fino, oferecendo baixa latência de consulta ao custo de alto uso de memória.
  • IVF (inverted file, ou arquivo invertido) agrupa vetores em clusters e busca apenas nos clusters mais próximos, usando menos memória, mas precisando retreinar seus centros de cluster conforme os dados mudam.

Acima de algumas centenas de milhares de vetores, ANN não é opcional, é o índice. O trade-off que você está ajustando é recall (a fração de vizinhos mais próximos verdadeiros que o índice de fato retorna) contra latência e memória: empurre o recall para 1,0 e as consultas ficam mais lentas, relaxe e você perde chunks relevantes silenciosamente.

O modo de falha que o loop de brinquedo esconde completamente é a atualidade dos dados. Um índice é uma fotografia de um momento, então quando um documento-fonte muda, seu vetor armazenado fica desatualizado e continua sendo recuperado como se estivesse atual. Você precisa de um pipeline de regeração de embeddings acionado por mudança de documento: detecte a edição, refaça o chunking e o embedding daquele documento, e faça upsert dos novos vetores enquanto exclui os antigos, idealmente rastreado por um hash de conteúdo para que você regere o embedding apenas do que de fato mudou, em vez de todo o corpus a cada edição. Vetores desatualizados são o jeito silencioso pelo qual um sistema de recuperação começa a mentir.

A última lacuna é a correspondência exata. A busca vetorial foi construída para deixar isso passar: uma consulta pelo pedido A-10293 ou por um código de erro se transforma em uma região vaga no embedding e pode não trazer à superfície o único documento que contém exatamente essa string. A busca híbrida roda a busca por palavras-chave (que acerta tokens exatos) e a busca vetorial (que acerta significado) juntas e mescla os rankings, de modo que identificadores, nomes e termos raros não se percam no borrão semântico. Recorra a ela sempre que seu corpus contiver coisas que os usuários vão digitar exatamente.

JunoBusca semântica Uma busca por força bruta morre em escala, então acima de algumas centenas de milhares de vetores você roda busca por vizinhos mais próximos aproximados, HNSW para baixa latência com alto uso de memória, ou IVF para o inverso, e você ajusta o recall contra a latência, sabendo que recall mais alto custa velocidade. Construa um pipeline de regeração de embeddings acionado por mudança de documento, com um hash de conteúdo, porque um índice é uma fotografia de um momento e vetores desatualizados são recuperados como se estivessem atuais. E adicione busca híbrida (palavras-chave mais vetor) sempre que os usuários digitarem strings exatas como números de pedido, já que a busca vetorial pura borra exatamente esses casos.

Para que embeddings não servem ​

Embeddings são uma ferramenta de similaridade, não uma ferramenta de raciocínio. Alguns limites para manter em mente, para que você use a ferramenta certa:

  • Eles não fazem correspondência exata. Para encontrar um número de pedido exato ou um código de erro, uma busca simples por palavra-chave ou em banco de dados é melhor.
  • Eles não raciocinam. Eles dizem que duas coisas estão relacionadas, não por quê, e nem se uma segue logicamente da outra.
  • Eles ficam desatualizados. Se seus documentos mudam, você precisa regerar os embeddings deles, ou sua busca vai apontar para conteúdo antigo.

Embeddings encontram o que está relacionado, eles não julgam o que é verdadeiro ou atual. Cada uma dessas lacunas tem uma ferramenta melhor, e saber qual usar é metade da habilidade.

JunoPara que embeddings não servem Embeddings medem similaridade, eles não raciocinam e não fazem correspondência exata. Para um número de pedido exato ou código de erro, use busca por palavra-chave ou em banco de dados. E quando seus documentos mudam, regere os embeddings deles, ou sua busca vai apontar para conteúdo desatualizado.

A armadilha de uma ferramenta que funciona tão bem é querer usá-la para tudo. Três limites marcam onde parar e escolher outra coisa.

Correspondência exata é o primeiro. Embeddings mapeiam um ID de pedido ou um código de erro no mesmo espaço semântico vago de tudo o mais, então A-10293 cai perto de outras strings com formato parecido de pedido, não exatamente sobre si mesma. Para identificadores, códigos e qualquer valor que um usuário digite literalmente, busca por palavra-chave ou em banco de dados é a ferramenta certa, e a busca híbrida (busca por palavra-chave e busca vetorial rodando juntas) é como você obtém as duas coisas ao mesmo tempo.

Raciocínio é o segundo. Similaridade não é inferência: dois chunks pontuando alto significa que eles falam de coisas relacionadas, não que um responde a uma pergunta ou segue logicamente do outro. O raciocínio acontece no modelo para o qual você envia os chunks recuperados, não na recuperação. A recuperação encontra candidatos, o modelo faz o pensamento.

Atualidade é o terceiro, e o que morde em silêncio. Seu índice é uma fotografia de quando você gerou os embeddings, então documentos editados continuam retornando sua redação antiga até você regerar os embeddings. Trate a regeração de embeddings por mudança como parte do sistema, não como algo que você faz manualmente quando alguém percebe que as respostas ficaram erradas.

JunoPara que embeddings não servem Embeddings são uma ferramenta de similaridade, então eles deixam passar correspondências exatas, como IDs de pedido, que precisam de busca por palavra-chave ou de um híbrido dos dois, e eles não raciocinam, isso é o modelo para o qual você envia os chunks que faz. O que morde em silêncio é a atualidade: um índice é uma fotografia de um momento, então documentos editados continuam retornando redação desatualizada até você regerar os embeddings. Construa a regeração de embeddings dentro do sistema, em vez de esperar alguém notar respostas erradas.

Saber onde os embeddings param é o que mantém um sistema de recuperação confiável, e três fronteiras importam em produção.

Correspondência exata é um ponto cego estrutural, não um problema de ajuste fino. Embeddings comprimem a entrada em direção a vizinhanças semânticas, então identificadores, códigos, SKUs e substantivos próprios raros ficam borrados em direção a strings de aparência parecida, em vez de caírem exatamente sobre si mesmos. A busca vetorial pura vai ranquear um quase-acerto acima do acerto exato. A solução é a recuperação híbrida, que combina um índice lexical (palavra-chave ou BM25, um ranqueamento clássico por frequência de termos) com o índice vetorial, de modo que tokens exatos sejam correspondidos exatamente enquanto o significado é correspondido semanticamente, sem você apostar a busca de um pedido na geometria.

Drift é a fronteira que se corrói silenciosamente. Drift de embedding é o descompasso que você tem quando a versão do modelo por trás do seu índice muda: vetores de duas versões ocupam espaços diferentes e não são comparáveis, então uma consulta transformada em embedding com um modelo novo, comparada contra um índice construído com o antigo, retorna resultados sem sentido que parecem plausíveis. Fixe a versão do modelo no schema do seu índice, e trate qualquer atualização de modelo como uma migração completa de regeração de embeddings, não como uma simples substituição, porque não há erro lançado, apenas resultados silenciosamente piores.

Avaliação é a fronteira que as pessoas ignoram até a recuperação já estar falhando. Você não pode julgar de cara se a recuperação está boa, você mede isso: separe um conjunto de consultas com chunks de relevância conhecida e calcule o recall@k (o chunk certo apareceu entre os top k) e a precisão (quanto do que você retornou era relevante). Se você não está medindo recall@k, você não sabe se a recuperação funciona.

Esse conjunto de avaliação também é o que te diz se uma nova estratégia de chunking, modelo, ou ponderação híbrida de fato ajudou, em vez de trocar um conjunto de falhas por outro que você ainda não notou. A qualidade da recuperação é a base sobre a qual o RAG se sustenta, então ela merece um teste real, não um "achismo".

JunoPara que embeddings não servem Embeddings têm um ponto cego estrutural para correspondências exatas, então combine um índice lexical com o vetorial para identificadores e códigos, em vez de confiar na geometria. O drift de embedding é o silencioso: vetores de versões de modelo diferentes não se comparam, então fixe a versão e trate atualizações como uma regeração completa de embeddings. E meça a recuperação com recall@k em um conjunto separado, porque você não pode julgar de cara se ela funciona, e essa avaliação também é como você distingue uma melhoria real de uma mudança lateral.

Na prática ​

O fluxo completo vive na função search acima: transforme um pequeno conjunto de entradas de FAQ em embedding uma vez, depois responda consultas por significado. O padrão é o mesmo em qualquer escala, só o armazenamento muda conforme você cresce.

No próximo capítulo você pega as correspondências mais próximas e as envia para um modelo, de modo que ele responda a partir dos seus documentos em vez de da memória. Essa técnica é o RAG, e ela é construída diretamente sobre o que você fez aqui.

JunoNa prática A busca semântica é todo o fluxo: transforme seus documentos em embedding uma vez, depois, para cada consulta, transforme-a em embedding e retorne as mais próximas por similaridade de cosseno. Envie essas correspondências mais próximas para um modelo, e ele pode responder a partir dos seus documentos em vez da memória. Isso é recuperação, o próximo capítulo, construído diretamente sobre isso.

O mecanismo já está definido: faça o chunking, gere embeddings em lote, armazene em um banco de dados vetorial, recupere top-k por similaridade. O que muda quando você vai para produção é a infraestrutura ao redor: a regeração de embeddings por mudança, os metadados pelos quais você filtra, a versão do modelo que você fixa.

Os chunks recuperados não são o fim. No próximo capítulo você os envia para um modelo como contexto, de modo que ele responda a partir dos seus documentos em vez do seu treinamento congelado. Isso é o RAG, e a qualidade das suas respostas é limitada pela recuperação que você constrói aqui.

JunoNa prática O ciclo é fazer chunking, gerar embeddings em lote, armazenar em um banco de dados vetorial, recuperar top-k, e produção é a infraestrutura em volta disso: regeração de embeddings por mudança, filtros de metadados, uma versão de modelo fixada. Esses chunks recuperados se tornam contexto para um modelo no próximo capítulo, que é o RAG. As respostas dele são apenas tão boas quanto a recuperação que você monta aqui.

Tudo o que vimos aqui — chunking, normalização, indexação ANN, recuperação híbrida, atualidade e avaliação por recall@k — é a camada de recuperação, e é a parte de um sistema de IA que silenciosamente determina se as respostas são boas ou não. O modelo por cima só consegue raciocinar sobre o que a recuperação entrega a ele, então uma resposta errada dita com confiança geralmente é uma falha de recuperação disfarçada de falha de geração.

Essa é a ponte para o próximo capítulo. O RAG é essa camada de recuperação alimentando um modelo com contexto fundamentado, e todo modo de falha que vimos aqui — vetores desatualizados, correspondências exatas perdidas, recall baixo — aparece lá como uma resposta errada. Construa a recuperação para ser medida e mantida atualizada, e o RAG terá algo sólido sobre o qual se apoiar.

JunoNa prática A camada de recuperação, do chunking ao recall@k, é o que decide se as respostas são boas, porque o modelo só raciocina sobre o que a recuperação entrega a ele. Uma resposta errada dita com confiança geralmente é uma falha de recuperação disfarçada, então o vetor desatualizado ou a correspondência exata perdida é o bug real. O RAG do próximo capítulo é essa camada alimentando um modelo, e ele só é tão sólido quanto o que você constrói aqui.