

 The AI Engineer Path
Fine-tuning

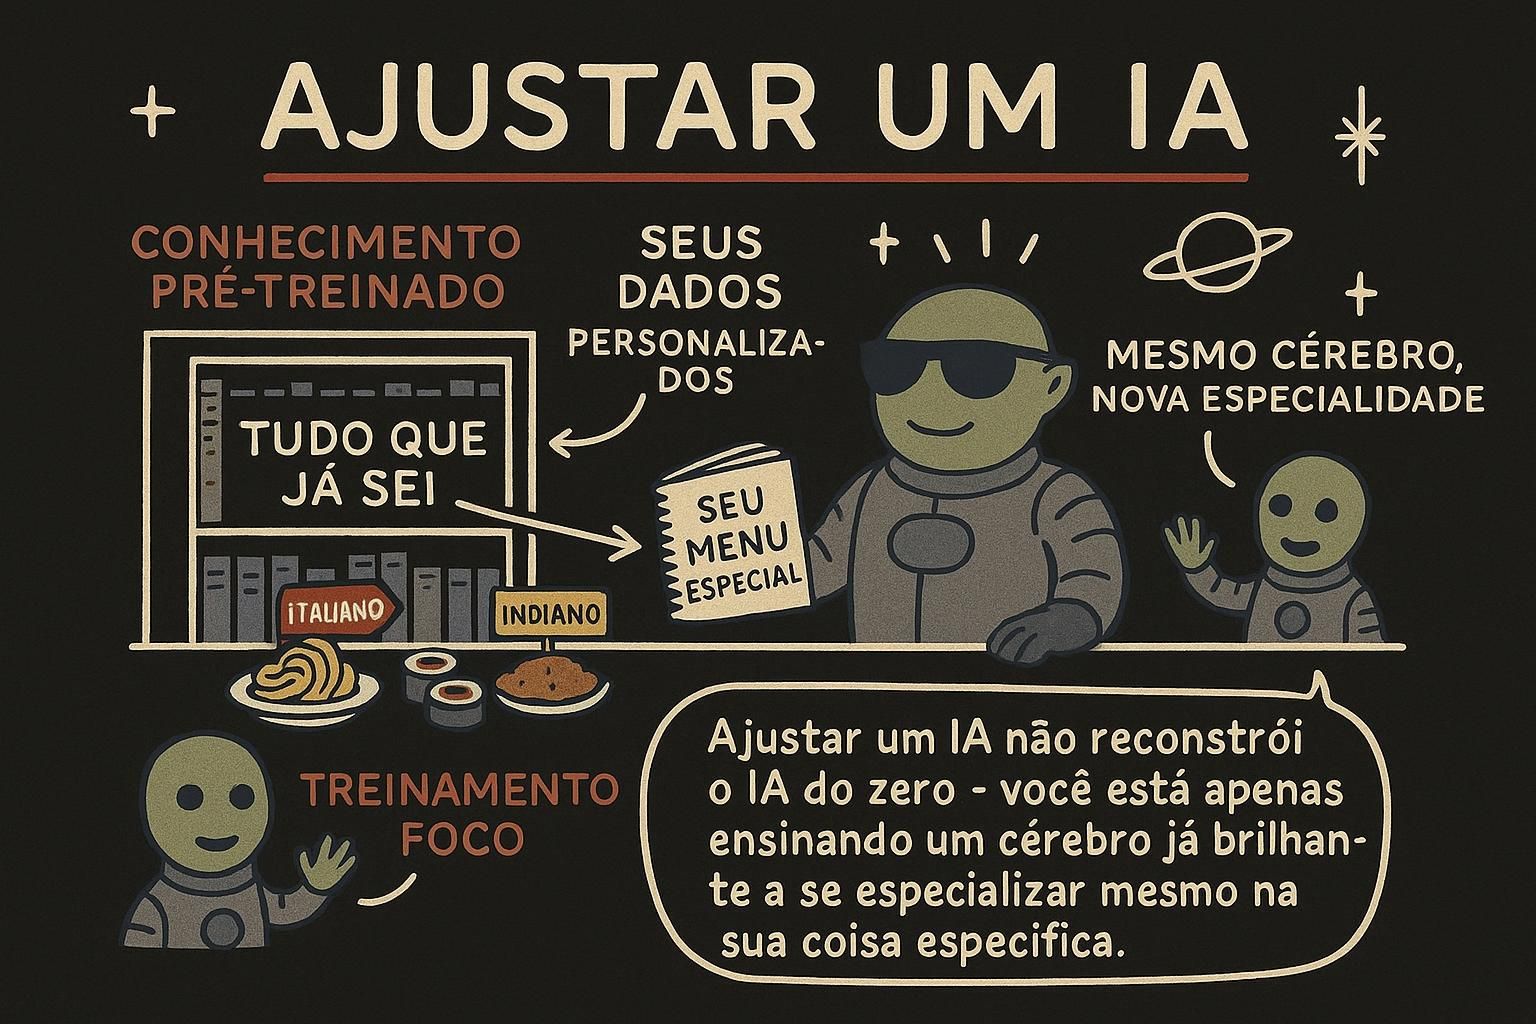
Fine-tuning significa pegar um modelo já existente e continuar treinando-o com seus próprios exemplos, para que seu comportamento padrão se desloque na direção do que você quer. Este capítulo mostra, na prática, o que isso muda, para que serve e quando vale mais a pena recorrer a ele do que a um prompt ou a uma busca por recuperação.
O que o treinamento realmente faz
Para entender o que o fine-tuning muda, ajuda saber de onde um modelo vem. Um modelo é construído em duas grandes etapas.
A primeira é o pré-treinamento: o modelo lê uma quantidade enorme de texto e aprende a prever o próximo token, repetidas vezes, até que gramática, fatos e padrões de raciocínio se instalem nele como efeito colateral. O resultado é um modelo base, fluente mas sem direção. Ele vai continuar seu texto de bom grado, mas não foi ensinado a ser um assistente útil que responde perguntas.
A segunda etapa é o pós-treinamento: o modelo base é treinado ainda mais com exemplos selecionados de boas respostas, junto com feedback humano sobre quais respostas são melhores. É isso que transforma um previsor de texto bruto no assistente que segue instruções com o qual você realmente conversa. O modelo que você chama por uma API já passou pelas duas etapas.
As duas etapas funcionam pelo mesmo mecanismo: mostrar exemplos ao modelo e ajustar seus números internos, seus parâmetros ou pesos, para que suas previsões se aproximem cada vez mais desses exemplos. Treinamento é prática de previsão que deixa o modelo permanentemente mudado.

O que é fine-tuning
Fine-tuning é uma versão pequena e direcionada dessa segunda etapa, executada por você. Você pega um modelo já treinado e continua treinando-o com um conjunto dos seus próprios exemplos, cada um sendo uma entrada combinada com a saída que você gostaria que ele produzisse. Depois de exemplos suficientes, os pesos do modelo se deslocam de modo que esse tipo de resposta se torne o padrão, sem que você precise pedir isso no prompt a cada vez.
A distinção real em relação a prompting e RAG está em onde a mudança acontece. Prompting e RAG deixam o modelo congelado e o direcionam por meio do contexto que você fornece no momento da chamada. Fine-tuning muda o próprio modelo, então o novo comportamento fica incorporado e aparece mesmo com um prompt curto. Você não está dando instruções melhores em tempo de execução; você está entregando um modelo que já tende naturalmente para o que você quer.
Na prática, você entrega ao provedor um arquivo de conversas de exemplo, ele executa um trabalho de treinamento e devolve um novo id de modelo. Você chama esse id exatamente como qualquer outro modelo, exceto que suas respostas agora refletem aquilo com que você treinou. Fine-tuning move o comportamento para dentro do modelo; prompting e RAG direcionam um modelo congelado.
Para que serve e para que não serve
Fine-tuning ganha seu lugar quando você precisa de um comportamento consistente que um prompt tem dificuldade de fixar: um formato de saída preciso todas as vezes, um tom ou estilo específico, ou uma tarefa restrita como classificação feita de forma confiável em milhares de chamadas. Também pode tornar as chamadas mais baratas e rápidas, porque o comportamento que você teria que detalhar em um prompt longo fica embutido no modelo, então seus prompts ficam mais curtos.
Onde ele falha é no conhecimento. Fine-tuning é fraco para ensinar fatos novos a um modelo, e ainda pior para fatos que mudam. Os exemplos de treinamento se misturam em padrões gerais em vez de ficarem armazenados como entradas exatas e consultáveis, então um modelo com fine-tuning continua inventando detalhes e continua ficando desatualizado no instante em que sua informação é atualizada. Retreinar cada vez que um preço ou uma política muda é lento e caro. Quando o problema é "o modelo não sabe X", a resposta é quase sempre RAG, não fine-tuning.
A regra prática: faça fine-tuning para mudar a forma, não para adicionar fatos. Ensine o modelo a responder, e deixe a recuperação de informação cuidar do conteúdo da resposta.
Prompt, RAG ou fine-tuning?
Na maioria das vezes você não começa por aqui. As três técnicas formam uma escada, do mais barato e rápido de mudar para o mais custoso:
- Prompting. Sempre tente isso primeiro. É instantâneo de iterar, não custa nada extra, e um prompt claro com alguns exemplos resolve mais do que as pessoas esperam. Se você ainda não fez o prompt funcionar, não está pronto para fazer fine-tuning.
- RAG. Recorra a isso quando a lacuna é de conhecimento: o modelo precisa de fatos que não tem, ou que mudam com o tempo. RAG fornece esses fatos no momento da pergunta sem tocar no modelo.
- Fine-tuning. Recorra a isso quando a lacuna é de comportamento, não de conhecimento, e o prompting não consegue deixá-lo consistente o suficiente, ou quando seus prompts cresceram tanto que embutir as instruções no modelo é mais barato e mais rápido em escala.
Elas não são mutuamente exclusivas, e os sistemas mais fortes combinam as três: ajuste um modelo para seu formato e tom, depois use RAG para alimentá-lo com fatos atuais em tempo de execução. Comportamento vem do treinamento, conhecimento vem da recuperação.
Então, um teste rápido antes de fazer fine-tuning. Você consegue chegar lá com um prompt melhor? Então faça isso. A lacuna é de conhecimento faltando? Então é RAG.
Suba a escada; fine-tuning é o último degrau, não o primeiro. Só quando o prompt já está certo, os fatos já estão disponíveis, e o modelo ainda não se comporta de forma consistente o suficiente, é que o fine-tuning se torna a ferramenta certa.
Na prática
Os dados de fine-tuning não têm nada de exótico. Cada exemplo é uma conversa curta exatamente no formato que você envia em tempo de execução, terminando com a resposta que você gostaria que o modelo tivesse dado:
# Mostramos apenas alguns exemplos aqui; um conjunto de dados real tem de centenas a milhares de exemplos,
# cobrindo toda a variedade de entradas que você espera em tempo de execução.
training_examples = [
    {"messages": [
        {"role": "system", "content": "Classifique a urgência do chamado como baixa, média ou alta."},
        {"role": "user", "content": "Fui cobrado duas vezes esta semana e preciso resolver isso hoje."},
        {"role": "assistant", "content": "alta"},
    ]},
    {"messages": [
        {"role": "system", "content": "Classifique a urgência do chamado como baixa, média ou alta."},
        {"role": "user", "content": "Existe alguma configuração de modo escuro?"},
        {"role": "assistant", "content": "baixa"},
    ]},
    # ...
]
Você salva isso em um arquivo, inicia um trabalho de treinamento com o provedor e espera terminar. O que volta é um novo id de modelo, que você então chama exatamente como qualquer outro modelo:
# O modelo com fine-tuning é apenas outro id; todo o resto permanece igual.
response = client.chat.completions.create(
    model="sua-org/classificador-urgencia-v1",
    messages=[
        {"role": "system", "content": "Classifique a urgência do chamado como baixa, média ou alta."},
        {"role": "user", "content": "O botão de exportar não faz nada quando eu clico nele."},
    ],
)
# response.choices[0].message.content -> "baixa"  (apenas o rótulo, o comportamento que você treinou)
O ganho é que o comportamento agora vive no modelo. As instruções podem ser mais curtas, o formato se mantém consistente em milhares de chamadas, e você não precisou aumentar o prompt para chegar lá. O custo é tudo em volta disso: você precisa de um conjunto de dados de qualidade, uma rodada de treinamento e um novo trabalho cada vez que quiser mudar o que ele aprendeu, e é exatamente por isso que isso fica na base da escada. Envie exemplos, receba um id de modelo, chame-o como qualquer outro.
Essa é a última das formas de moldar o que um modelo sabe e como ele responde, todas elas deixando-o prevendo texto em uma mesa que você mesmo arrumou. Os próximos capítulos dão a ele a capacidade de agir: em Uso de ferramentas, o modelo chama suas próprias funções, e depois passa a executá-las em um loop como um agente.