Skip to content
This page has been auto-translated and may contain errors.View in English

RAG ​

docs.scrimba.com

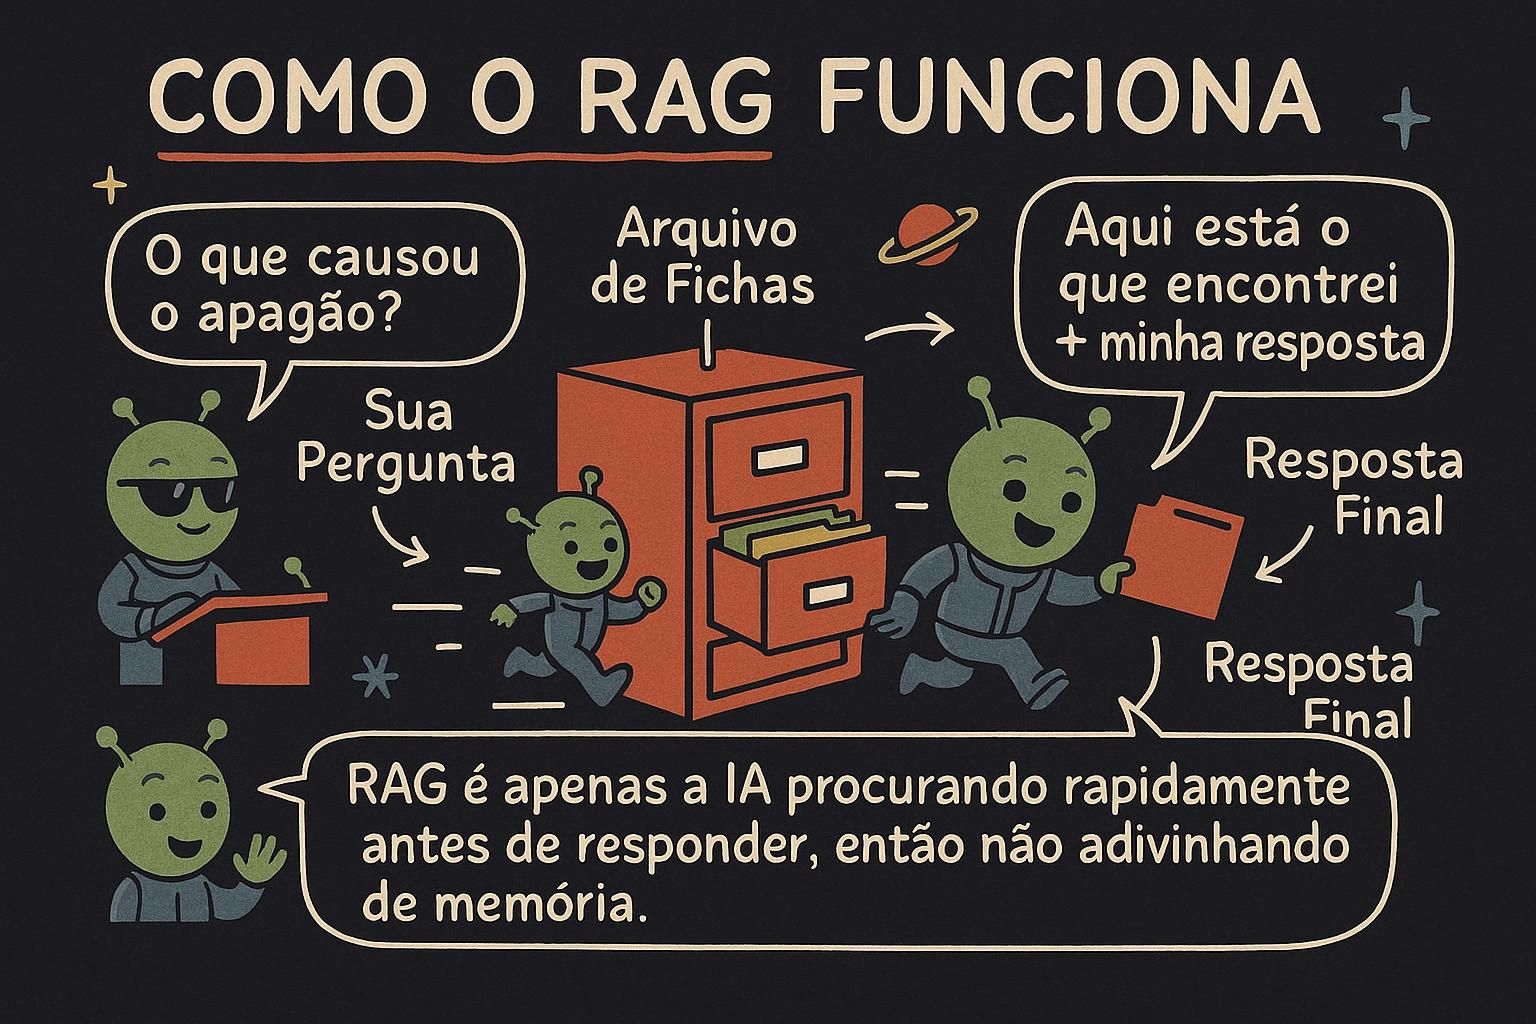
Primeiro, o nome. RAG é a sigla de retrieval-augmented generation (geração aumentada por recuperação): você mesmo busca o texto relevante e entrega ao modelo no momento da pergunta, para que ele responda com base em fatos que você forneceu, em vez de com base numa memória congelada. Este capítulo mostra como funciona esse ciclo de buscar-e-depois-responder e onde ele pode falhar.

O padrão de recuperar e depois gerar ​

Um modelo não conhece os documentos de ajuda da sua empresa, os detalhes do seu produto, ou qualquer coisa que tenha acontecido depois do seu treinamento. Pergunte sobre isso e ele vai admitir que não pode ajudar ou, pior, inventar algo que parece verdadeiro. O RAG resolve isso entregando ao modelo o texto relevante no momento da pergunta.

A ideia se encaixa a partir do momento em que você entende embeddings, o truque que transforma texto em vetores que você pode comparar por proximidade (a similaridade de cosseno mede o quão próximos dois vetores apontam). A geração aumentada por recuperação consiste em duas etapas acopladas a uma chamada normal ao modelo:

  1. Recuperar. Pegue a pergunta do usuário, busque nos seus documentos as partes mais relevantes e reúna as melhores correspondências.
  2. Gerar. Coloque essas partes no prompt como contexto e peça ao modelo para responder à pergunta usando apenas esse contexto.

A capacidade linguística geral do modelo é quem escreve; o texto que você recuperou fornece os fatos. Você obtém respostas fluentes que estão fundamentadas no seu conteúdo e que podem se manter atualizadas, porque você controla o que entra ali.

Ajuda entender por que isso funciona tão bem, em termos do ciclo de previsão. Sem RAG, você está pedindo ao modelo que se lembre de um fato a partir dos padrões congelados em seus parâmetros — fato que ele pode nem ter —, o que leva a um palpite confiante. Com RAG, o fato está ali, bem à mão, no contexto, então a tarefa do modelo muda de "lembre-se disso" para "leia o que está na sua frente e responda com base nisso". A recuperação transfere o trabalho da memória para a leitura. A imagem mais clara é a de uma prova: uma prova sem consulta convida ao palpite, enquanto o RAG a transforma numa prova com consulta, com a página relevante já aberta sobre a mesa.

JunoO padrão de recuperar e depois gerar O RAG adiciona duas etapas a uma chamada normal ao modelo: recuperar os documentos mais relevantes para a pergunta e depois gerar uma resposta usando-os como contexto. O modelo fornece a linguagem, o texto que você recuperou fornece os fatos. Isso permite que ele responda com base no seu conteúdo em vez de na memória, e é justamente isso que impede que ele invente respostas. Demorei um pouco para confiar nisso, mas um modelo "com consulta" realmente chuta muito menos do que um "sem consulta".

Um modelo não carrega os seus documentos de ajuda, os detalhes do seu produto, nem nada posterior ao corte do seu treinamento. Pergunte mesmo assim e você recebe uma recusa ou uma resposta inventada que parece plausível. A geração aumentada por recuperação fecha essa lacuna buscando texto relevante e colocando-o no prompt no momento da requisição, de modo que o modelo leia o fato em vez de tentar se lembrar dele. O mecanismo se apoia em embeddings, em que cada pedaço de texto se torna um vetor e a similaridade é a distância entre vetores (similaridade de cosseno, o cosseno do ângulo entre eles).

O ciclo tem duas etapas:

  1. Recuperar. Transforme a pergunta em embedding no mesmo espaço vetorial dos seus documentos e depois pegue os chunks mais próximos por similaridade.
  2. Gerar. Concatene esses chunks no prompt como contexto e instrua o modelo a responder apenas com base neles.

A etapa de recuperação tem um parâmetro que você ajusta chamado top-k: quantos dos chunks mais próximos você realmente mantém. k é um equilíbrio. Muito pequeno e você perde o chunk que continha a resposta, deixando o modelo sem nada para trabalhar. Muito grande e você enche o contexto de texto vagamente relacionado, o que dilui o sinal, aumenta o custo e agrava o problema de "perdido no meio". Um k entre 3 e 5 é um ponto de partida razoável, e você o ajusta com base em perguntas reais.

Eis a jogada: estruture o índice como uma lista de registros, cada um contendo o texto do chunk e seu vetor pré-calculado, e estruture o prompt de modo que o contexto recuperado fique num bloco claramente delimitado acima da pergunta. A capacidade linguística do modelo escreve; o texto que você recuperou decide o que é verdadeiro.

python
def retrieve(question, index, k=4):
    query_vector = embed(question)
    scored = [
        {"text": item["text"], "score": cosine_similarity(query_vector, item["vector"])}
        for item in index
    ]
    return sorted(scored, key=lambda x: x["score"], reverse=True)[:k]
JunoO padrão de recuperar e depois gerar RAG é recuperar e depois gerar: transforme a pergunta em embedding, pegue os chunks mais próximos, coloque-os no prompt e responda com base neles. O parâmetro que importa aqui é o top-k, o número de chunks que você mantém: poucos demais e você perde a resposta, muitos demais e você a enterra em ruído, ainda pagando o preço por isso. Comece em torno de 3 a 5 e ajuste com base em perguntas reais, não em intuição.

Um modelo não guarda seu corpus privado nem nada posterior ao seu corte de treinamento, e ele não vai te dizer qual é o caso; ele responde com o mesmo tom confiante nos dois casos. A geração aumentada por recuperação é o padrão de buscar texto relevante no momento da requisição e fundamentar a resposta nele, de modo que a correção dependa de uma fonte que você controla, e não de uma recordação paramétrica. Ela roda sobre embeddings: texto mapeado em vetores, ranqueado por similaridade de cosseno (o cosseno do ângulo entre dois vetores, ou seja, proximidade de significado independentemente do tamanho).

O enquadramento em duas etapas, recuperar e depois gerar, está correto, mas esconde onde está o verdadeiro trabalho. A recuperação é um problema de busca disfarçado de geração, e a qualidade de todo o sistema é definida ali, não na chamada ao modelo. Então trate "recuperar-depois-gerar" como "recuperar-ranquear-depois-gerar" desde o início, porque a versão ingênua — transformar a query em embedding, pegar os k mais próximos, colar no prompt — quebra nos modos de falha que os níveis anteriores ainda não encontraram: buscas exatas que falham, chunks quase duplicados que atrapalham a cobertura, e texto obsoleto respondendo com toda confiança.

O primeiro hábito que vale a pena incorporar desde já é entender que isso é um sistema mensurável, não uma questão de intuição. Reserve um conjunto de perguntas reais com os chunks que deveriam respondê-las e acompanhe o recall@k: dos chunks que deveriam ter sido recuperados, a fração que caiu dentro do seu top k. O recall@k é o seu teto. Se o chunk certo não está no contexto, nenhuma técnica de prompt o recupera, e a etapa de geração não consegue responder algo que a recuperação nunca entregou a ela. Tudo o que vem depois está limitado por esse número, então é a primeira coisa a medir e a primeira a melhorar.

python
def retrieve(question, index, k=8):
    query_vector = embed(question)
    scored = [
        {"text": it["text"], "score": cosine_similarity(query_vector, it["vector"]), "meta": it["meta"]}
        for it in index
    ]
    # busca a mais candidatos aqui, depois re-ranqueia para um conjunto final menor (veja abaixo)
    return sorted(scored, key=lambda x: x["score"], reverse=True)[:k]
JunoO padrão de recuperar e depois gerar RAG é um problema de busca disfarçado de geração: a qualidade se define na recuperação, não na chamada ao modelo, então a versão ingênua de "embedar-pegar-k-colar" vai te decepcionar em correspondências exatas e em texto obsoleto. O número que limita tudo é o recall@k, a fração dos chunks que deveriam ter sido recuperados e que realmente entraram no seu top k. Se o chunk certo nunca entra no contexto, nenhum prompt te salva. Meça isso antes de ajustar qualquer outra coisa, ou você estará polindo a ponta errada.

Chunking ​

Você não transforma documentos inteiros em embeddings. Primeiro você os divide em pedaços menores, os chunks, cada um com um parágrafo ou algumas frases, e transforma esses pedaços em embeddings. Duas razões. Primeiro, a recuperação fica mais precisa: você pega o único parágrafo relevante em vez de um manual inteiro de 40 páginas. Segundo, os chunks cabem na janela de contexto, onde um documento gigante talvez não caiba.

python
# um chunker simples: divide por parágrafos
def chunk(text):
    return [c.strip() for c in text.split("\n\n") if c.strip()]

O tamanho do chunk é um equilíbrio, e o motivo remete aos embeddings. Cada chunk se transforma num único vetor que resume todo o seu significado. Se o chunk for muito grande, ele cobre vários tópicos, então seu único vetor é uma média confusa de todos eles, que não corresponde bem a nenhuma pergunta específica. Se for muito pequeno, ele perde o contexto ao redor que era necessário para fazer sentido, então o vetor aponta para um fragmento. Chunks do tamanho de um parágrafo carregam cada um uma ideia coerente. A partir daí, você ajusta com base no desempenho da sua recuperação.

JunoChunking Antes de gerar os embeddings, divida os documentos em chunks menores, mais ou menos do tamanho de um parágrafo, e transforme esses chunks em embeddings. Chunks menores tornam a recuperação mais precisa e cabem melhor na janela de contexto. O tamanho do chunk é um equilíbrio: muito grande é confuso e desperdiça espaço, muito pequeno perde o contexto ao redor. Quando minhas respostas saíam vagas, os chunks quase sempre estavam grandes demais.

Você transforma chunks em embeddings, não documentos inteiros, porque cada chunk se torna um vetor que precisa resumir todo o seu significado. Divida um documento em pedaços do tamanho de um parágrafo e gere o embedding de cada um. Um chunk grande demais faz uma média de vários tópicos num vetor que não corresponde bem a nada; um chunk pequeno demais perde o contexto que dava sentido a ele.

Então trate o tamanho do chunk como um parâmetro a ser ajustado, não como uma regra fixa. Um chunk de algumas centenas de tokens costuma carregar uma única ideia de forma limpa. Esse parâmetro interage com o top-k: chunks maiores significam que menos deles cabem no seu orçamento de contexto, então você leva menos cobertura por requisição. Chunks menores aumentam a precisão, mas exigem um k maior para remontar uma ideia que se espalha por vários deles.

O segundo parâmetro é o overlap (sobreposição): deixe que chunks consecutivos compartilhem um trecho de texto em suas fronteiras, digamos 10 a 20 por cento. Sem overlap, uma frase que responde à pergunta pode acabar dividida numa fronteira, meio num chunk e meio no seguinte, de modo que nenhum dos dois chunks é bem recuperado. O overlap custa alguma duplicação e alguns vetores extras, e em troca resgata as respostas que, de outra forma, as fronteiras teriam cortado em dois.

python
def chunk(text, size=800, overlap=120):
    # tamanho e overlap aqui em caracteres; em sistemas reais, orce em tokens
    out, start = [], 0
    while start < len(text):
        out.append(text[start:start + size])
        start += size - overlap
    return out
JunoChunking Tamanho do chunk e overlap são parâmetros a serem ajustados, não configurações que você acerta de uma vez para sempre. Busque chunks que carreguem uma única ideia, algumas centenas de tokens, e lembre que esse parâmetro compete com o top-k: chunks maiores, menos deles cabem. Adicione 10 a 20 por cento de overlap para que uma resposta que atravesse uma fronteira ainda viva por completo dentro de pelo menos um chunk. As fronteiras são onde a recuperação silenciosamente perde respostas.

É no chunking que o recall da recuperação é ganho ou perdido, antes mesmo de uma única query ser executada. Cada chunk se torna um vetor que precisa representar todo o seu significado, então a forma como você divide decide o que é encontrável. Fronteiras de parágrafo ou seção superam janelas de caracteres fixas quando o documento tem estrutura, porque um vetor sobre uma seção coerente é um alvo de busca mais limpo do que um vetor sobre a metade de duas seções.

Tamanho do chunk e overlap estão acoplados ao seu orçamento como um todo, não são parâmetros livres. O tamanho compete com o top-k e com a janela de contexto: chunks grandes carregam mais contexto cada um, mas menos deles cabem, então a cobertura cai; chunks pequenos aumentam a precisão, mas fragmentam ideias e exigem um k maior para remontá-las, o que custa tokens e reintroduz o problema de "perdido no meio". Um overlap de aproximadamente 10 a 20 por cento resgata respostas que atravessam uma fronteira, ao custo de duplicação no seu índice. Essa duplicação tem um efeito colateral mais adiante: chunks quase idênticos e sobrepostos podem ocupar várias das suas vagas de top-k com o mesmo conteúdo, sufocando a cobertura. Essa é uma das razões pelas quais o re-ranking e a deduplicação ganham seu lugar mais adiante.

O custo que a maioria ignora até doer: a estratégia de chunking fica embutida no seu índice, então mudá-la significa reprocessar os embeddings e reindexar todo o corpus. Isso é computação real, dinheiro real, e uma janela de migração em que vetores antigos e novos não deveriam se misturar. Decida o tamanho do chunk com base nos seus documentos e perguntas reais desde o início, meça o recall@k num conjunto reservado para testes, e trate uma mudança de chunking como uma reindexação deliberada, não como um ajuste de configuração que você publica numa sexta-feira qualquer.

JunoChunking Faça o chunking com base na estrutura, quando ela existir, porque cada chunk é um vetor representando todo o seu significado, e o tamanho compete simultaneamente com o top-k e com a janela. Um overlap de 10 a 20 por cento salva respostas que atravessam fronteiras, mas gera quase duplicados que disputam espaço no seu top-k, o que é parte do motivo de existir o re-ranking. E lembre-se: a escolha de chunking fica embutida no índice, então mudá-la é um reprocessamento e uma reindexação completos, com custo real e uma migração — não um simples ajuste de configuração.

Onde os vetores vivem ​

Para um punhado de chunks, você pode manter os vetores em memória e compará-los usando a função de similaridade de cosseno do capítulo de embeddings, que é exatamente o que o exemplo mais adiante faz. Para milhares ou milhões de chunks, isso fica lento, e você recorre a um vector store: um banco de dados feito para encontrar os vetores mais próximos rapidamente, em escala.

Você não precisa de um para aprender RAG, e não precisa escolher um agora. Existem vários, tanto como serviços hospedados quanto como bibliotecas; o que importa é o conceito: um lugar para armazenar embeddings e buscá-los rapidamente. Comece em memória e migre para um vector store quando a coleção crescer demais.

JunoOnde os vetores vivem Para poucos chunks, mantenha os vetores em memória e compare-os diretamente. Para grandes coleções, um vector store é um banco de dados que encontra os vetores mais próximos rapidamente, em escala. Você não precisa de um para aprender RAG: comece em memória e migre para um vector store quando a coleção crescer demais. Não é preciso sair procurando um banco de dados no primeiro dia.

Para algumas centenas de chunks, os vetores vivem em memória e você pontua cada um deles contra a query. Isso é uma busca linear: tranquila em pequena escala, lenta quando a coleção chega a milhares ou milhões, porque você compara com todos os vetores em cada query. A partir daí, você migra para um vector store, um banco de dados que indexa vetores para uma busca rápida por vizinhos mais próximos.

A assimetria que vale a pena guardar é embedding-uma-vez versus embedding-por-query. Você gera o embedding e indexa cada chunk de documento exatamente uma vez, com antecedência, e esse trabalho é reaproveitado em todas as perguntas futuras. Você gera o embedding da query uma vez por requisição, no momento da requisição, e esse é o único custo de embedding no caminho crítico. Então o custo pesado de indexação é pago adiantado e amortizado; o custo por query é apenas uma chamada de embedding mais uma busca. É isso que torna o RAG barato de servir depois de construído.

Você não precisa escolher um vector store para aprender o padrão. Comece com uma lista de registros em memória, troque por um vector store quando a escala ou a persistência exigir, e mantenha a interface a mesma: gerar embedding da query, buscar, retornar o top-k.

JunoOnde os vetores vivem Em memória você percorre todos os vetores em cada query, o que é tranquilo até a coleção crescer, e então um vector store oferece busca indexada por vizinhos mais próximos. Guarde a assimetria na cabeça: os documentos têm seus embeddings gerados e são indexados uma vez, para sempre reutilizados, enquanto a query tem seu embedding gerado do zero em cada requisição. O custo adiantado é pago uma vez e amortizado, então servir continua barato. Comece em memória e troque por um vector store quando a escala ou a persistência exigirem.

Em memória você faz uma busca linear, pontuando a query contra cada vetor de chunk, o que é exato, mas é O(n) por query e para de escalar em algum ponto na faixa das dezenas de milhares. Um vector store substitui a busca linear por um índice aproximado de vizinhos mais próximos (ANN, approximate nearest-neighbor): ele troca um pouco de recall por um grande ganho de velocidade, evitando checar todos os vetores. Essa troca é um parâmetro ajustável, e em escala de produção você aceita que o índice pode, ocasionalmente, deixar de encontrar um vizinho verdadeiramente mais próximo, o que se reflete diretamente no seu recall@k.

A assimetria de "embedding só uma vez" define o formato do seu custo. A indexação gera embeddings de todo o corpus uma única vez, um grande custo adiantado em lote; o atendimento gera o embedding de uma query e executa uma busca por requisição. Então seu orçamento de latência em regime estável é, grosso modo: gerar o embedding da query, buscar no índice, depois a chamada de geração. A busca costuma ser a menor parcela; a chamada de geração domina a latência, e o embedding da query é um imposto fixo que você paga antes mesmo de poder recuperar qualquer coisa. Vale a pena medir cada trecho, porque as pessoas correm para um vector store mais rápido quando a latência real estava, o tempo todo, na geração.

Depois há a obsolescência (staleness), o modo de falha que o brinquedo em memória nunca mostra. Seu índice é uma fotografia; os documentos-fonte mudam. Uma política muda, um documento é editado, um chunk antigo continua sentado no índice apontando para o passado, e a recuperação o entrega com total confiança. Então um índice não é algo que se escreve uma vez e esquece: você precisa de um caminho de reindexação que reprocesse documentos alterados e, idealmente, de metadados em cada chunk (id da fonte, versão, timestamp) para poder invalidar ou filtrar entradas obsoletas. Decida a cadência de atualização com base na velocidade com que sua verdade muda, e trate "o índice está atualizado" como algo que se verifica, não como algo que se assume.

JunoOnde os vetores vivem Um vector store troca a busca linear exata por um índice aproximado de vizinhos mais próximos: mais rápido, mas pode deixar passar um vizinho verdadeiro, o que se reflete no seu recall@k. O embedding é gerado uma vez para o corpus e uma vez por query, então a latência em regime estável é embedding-da-query mais busca mais geração, e a chamada de geração costuma dominar, então meça antes de culpar o vector store. A armadilha que o brinquedo nunca mostra é a obsolescência: o índice é uma fotografia, as fontes mudam, então construa um caminho de reindexação e marque os chunks com versão e timestamp, em vez de simplesmente confiar que o índice está atualizado.

Fundamentação e citação ​

A etapa de geração é um prompt, e a forma como você o escreve decide se o RAG de fato reduz respostas inventadas. Duas instruções fazem a maior parte do trabalho: diga ao modelo para responder apenas com base no contexto fornecido, e diga a ele para admitir isso quando o contexto não contiver a resposta.

python
context_text = "\n\n".join(retrieved_chunks)

system_prompt = f'''Responda à pergunta usando APENAS o contexto abaixo.
Se o contexto não contiver a resposta, diga "Não tenho essa informação."
Cite a parte relevante do contexto na sua resposta.

Contexto:
"""
{context_text}
"""'''

Isso reúne duas lições anteriores. Os delimitadores e o "responda apenas com base nisto" explícito vêm de prompting. A permissão para dizer "não tenho essa informação" é a defesa contra alucinação: um modelo fundamentado com uma rota de escape inventa muito menos do que um modelo deixado à própria sorte para chutar. Fundamentação mais uma rota de escape é o que reduz respostas inventadas. Pedir para ele citar a fonte também dá aos usuários algo para verificar.

JunoFundamentação e citação A etapa de geração é um prompt, e ela decide se o RAG funciona. Diga ao modelo para responder apenas com base no contexto fornecido e para admitir quando a resposta não estiver lá. Essa fundamentação, junto com a permissão para admitir que não sabe, é o que reduz respostas inventadas. Pedir para ele citar a fonte dá aos usuários algo para checar, e te dá uma pista de quando a recuperação falhou.

A recuperação pode entregar ao modelo um contexto perfeito, e ainda assim o modelo pode ignorá-lo. O prompt de geração é o que amarra a resposta ao contexto, então escreva-o com cuidado: instrua o modelo a responder apenas com base no contexto fornecido, a admitir quando o contexto não contiver a resposta, e a citar o trecho que usou.

python
context_text = "\n\n".join(f"[{i}] {c}" for i, c in enumerate(retrieved_chunks))

system_prompt = f'''Responda usando APENAS o contexto abaixo.
Se a resposta não estiver no contexto, responda exatamente: "Não tenho essa informação."
Cite o(s) número(s) do(s) chunk(s) que usou, como [2].

Contexto:
"""
{context_text}
"""'''

Numerar os chunks transforma "cite a fonte" numa citação que você pode checar de forma programática: o modelo aponta para o chunk [2], e você pode confirmar se o chunk [2] realmente sustenta a afirmação. Essa é a sua alça de controle sobre o modo de falha mais frequentemente ignorado no RAG, a resposta certa com os chunks errados recuperados, em que o modelo produz uma resposta que parece correta, mas que o contexto fornecido não sustenta. Sem citações, você não consegue distinguir uma resposta fundamentada de um palpite feliz.

A rota de escape importa tanto quanto a instrução. Um modelo instruído a responder apenas com base no contexto, mas sem permissão para falhar, ainda vai costurar algo a partir de uma recuperação ruim. Dê a ele uma saída explícita, a string exata "Não tenho essa informação", e uma falha de recuperação aparece como uma lacuna limpa em vez de uma invenção confiante. O formato da mensagem aqui é no estilo OpenAI; o arranjo de sistema-depois-contexto varia de provedor para provedor, mas o princípio se mantém.

JunoFundamentação e citação O prompt de geração amarra a resposta ao contexto: responda apenas com base nele, admita quando ele não tiver a resposta, e cite o chunk. Numere os chunks para que a citação seja verificável, o que pega aquela falha sutil em que a resposta está certa, mas os chunks recuperados nunca a sustentaram. Dê ao modelo a string exata de rota de escape, ou uma recuperação fraca acaba costurada numa resposta errada e confiante. O formato varia por provedor, mas a estrutura de sistema-depois-contexto se mantém.

A fundamentação é o contrato entre a recuperação e o modelo, e é a alavanca de confiabilidade mais barata que você tem, então vale a pena investir o prompt nela. Instrua o modelo a responder apenas com base no contexto fornecido, a retornar uma string fixa de abstenção quando o contexto não sustentar uma resposta, e a citar os ids dos chunks que usou.

python
context_text = "\n\n".join(f"[{c['id']}] {c['text']}" for c in retrieved)

system_prompt = f'''Responda usando APENAS o contexto abaixo.
Se o contexto não sustentar uma resposta, responda exatamente: "Não tenho essa informação."
Para cada afirmação, cite o(s) id(s) do(s) chunk(s) entre colchetes, por exemplo [doc12].

Contexto:
"""
{context_text}
"""'''

Citações não são decoração; são o que torna a fundamentação mensurável. Com ids de chunks na saída, você pode verificar, automaticamente, se um chunk citado realmente contém a afirmação, o que separa uma resposta fundamentada de um palpite fluente. É também assim que você detecta a falha que derruba o RAG ingênuo: a resposta parece plausivelmente correta, mas o contexto recuperado nunca a sustentou, ou seja, a recuperação falhou e o modelo preencheu a lacuna com memória paramétrica. Sem ids, você faz verificações pontuais; com eles, você consegue medir a fundamentação nas suas evals (um conjunto reservado de perguntas com respostas conhecidas como corretas, pontuado automaticamente) e acompanhar a fidelidade como um número.

Duas observações de produção. O caminho de abstenção precisa ser barato e sancionado, porque um modelo sem permissão para falhar sempre vai produzir alguma coisa, e uma recuperação ruim então se transforma numa resposta errada e confiante em vez de numa lacuna limpa. E a estrutura de mensagem aqui segue o formato do SDK da OpenAI; a divisão entre sistema e usuário e a forma como o contexto é anexado variam de provedor para provedor, então trate o arranjo como portável, e os nomes exatos dos campos como não. A regra durável por baixo de tudo isso: nunca deixe o modelo ser a fonte, apenas o formulador de uma fonte que você pode citar e verificar.

JunoFundamentação e citação Fundamentação é o contrato: responda apenas com base no contexto, abstenha-se com uma string fixa, e cite os ids dos chunks para que a fidelidade se torne algo que você mede nas evals, não algo que você estima no olho. Citações são como você pega a resposta que está certa, mas sem sustentação, em que a recuperação falhou e o modelo remendou a lacuna com memória. Mantenha o caminho de abstenção barato e sancionado, ou uma recuperação fraca se transforma numa resposta errada e confiante. O formato varia por provedor; a estrutura se transfere, os nomes dos campos não.

Além dos vizinhos mais próximos: busca híbrida e re-ranking ​

A busca vetorial pura combina por significado, o que é o que você quer na maior parte do tempo. Mas ela tem um ponto cego: pode deixar passar uma palavra exata que importa. Busque por um código de erro como E_4021 ou um nome específico de produto, e uma busca baseada em significado pode devolver chunks que são sobre o mesmo tópico, mas pular justamente aquele que contém a string exata.

A solução tem nome, busca híbrida: combinar busca por significado com a boa e velha busca por palavra-chave, de modo que termos exatos e significado geral tenham, ambos, voz ativa. Você não precisa construir isso para começar com RAG. Recorra a isso quando termos exatos importam e os vetores puros continuam deixando-os passar.

JunoAlém dos vizinhos mais próximos: busca híbrida e re-ranking A busca vetorial combina por significado, o que é ótimo até alguém buscar por um código exato ou um nome de produto e o chunk certo ser deixado de lado. A busca híbrida mistura busca por palavra-chave, para que termos exatos também contem. Você pode começar o RAG sem isso e adicionar quando notar que as falhas de correspondência exata estão se acumulando.

A busca vetorial por vizinhos mais próximos combina por significado, e essa é também a sua fraqueza. Ela pode ranquear um chunk que está topicamente próximo acima do único chunk que contém o token exato que você precisa: um código de erro, um SKU, um nome de função, um substantivo próprio raro. Os embeddings borram tudo isso numa espécie de "essa área aproximada de significado", e strings exatas se perdem nesse borrão.

A busca híbrida executa dois recuperadores e os combina: a busca vetorial por significado, mais uma busca por palavra-chave (busca clássica por termos, muitas vezes BM25, que pontua documentos por quantas das palavras exatas da query eles contêm e por quão raras essas palavras são). Você pega candidatos de ambos e combina os rankings, de modo que um chunk que vença tanto em termos exatos quanto em proximidade semântica possa aparecer. O ganho prático é o recall justamente nas queries em que vetores puros tropeçam.

A segunda técnica é o re-ranking: uma segunda passada que reavalia os candidatos da primeira passada com um modelo mais preciso e mais caro. O padrão é buscar mais do que o necessário e depois estreitar. Recupere um conjunto generoso de forma barata, digamos os 20 melhores, depois execute um re-ranker que lê cada candidato em relação à query e os reordena, e mantenha os 4 melhores para de fato enviar. A recuperação da primeira passada é rápida e grosseira; o re-ranker é lento e preciso, então você só o executa sobre a lista curta. O resultado é um top-k final melhor sem pagar o custo do re-ranker em todo o índice.

JunoAlém dos vizinhos mais próximos: busca híbrida e re-ranking A busca vetorial pura deixa passar strings exatas como códigos de erro e SKUs porque os embeddings as borram numa região de significado. A busca híbrida adiciona correspondência por palavra-chave (BM25) para que termos exatos tenham voz junto com a semântica. Re-ranking é um padrão de "barato-depois-preciso": busque um conjunto amplo de forma rápida, depois repontue a lista curta com um modelo mais lento e mais preciso e mantenha os melhores. Você obtém resultados finais melhores sem executar o pontuador caro sobre tudo.

O vizinho mais próximo aproximado puro é um padrão sólido, mas com uma superfície de falha conhecida. Ele otimiza para proximidade semântica, então tem desempenho pior justamente onde a query depende de um token exato — um código de erro, um identificador, um SKU, um substantivo próprio raro —, porque o embedding comprime esse token numa vizinhança de significado onde strings exatas se misturam. Isso não é um problema de ajuste; é o que vetores densos fazem por natureza.

A busca híbrida resolve isso executando recuperação densa (vetores, significado) junto com recuperação esparsa (correspondência por palavra-chave, tipicamente BM25, que pontua com base na frequência exata do termo, ponderada pela raridade do termo) e fundindo as listas de resultados, comumente com fusão por rank recíproco (reciprocal rank fusion), que combina dois rankings pela posição de cada item, em vez de por scores brutos incomparáveis. O ganho é mensurável como recall@k em queries de correspondência exata, justamente a parcela que a recuperação densa pura silenciosamente deixa cair. O custo é um segundo índice e uma etapa de fusão, então isso compensa exatamente quando seu tráfego inclui identificadores e termos raros, e menos quando é tudo paráfrase em linguagem natural.

O re-ranking ataca uma falha diferente. A recuperação da primeira passada (densa, esparsa ou híbrida) é construída para velocidade sobre um índice grande, então ela ranqueia de forma grosseira. Um re-ranker é um cross-encoder (um modelo que lê a query e um chunk candidato juntos e pontua a relevância deles em conjunto, em vez de comparar dois vetores pré-calculados) que é mais preciso e muito lento demais para rodar sobre o corpus inteiro. Então você busca mais do que o necessário com o recuperador barato, de 20 a 50, depois re-ranqueia essa lista curta e mantém os últimos poucos.

Esse é o ajuste de recall com o maior retorno na maioria dos sistemas RAG em produção: ele ataca diretamente a falha de "resposta certa, chunks errados", promovendo o chunk que realmente sustenta a resposta acima dos meramente relacionados por tópico, e você mede o ganho como recall@k antes versus depois da etapa de re-ranking. Faça o orçamento disso: o re-ranker adiciona latência no caminho crítico e custo por query, então dimensione a busca ampliada em função da sua meta de latência, não de quantos candidatos você poderia, em teoria, se dar ao luxo de pontuar.

JunoAlém dos vizinhos mais próximos: busca híbrida e re-ranking Vetores densos borram tokens exatos, então a busca híbrida executa recuperação esparsa por palavra-chave (BM25) ao lado da densa e funde as listas com fusão por rank recíproco, recuperando recall@k em identificadores e termos raros. O re-ranking é o ganho maior: busque mais do que o necessário de forma barata, depois repontue a lista curta com um cross-encoder que lê query e chunk juntos, e isso corrige diretamente o problema de "resposta certa, chunks errados" ao promover o chunk que sustenta a resposta. Meça o recall@k antes e depois, e coloque no orçamento a latência e o custo por query do re-ranker em relação à sua meta de caminho crítico.

Na prática ​

Uma resposta RAG minimalista, reaproveitando os auxiliares search e embed do capítulo de embeddings:

python
def answer_from_docs(question, index):
    # 1. recuperar: os chunks que melhor correspondem à pergunta
    query_vector = embed(question)
    scored = [{"text": item["text"], "score": cosine_similarity(query_vector, item["vector"])} for item in index]
    top = sorted(scored, key=lambda x: x["score"], reverse=True)[:3]

    # 2. gerar: responder usando apenas esses chunks
    context = "\n\n".join(t["text"] for t in top)
    response = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": f'Responda usando APENAS este contexto. Se não estiver aqui, diga que não sabe.\n\n"""{context}"""'},
            {"role": "user", "content": question},
        ],
    )
    return response.choices[0].message.content

Recupere os três chunks mais próximos, coloque-os no prompt e deixe o modelo responder com base neles. Esse é o pipeline de RAG completo: a busca por embeddings alimentando uma chamada ao modelo, com um prompt fundamentado amarrando tudo. Quase toda a qualidade está em recuperar os chunks certos.

JunoNa prática Uma resposta RAG minimalista é uma busca por embeddings alimentando uma chamada ao modelo: recupere os chunks mais próximos, coloque-os no prompt e peça ao modelo para responder apenas com base neles. A recuperação fornece os fatos e o prompt fundamentado mantém a resposta ancorada a eles. Quase toda a qualidade está em recuperar os chunks certos, então é ali que você deve concentrar seu tempo.

Uma chamada RAG funcional é recuperar, fundamentar, gerar, com a alça de citação de antes conectada:

python
def answer_from_docs(question, index, k=4):
    top = retrieve(question, index, k)  # da seção sobre o padrão
    context = "\n\n".join(f"[{i}] {t['text']}" for i, t in enumerate(top))
    response = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content":
                f'Responda usando APENAS este contexto. Se não estiver aqui, responda '
                f'"Não tenho essa informação." Cite os chunks como [1].\n\n"""{context}"""'},
            {"role": "user", "content": question},
        ],
    )
    return response.choices[0].message.content

O conjunto todo é a busca por embeddings alimentando uma chamada ao modelo, amarrado por um prompt fundamentado. O formato chat.completions é no estilo OpenAI; os papéis das mensagens e a assinatura da chamada variam por provedor, mas o fluxo de recuperar-depois-fundamentar-depois-gerar é o mesmo em todo lugar.

Quando uma resposta está errada, depure na ordem das etapas. Primeiro verifique os chunks recuperados: o texto relevante caiu em top? Se não, o problema está na recuperação — aumente o k, corrija o chunking, adicione busca híbrida ou re-ranking —, não no prompt. Se o chunk certo foi recuperado e a resposta ainda está errada, então é um problema de prompt. Essa ordem evita que você fique ajustando a redação do prompt em torno de um bug de recuperação, o que nunca converge.

JunoNa prática Uma chamada RAG funcional é recuperar, fundamentar com citações, gerar, e o formato de mensagem no estilo OpenAI se transfere para outros provedores na estrutura, se não nos nomes dos campos. Depure numa ordem fixa: olhe primeiro para os chunks recuperados. Se o texto certo nunca caiu ali, corrija a recuperação (k, chunking, híbrida, re-rank), não o prompt. Só depois que o chunk certo estiver no contexto é que uma resposta errada se torna um problema de prompt.

Na prática, o pipeline de recuperar-ranquear-gerar é uma única função, e as partes que você instrumenta são as junções entre etapas:

python
def answer_from_docs(question, index, k_fetch=20, k_final=4):
    candidates = retrieve(question, index, k=k_fetch)   # densa (ou híbrida)
    top = rerank(question, candidates)[:k_final]        # passada com cross-encoder
    context = "\n\n".join(f"[{c['id']}] {c['text']}" for c in top)
    response = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content":
                f'Responda usando APENAS este contexto. Se não for sustentado, responda '
                f'"Não tenho essa informação." Cite os ids como [doc12].\n\n"""{context}"""'},
            {"role": "user", "content": question},
        ],
    )
    return response.choices[0].message.content, [c["id"] for c in top]

Retornar os ids dos chunks junto com a resposta é a jogada que torna o sistema observável: você registra o que foi recuperado, o que foi citado, e se os ids citados realmente sustentam a resposta, o que é o seu sinal de fidelidade nas evals. O formato chat.completions é do SDK da OpenAI; trate o fluxo como portável e os nomes dos campos como específicos do provedor.

O mapa de latência e custo desse pipeline vale a pena ter em mente, porque a otimização deve ir onde está o tempo:

  • O embedding da query é um imposto fixo e pequeno.
  • A recuperação da primeira passada é barata.
  • O re-ranking adiciona um impacto real por query, proporcional ao tamanho da sua busca ampliada.
  • A chamada de geração domina tanto a latência quanto o custo em dinheiro.

Então, antes de correr atrás de um vector store mais rápido, confirme se a busca já foi de fato o gargalo; geralmente era a geração.

E depure as falhas por etapa, em ordem: conjunto recuperado, depois conjunto re-ranqueado, depois citações, depois prompt. Uma resposta errada cujo chunk certo nunca entrou em candidates é um bug de recuperação, e nenhuma mudança de prompt corrige um chunk que nunca esteve lá.

JunoNa prática O pipeline é recuperar, re-ranquear, fundamentar, gerar, e retornar os ids dos chunks junto com a resposta é o que o torna observável: registre o recuperado versus o citado e você pode medir a fidelidade nas evals em vez de estimar no olho. Preste atenção ao mapa de custo — a geração domina latência e dinheiro —, então confirme que a busca era o gargalo antes de trocar de vector store. Depure por etapa, em ordem: recuperado, depois re-ranqueado, depois citado, depois prompt, porque nenhum prompt corrige um chunk que nunca entrou no conjunto de candidatos. O formato é do SDK da OpenAI; o fluxo se transfere, os nomes dos campos não.

Quando você não precisa de RAG ​

RAG não é gratuito, e nem sempre é a resposta certa. Deixe de usá-lo quando:

  • Os dados são pequenos e cabem no prompt. Se toda a sua base de conhecimento tem alguns parágrafos, cole-a direto. RAG serve para quando há mais conteúdo do que se pode enviar de uma vez.
  • Um modelo de contexto longo consegue conter tudo. Alguns modelos aceitam entradas muito grandes, suficientes para receber um documento inteiro de uma vez, o que pode ser menos trabalho do que construir uma recuperação.

E lembre-se do limite real: a qualidade do RAG é, na maior parte, a qualidade da recuperação. Se a etapa de busca devolve os chunks errados, nem um prompt perfeito consegue salvar a resposta. Na maioria dos sistemas RAG reais, o esforço vai para recuperar o texto certo, não para a chamada final ao modelo.

Embeddings e RAG dão ao modelo conhecimento no momento da pergunta, sem nunca mudar o modelo em si. O próximo capítulo, Fine-tuning, aborda a outra opção: mudar o modelo com seus próprios exemplos, e quando isso vale mais a pena do que prompting ou RAG.

JunoQuando você não precisa de RAG Deixe de usar RAG quando seus dados forem pequenos o suficiente para colar no prompt, ou quando um modelo de contexto longo conseguir conter tudo de uma vez. E tenha em mente o limite real: a qualidade do RAG é, na maior parte, a qualidade da recuperação, então, se a busca devolve os chunks errados, nenhum prompt consegue resgatar a resposta. A maior parte do trabalho real está em recuperar o texto certo, não na chamada final.

RAG é infraestrutura — um índice, uma etapa de embedding, uma etapa de recuperação, um caminho de reindexação —, e essa sobrecarga só se justifica quando os dados são grandes demais para enviar e mudam com frequência suficiente para que retreinar não seja uma opção. Deixe de usá-lo quando um formato mais barato resolve:

  • O corpus cabe no prompt. Alguns parágrafos ou um documento de política curto vão direto no contexto. O RAG só se justifica quando há mais conteúdo do que se pode enviar de uma vez.
  • Um modelo de contexto longo contém toda a fonte. Se o documento cabe numa janela grande, enviá-lo por completo pode superar um pipeline de recuperação que você teria que construir e ajustar, embora você pague por esses tokens em toda chamada e ainda enfrente o problema de "perdido no meio".

Guarde o fato governante: a qualidade do RAG é limitada pela qualidade da recuperação. Um prompt perfeito sobre os chunks errados ainda responde errado, então é no índice e na etapa de recuperação que está o trabalho e os ganhos, não na chamada final ao modelo. Quando você precisa mudar o comportamento em vez de fornecer fatos, Fine-tuning é o próximo capítulo, e ele resolve um problema diferente do que o RAG resolve.

JunoQuando você não precisa de RAG RAG é infraestrutura com uma sobrecarga real, então deixe de usá-lo quando o corpus cabe no prompt ou um modelo de contexto longo consegue engolir a fonte toda, lembrando que a rota de contexto longo paga tokens em toda chamada e ainda sofre com o problema de "perdido no meio". O fato governante permanece: a qualidade é limitada pela recuperação, então um prompt perfeito sobre chunks errados ainda responde errado. Invista no índice e na recuperação, não na chamada final.

RAG te dá atualidade e fundamentação ao preço de um sistema de recuperação que você constrói, ajusta, monitora e reindexa. Então a decisão é uma questão de custo-benefício, não algo padrão a ser adotado sempre. Deixe de usá-lo quando um formato mais leve já resolve:

  • Corpus pequeno e estável. Se ele cabe no prompt e raramente muda, coloque-o no contexto, e apoie-se no cache de prompt para que o bloco fixo seja servido de forma barata em chamadas repetidas. Um pipeline de recuperação aqui é sobrecarga sem ganho.
  • Contexto longo, reuso modesto. Se a fonte cabe numa janela grande, enviá-la por completo evita a construção, mas você paga esses tokens de entrada em cada requisição, e o recall ainda se degrada no meio, então isso perde para o RAG conforme o volume ou o tamanho do documento aumenta.

A restrição governante é a mesma que rege todo o capítulo: a qualidade de ponta a ponta é limitada pelo recall@k. Nenhum prompt, nenhuma atualização de modelo, nenhum re-rank recupera um fato que a recuperação nunca colocou no contexto. Então o investimento de engenharia vai para recuperação, chunking, híbrido, re-ranking, evals, reindexação, e a chamada ao modelo é a parte barata de acertar. E mantenha RAG e fine-tuning em suas faixas separadas: a recuperação fornece o que é verdadeiro e se mantém atualizada conforme as fontes mudam, enquanto o fine-tuning molda como o modelo responde e é uma forma obsoleta e sem fonte de injetar fatos. Use recuperação para conhecimento, fine-tuning para forma, e nunca peça a um que faça o trabalho do outro.

JunoQuando você não precisa de RAG RAG te dá atualidade e fundamentação ao preço de um sistema que você constrói e reindexa, então deixe de usá-lo quando o corpus é pequeno e estável (cole-o direto, apoie-se no cache de prompt) ou cabe numa janela longa com reuso modesto. A restrição que rege tudo é o recall@k: nada mais adiante recupera um fato que a recuperação nunca trouxe à tona, então invista na recuperação, não na chamada ao modelo. Mantenha as faixas separadas: recuperação para o que é verdadeiro, fine-tuning para como isso soa, e nunca peça a um que faça o trabalho do outro.