

 The AI Engineer Path
RAG

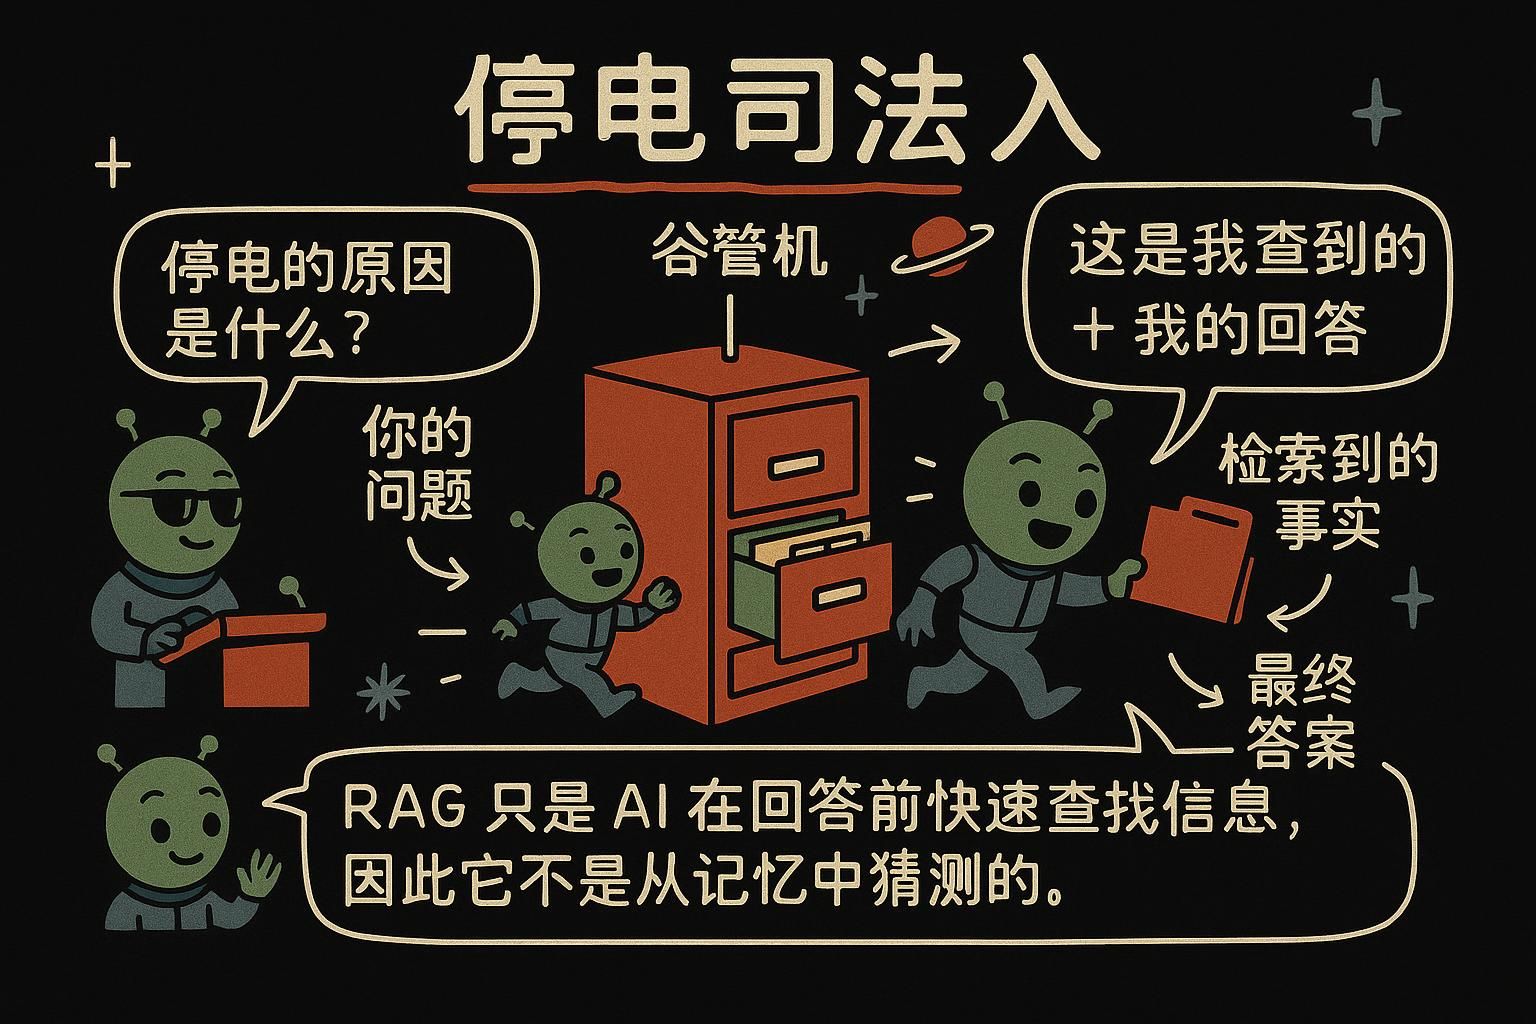
先说说这个名字。RAG 是 retrieval-augmented generation(检索增强生成)的缩写:你自己去找相关的文本,在提问的那一刻把它交给模型,让模型基于你提供的事实来回答,而不是依赖它那些已经"定格"的记忆。这一章要讲的,就是这个"先检索、再回答"的循环是怎么运作的,以及它会在哪里出问题。
先检索、再生成的模式
模型并不知道你公司的帮助文档、你的产品细节,也不知道它训练完成之后发生的任何事情。你要是问它这些,它要么会承认自己不知道,要么更糟——编造一个听起来很像真的答案。RAG 解决这个问题的办法,是在提问的那一刻,把相关文本直接交给模型。
一旦你理解了嵌入(embeddings)——把文本变成向量、再通过"距离"来比较相似度的那个技巧(余弦相似度衡量的就是两个向量指向的接近程度)——这个思路就很容易理解了。检索增强生成 其实就是在正常的模型调用基础上,加了两个步骤:
- 检索。 拿用户的问题,在你的文档里搜索最相关的片段,收集排名靠前的匹配结果。
- 生成。 把这些片段作为上下文放进提示词,然后让模型只根据这些上下文来回答问题。
模型的通用语言能力负责"写",而你检索出来的文本负责提供"事实"。这样你得到的答案既流畅,又扎根于你自己的内容,而且可以保持最新,因为放进去的内容是你自己控制的。
从预测循环的角度来看,就能明白为什么这个方法这么有效。没有 RAG 时,你是在要求模型从它参数中"定格"下来的模式里回忆一个事实——它可能压根没记住,于是就给出一个自信满满的猜测。有了 RAG,事实就摆在上下文里,模型的任务就从"记住这个"变成了"看看眼前的东西,照着回答"。检索把工作从"靠记忆"变成了"靠阅读"。 用考试来比喻最直观:闭卷考试逼着你去猜,而 RAG 把它变成了开卷考试——相关那一页已经摆在桌上打开着了。

分块
你不会把整篇文档拿去嵌入。你要先把它们切成更小的 块(chunks)——每块一段话或几句话,再把这些小块嵌入。原因有两个。第一,检索会更精确:你拉出来的是那一段相关内容,而不是整整一本 40 页的手册。第二,小块能塞进上下文窗口,而一份巨大的文档可能塞不进去。
# 一个简单的分块器:按段落切分
def chunk(text):
return [c.strip() for c in text.split("\n\n") if c.strip()]块的大小是一种平衡,原因要追溯到嵌入(embeddings)。每个块都会变成一个向量,概括它的整体含义。块太大,它就会覆盖好几个话题,那一个向量就成了这些话题的模糊平均值,对任何具体问题都匹配不好。块太小,它就丢失了让它有意义的上下文,向量指向的只是一个片段。段落大小的块,每一块都装着一个连贯的想法。 之后再根据检索效果来调整。
向量存在哪里
如果只是少量的块,你可以把向量留在内存里,用嵌入(embeddings)那一章里的余弦相似度函数来比较——后面的示例就是这么做的。但对于成千上万甚至数百万个块,这样做就会变慢,这时你就需要一个 向量存储(vector store):一种专门用来在大规模数据中快速找到最近向量的数据库。
学习 RAG 并不需要用到向量存储,现在也不用急着选。市面上有不少托管服务和库可以选;重要的是理解这个概念:找个地方存放嵌入向量,并能快速搜索它们。先从内存开始,等数据量超出内存能承受的范围时,再迁移到向量存储。
让答案有依据、能引用出处
生成这一步靠的是提示词,而提示词怎么写,决定了 RAG 到底能不能真正减少胡编乱造的答案。两条指令承担了大部分工作:告诉模型 只能 根据提供的上下文来回答,以及告诉它,当上下文里没有答案时要说明这一点。
context_text = "\n\n".join(retrieved_chunks)

system_prompt = f'''请只根据下面的上下文回答问题。
如果上下文中没有答案,请说"我没有这方面的信息"。
在你的回答中引用上下文的相关部分。

上下文:
"""
{context_text}
"""'''这里把前面学到的两课融合在了一起。分隔符和明确的"只根据这个来回答",来自提示词工程那一章。允许模型说"我没有这方面的信息",则是应对幻觉的手段:一个有依据、又留了退路的模型,比一个被逼着瞎猜的模型编造得少得多。有依据加上留有退路,正是减少编造答案的关键。 要求它引用出处,也给用户提供了一个可以核实的东西。
超越最近邻:混合搜索与重新排序
纯向量搜索靠语义来匹配,大多数时候这正是你想要的。但它有个盲点:它可能漏掉某个关键的确切词。比如搜索一个错误代码,像 E_4021,或者一个具体的产品名称,基于语义的搜索可能会返回一堆同一话题相关的块,却跳过了那个真正包含这个确切字符串的块。
这个问题有个专门的解决办法,叫 混合搜索(hybrid search):把基于语义的搜索和老派的关键词搜索结合起来,让确切的词汇和整体语义都能起作用。刚开始学 RAG 不需要用它。当确切词汇很重要、纯向量搜索又老是漏掉它们时,再用上它。
实际操作
一个最简版的 RAG 答案,复用了嵌入(embeddings)那一章里的 search 和 embed 辅助函数:
def answer_from_docs(question, index):
    # 1. 检索:找出和问题最匹配的几个片段
    query_vector = embed(question)
    scored = [{"text": item["text"], "score": cosine_similarity(query_vector, item["vector"])} for item in index]
    top = sorted(scored, key=lambda x: x["score"], reverse=True)[:3]

    # 2. 生成:只根据这些片段来回答
    context = "\n\n".join(t["text"] for t in top)
    response = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": f'请只根据下面的上下文回答。如果这里没有,就说你不知道。\n\n"""{context}"""'},
            {"role": "user", "content": question},
        ],
    )
    return response.choices[0].message.content
检索三个最接近的块,把它们放进提示词,让模型据此回答。这就是整个 RAG 流程:嵌入(embeddings)搜索给模型调用喂料,靠一个有依据的提示词把它们串在一起。几乎所有的质量都取决于是否检索到了正确的块。
什么时候不需要 RAG
RAG 不是没有成本的,也不是永远的最佳答案。以下情况可以跳过它:
- 数据量小,塞得进提示词。 如果你的整个知识库只有几段文字,直接粘贴进去就行。RAG 是给那种一次塞不进去太多内容的场景用的。
- 一个长上下文模型能装下全部内容。 有些模型接受非常大的输入,足以一次性容纳整篇文档,这可能比搭建一套检索系统省事得多。
还要记住真正的限制:RAG 的质量,主要就是检索的质量。 如果搜索这一步返回了错误的块,再完美的提示词也救不回答案。真实 RAG 系统里,大部分的功夫都花在检索出正确的文本上,而不是花在最后那次模型调用上。
嵌入和 RAG 让模型在提问的那一刻获得知识,却完全不用改变模型本身。下一章微调(Fine-tuning)讲的是另一个选项:用你自己的示例去改变模型,以及在什么情况下这比提示词或 RAG 更值得。