

 The AI Engineer Path
从代码中调用模型

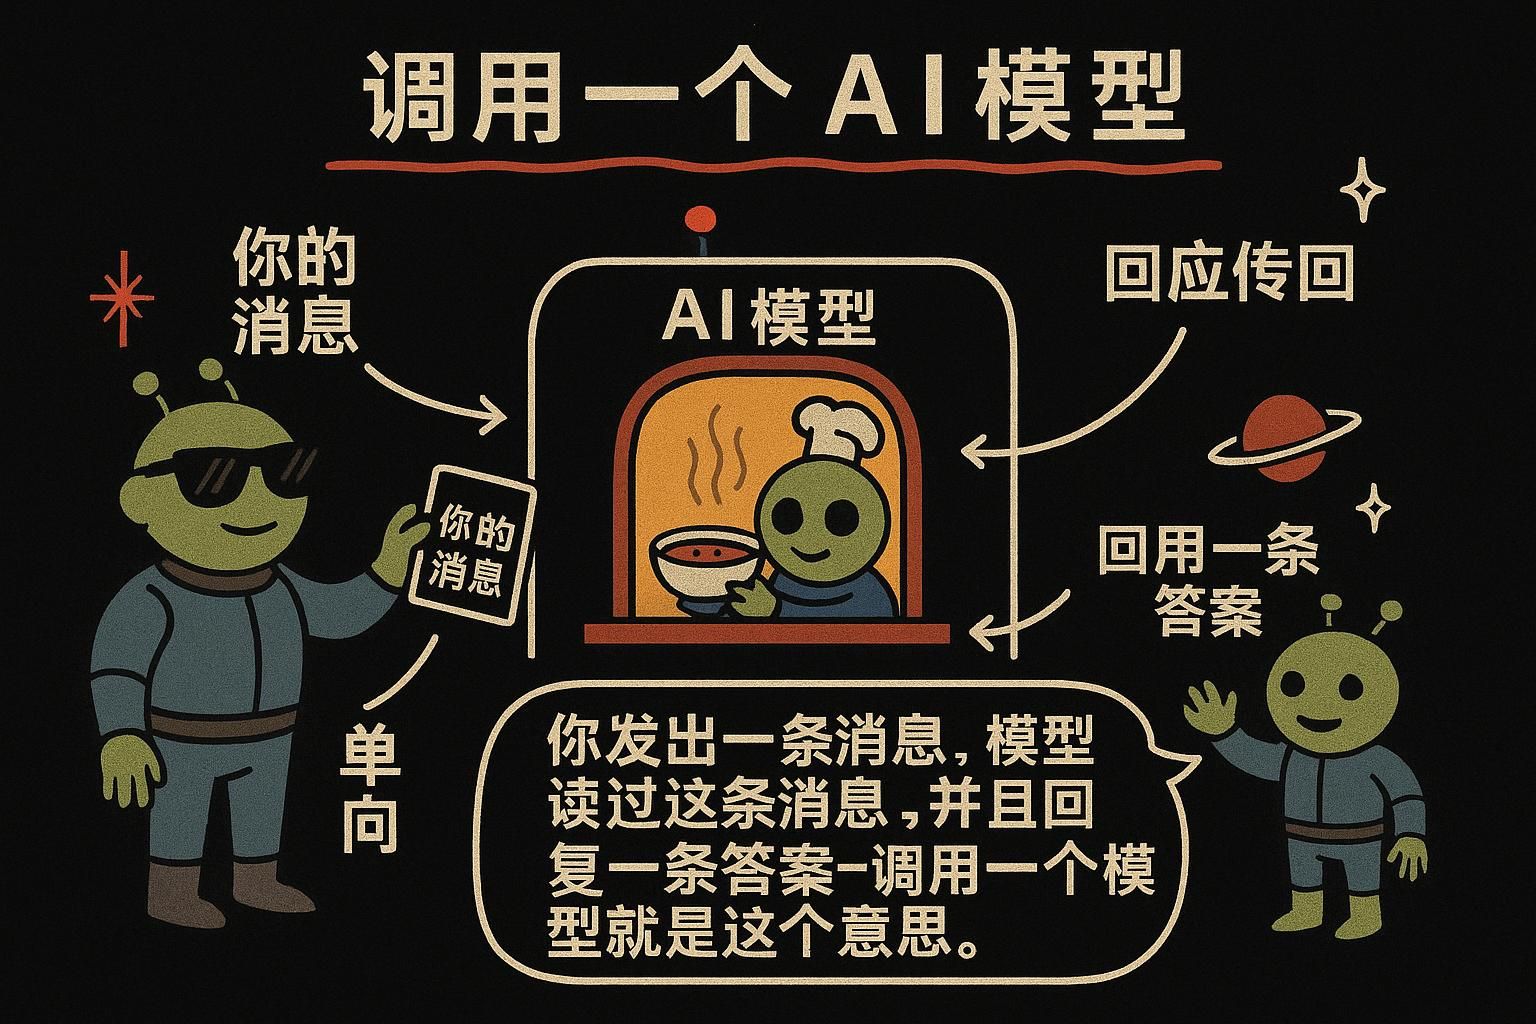
上一章我们把一组消息组装了出来。这一章要做的是把这组消息从 Python 发给真正的模型,并拿到回答。这一来一回,就是用这些模型做开发的最小完整闭环,你日后写的几乎每个功能都建立在这个基础之上。
你输入一段提示词,代码把它发送出去,文字就传了回来。这种体验会让人觉得模型就住在你的程序里。但事实并非如此,搞清楚它到底在哪里运行,能解释清楚成本、速度以及你会遇到的种种奇怪之处。
所以想象一下实际发生的事情。模型是一大堆参数,存放在服务商的服务器上,跑在你永远不会接触到的硬件上。你调用它时,代码只是通过互联网发送了一个普通的网络请求,里面装着你的消息。
服务商在自己的机器上运行预测循环,再把生成的 token 发回给你。调用一次模型,本质上就是在别人的电脑上租用了片刻时间。 这个理解方式能解释很多现象:延迟就是模型在对方那边一个个生成 token 所花的时间,成本就是对方对这些算力的收费,而整件事从头到尾都是一次网络调用,网络调用会有的问题它都会有。
下面的示例用的是 OpenAI 官方库。其他服务商在细节上会有所不同,但整体结构在各家几乎都一样:你发送一组消息,拿回一条消息。正是这种一致性给了你不被某家服务商锁死的保障——同样的代码稍微改一下 base URL,就能指向你自己托管或从别处租用的开放模型(开放模型与闭源模型一章会讲到这个选择)。
请求
用 pip install openai 装好库,创建一个客户端,然后调用它。客户端会从环境变量里读取你的 API key,这样密钥就永远不会出现在你的代码里。
from openai import OpenAI

client = OpenAI()  # 从环境变量中读取 OPENAI_API_KEY

MODEL = "gpt-4o-mini"  # 想换模型时只需要改这一行

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": "You are a concise assistant. Answer in one sentence."},
        {"role": "user", "content": "Why is the sky blue?"},
    ],
)必须要有的只有两样:model,也就是你想要运行的模型名称;messages,也就是上一章讲的那种带角色标签的消息列表。其余的都有默认值。
注意模型名称放在一个单独的常量里。在这个领域,每隔几个月就会出现更好、更便宜的模型,这样安排是有意为之的。把**模型名称**统一放在一个地方,换模型时改一行代码就行。 这正是应对变动的实际做法:把容易变化的细节放在你随时能找到的地方,而不是散落在代码各处。

model 和 messages。模型名称应该放在一个常量里,因为每隔几个月就会冒出一个更便宜或更好的模型,你不会想到处翻代码去改它。这个教训我是吃了亏才学到的——有次一个模型改了名字,我发现它被粘贴在了九个文件里。 读取响应
返回的结果会被包在一层结构里。你想要的文字只是其中一条路径,但了解剩下的结构也值得,因为它告诉你发生了什么。
choice = response.choices[0]

print(choice.message.content)   # 回复的文字
print(choice.finish_reason)     # "stop"  -> 模型自己结束了生成
print(response.usage) # Usage(prompt_tokens=24, completion_tokens=18, total_tokens=42)这里面有三样东西值得关注。message.content 就是文字内容,放在 choices[0] 里面,是因为 API 本来可以返回不止一个选项,不过你几乎总是只要一个,读第一个就行。
finish_reason 告诉你模型为什么停下来。"stop" 表示它自然说完了想说的话,而 "length" 表示它撞上了你设的 token 上限,回答在中途被截断了。检查这个字段,就是让代码而不是靠肉眼去发现回复被截断的方式。
而 usage 报告的是这次调用花掉的token,分成你发送的提示部分和它生成的回复部分。这个 usage 对象,就是你的详细账单。 每次调用都会准确告诉你花了多少 token,而这正是你在开发过程中要盯紧的数字。
response.choices[0].message.content,但旁边两个字段也很重要。finish_reason 告诉你为什么停下:"stop" 表示完成,"length" 表示撞上了你的 token 上限被截断了。而 response.usage 就是你的 token 账单,提示和补全分开算,你永远不用猜一次调用花了多少钱。 值得了解的几个参数
除了 model 和 messages,还有两个可选设置经常会用到。
temperature 就是大模型是怎么工作的一章里讲的那个随机性旋钮,在这里变得具体起来。数值低(接近 0)会让模型紧贴着它最有把握的选项:结果集中、可复现,适合用在信息抽取和分类这类任务上。数值高一些(大约 0.7 到 1)会让模型愿意去尝试不太常见的 token:结果更多样、更有创意,但也更容易跑偏。你调的其实是模型采样时敢冒多大的险,仅此而已。
max_tokens 限制了回复最多能生成多少 token。它能保护你不至于遇到失控的回答和失控的账单。max_tokens 设得太低,模型的回答就会被截断,这正是上一节讲的 "length" 结束原因,所以要留足够的余量。
response = client.chat.completions.create(
    model=MODEL,
    messages=messages,
    temperature=0.2,  # 集中且稳定
    max_tokens=300,   # 限制回复长度
)temperature 调的是模型采样时敢冒多大的险:低值适合稳定、可复现的答案,高值适合多样、有创意的答案。max_tokens 限制回复长度以保护你的账单,但设得太低会触发 "length" 截断,所以要留够余量。做信息抽取和分类,每次都用低 temperature。 流式输出
默认情况下,你要等整个答案生成完毕,才会一次性收到全部内容。因为模型是一个个生成 token 的,回复越长,你盯着空白等待的时间就越长。
**流式输出**会在每个 token 一生成出来就立刻发给你,所以文字会立即出现,并且是边生成边填充,就像聊天应用里那种回复逐字打出来的效果。
stream = client.chat.completions.create(
    model=MODEL,
    messages=messages,
    stream=True,
)

for chunk in stream:
    piece = chunk.choices[0].delta.content
    if piece:
        print(piece, end="", flush=True)
不管用不用流式输出,总的生成时间都是一样的;模型本身并没有变快。流式输出改变的只是你看到 token 的时机——生成出来就立刻展示,而不是憋到最后才一起给你。
处理方式就是遍历这些 chunk,把每个 delta 里的文字打印出来。代价是多写一点代码,换来一次好得多的等待体验。流式输出改变的是你何时看到 token,而不是它们到达的速度。
delta,更早地看到了这些 token。 每次调用都是独立的
这是本章最重要的行为特性,而且它直接源于上下文窗口那一课的内容。这个 API 是**无状态**的:每个请求都完全独立存在。服务商的服务器不会记得你上一次调用了什么。它只会针对你这次发送的消息运行一遍预测,返回结果,然后把这次交互的一切都忘得一干二净,不会为下一次留下任何痕迹。
所以对话内容不会被模型或 API 存在任何地方。它存在于你的代码里。如果你希望第二轮对话知道第一轮发生了什么,你就得自己维护那份不断累积的消息列表,并且每次都把整份东西重新发送一遍。一来一回的对话感,其实是你通过每次调用都重新发送一份不断增长的历史记录,人为制造出来的一种错觉。
这也是为什么长对话每条消息的成本会随着时间推移越来越高:每次调用都要把之前所有轮次重新作为输入 token 发送一遍,所以即便用户这次的新问题很短,提示词的总长度也会一直增长。
history = [
    {"role": "system", "content": "You are a friendly travel assistant. Keep answers short."},
]

def chat(user_text):
    history.append({"role": "user", "content": user_text})

    # 每次都会把整份历史记录发上去;服务器什么都不记得
    response = client.chat.completions.create(model=MODEL, messages=history)
    reply = response.choices[0].message.content

    history.append({"role": "assistant", "content": reply})  # 把回复留着,供下一轮使用
    return reply

chat("I have a weekend in Lisbon. What should I see?")
chat("Which of those is best for kids?")  # 之所以能成立,只是因为 history 里带着第一轮的内容
第二个问题之所以能说得通,只是因为第一个问题和它的答案还留在 history 里,并且被一起发送了出去。你自己,就是这份"记忆"。 这一个道理——你要在每次独立调用之前自己组装并重新发送完整的上下文——是对话功能的基础,后面工具调用、检索以及智能体(agent)也都建立在这个道理之上。它们其实都只是在决定,每次独立调用之前那份 messages 列表里到底该放什么。
出问题的时候
一次模型调用是发向别人服务器的网络调用,所以网络调用会出的所有问题,它都可能出。从一开始就要为此做好设计。
- 错误和速率限制。 服务商会限制你在一个时间窗口内能发送多少请求。一旦超过限制,调用就会因速率限制错误而失败。标准的应对方式是等待后重试,并且每次失败后把等待时间拉长(这叫做**退避(backoff)**),这样你就不会一直去冲击一个本来就很忙的服务。
- 超时。 调用可能会卡住不动。设置超时时间,不要让一个缓慢的请求拖垮你的整个应用。
- 密钥要留在服务器端。 你的 API key 就是一个能花掉你钱的密码。永远不要把 API key 放进浏览器端代码里。 任何人都可以打开开发者工具把它读出来。浏览器应该和你的后端通信,由持有密钥的后端去和模型通信。
- 假设任何答案都可能是错的。 即便调用成功了,返回的也可能是幻觉或格式不对的内容,所以接下来几章的内容都是关于如何让结果变成你的代码能够信任的东西。
def ask_model(messages):
    try:
        response = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            timeout=20,  # 20 秒后放弃
        )
        return response.choices[0].message.content
    except Exception as err:
        print("Model call failed:", err)
        return "Sorry, something went wrong. Please try again."