

 The AI Engineer Path
提示词工程

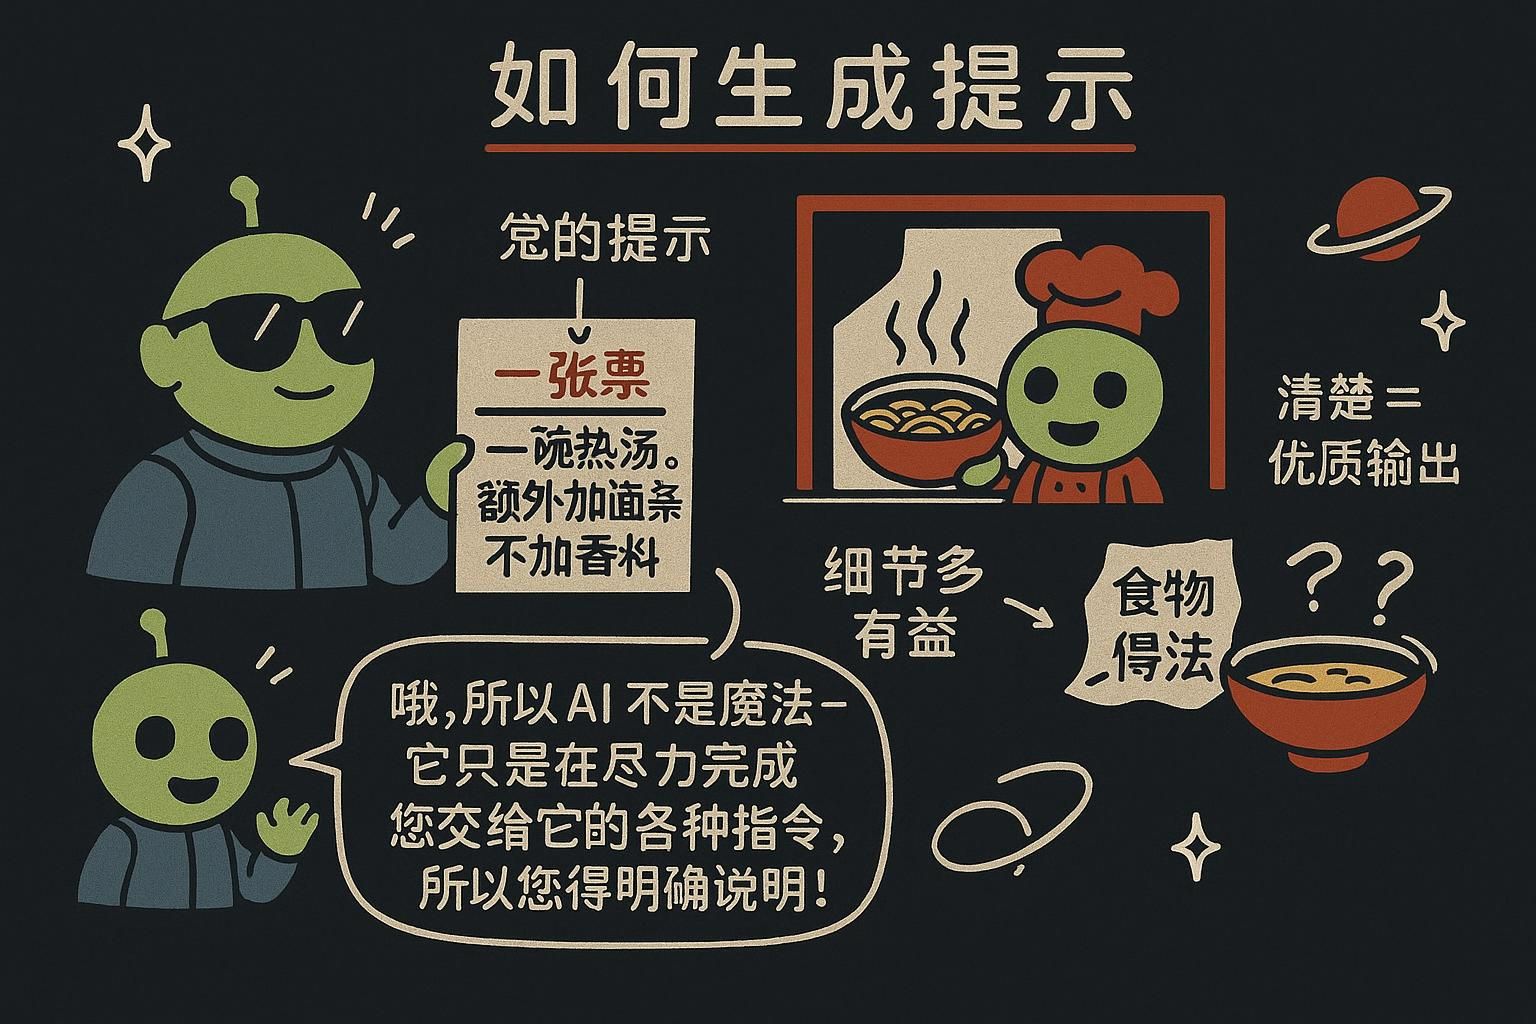
提示词就是你在模型开始预测之前放在它面前的文本。这一章要讲透的核心就是这一点:提示词不是你对一个"心智"下达的命令,而是你精心布置的**上下文**,目的是让你想要的答案变成最可能出现的续写内容。
提示词到底是什么
同一个模型,两个提示词。"写一写气候变化"会给你一篇你没要求过的、漫无目的的文章。"给12岁的孩子写三句话,说明气候变化的主要原因,不要统计数字"则会给你一个能直接拿去用的结果。这两次调用之间,模型本身没有任何变化。变的是上下文,输出也随之改变。
上一章讲过模型如何根据眼前的一切来预测最可能的下一个词元。而提示词,正是那"眼前的一切"。这个定义值得你牢牢记住:提示词不是你向某个人提出的请求,而是你搭建出来的**上下文**,目的是让你期望的续写内容成为模型认为最可能的那一个。
这种重新理解会改变你写提示词的方式。你不是在说服或指挥某个人,而是在编排文本,让你想要的答案变成大概率会出现的下一句话。这一章讲到的每一种技巧,都是实现这一点的不同方式,一旦你能看清背后这台预测机器的运作原理,每种技巧也就都说得通了。

三种角色
当你通过代码和模型对话时,你发送的不是一整块文本,而是一份**消息(messages)列表,每条消息都带有一个标记来源的角色(role)**。一共有三种:
- system(系统):你的常设指令。模型应该扮演谁,遵循什么规则,你想要什么格式。只设置一次,作用于整段对话。
- user(用户):使用你的应用的人发出的消息。也就是真正的请求。
- assistant(助手):模型之前生成的消息。这是对话保留历史记录的方式。
messages = [
    {"role": "system", "content": "You are a concise assistant for a cooking app. Answer in one sentence."},
    {"role": "user", "content": "What can I use instead of butter in cookies?"},
]
在底层,这些角色并不是通向模型的独立通道。它们会被压平成一整条文本流,每条消息前后加上特殊的标记词元,模型的预测就是基于这整条流进行的。角色之所以重要,是因为模型在训练时接触的对话就是按这种方式排列的,所以它学会了把 system 里的内容当作权威的常设规则,把 user 里的内容当作要回答的请求。
系统消息是初学者最容易低估的部分。它是你设定每一轮对话都要遵守的行为准则的地方:语气、受众、格式,以及模型绝对不该做的事。把持久的规则放在这里,把具体的请求放进用户消息。
因为模型在两次请求之间没有记忆,assistant 角色也是你重现之前对话内容的方式:要延续一段对话,你需要把之前的交流以 assistant 和 user 消息的形式重新发送回去。等你开始从代码中调用模型时会更详细地讲到这一点。
system、user 或 assistant。这些标签会被压平成一条文本流供模型预测,但模型在训练时学会了把 system 当作权威规则,把 user 当作要处理的请求。把持久指令放进 system,具体请求放进 user,用重发之前的 assistant 和 user 消息来延续对话的历史。 具体胜过模糊
两个提示词,一个模型。"写一写气候变化"返回一篇长度和语气都不可预测的泛泛文章。"给12岁的孩子写三句话总结气候变化的主要原因,用平实的语言,不要统计数字"返回的东西几乎就是你想要的样子。同一台机器,输出天差地别,唯一的区别就在于你把要求钉得有多死。
原因要追溯到那个预测循环。模型在每一步都是从一堆可能的续写内容中做选择。模糊的提示词会让这个选择范围保持很宽,于是模型就用最常见的通用内容来填补空白,而那几乎从来不是你脑子里真正想要的那个东西。**具体**的提示词会在模型写下第一个词元之前,就把这个选择范围收窄到你想要的答案附近。
# 模糊:模型自己决定长度、语气、受众和格式
"Write about climate change."

# 具体:由你来决定
(
    "Write a 3-sentence summary of the main causes of climate change, "
    "for a 12-year-old, in plain language, with no statistics."
)
模糊的版本可以朝一千种合理的方向续写下去,而你得到的只是其中随机的一种。具体的版本提前排除了几乎所有这些可能性。写提示词时,把你真正想要的东西说清楚:
- 格式:一句话、一份列表、JSON、一张表格。
- 长度:一段话、三个要点、不超过50字。
- 受众:初学者、专家、12岁的孩子。
- 不确定时该怎么做:"如果文本没有提到,就回复'未提及',不要瞎猜。"
最后这一条的分量比看起来要重得多。任其自由发挥的话,模型会用一个自信满满的猜测来填补空白,因为一个流畅的猜测正是最可能出现的续写内容。而明确给它"我不知道"这个选项,会让这个选项变成更大概率会走的路,这也是少数能够缓解上一章提到的幻觉问题的提示词层面的手段之一。具体性能在模型写下任何一个词元之前,就先把它的选项收窄。
用示例展示给它看
有时候,铺垫出正确续写内容最清晰的方式,就是直接展示给模型看。在提示词里放几个已经完成的示例,这种方法叫**少样本提示(few-shot prompting)(不给示例则叫零样本,zero-shot**)。它之所以有效,是因为模型骨子里就是一个"模式续写器":给它两三个"输入-正确输出"的示例,那么最可能出现的下一步内容,就是把同样的模式套用到你的新输入上。
messages = [
    {"role": "system", "content": "Label each review as POSITIVE, NEGATIVE, or NEUTRAL. Reply with only the label."},
    {"role": "user", "content": "The food was cold and slow to arrive."},
    {"role": "assistant", "content": "NEGATIVE"},
    {"role": "user", "content": "Decent meal, nothing special."},
    {"role": "assistant", "content": "NEUTRAL"},
    {"role": "user", "content": "Best burger I have had in years!"},
]
# 模型现在会回答:POSITIVE
这两个已完成的示例确立了精确的模式:一个词,全大写,来自一个固定的集合。对第三条评论继续沿用这个模式,现在比写一整段分析要可能得多,所以你得到的就是这样的结果。这就是为什么几个清晰的示例往往胜过一整段描述,尤其是对于分类和格式化任务:你是在演示输出的样子,而不是描述它然后祈祈望模型能猜对。要选择那些覆盖棘手情况的示例,因为模型会按照你展示的内容来塑造自己的模式,包括你示例里的任何错误。
让它推理
这是最有用的提示词技巧之一,也是最反直觉的一个,而它恰恰直接源自模型的运作方式。模型一次生成一个词元,它唯一拥有的"工作空间"就是它已经写下的文本。它没有一个隐藏的草稿纸,可以先悄悄算清楚一个难题然后才回答。它的"思考"(如果可以这么说的话)是大声进行的,就发生在它生成的词元里。
所以,如果你提出一个需要多步骤的问题,却只要求给出最终答案,你就是在逼它在一个词元里一步跳到终点,完全没有工作空间——一旦涉及推理、数学或逻辑,它经常会跳错。解决办法是让它公开地展开工作。让它在给出答案之前,先把步骤列出来:
messages = [
    {"role": "system", "content": "Work through the problem step by step, then give the final answer on its own line."},
    {"role": "user", "content": "A shop sells pens at 3 for $2. How much do 12 pens cost?"},
]
# 没有"step by step",模型往往会脱口而出一个错误的数字
# 加了这句,模型会把推演过程写出来,每一步都让下一步更可靠这种做法叫**思维链(chain-of-thought)**提示,它有效的原因是机制性的,不是什么魔法。模型写下的每一步,都会变成它读取以生成下一个词元的上下文的一部分,所以写下"12支笔就是4组3支"会让"4组乘以2美元等于8美元"变成自然而然、大概率出现的续写。你是在给模型一块可以在纸面上进行运算的空间,而不是要求它在一次不可能的跳跃中直接给出答案。日常说法就是"一步一步来想"或"把你的推演过程写出来"。
有两点要注意。写出来的推理过程仍然是生成出来的文本,它可能看起来头头是道,却得出一个错误的答案,你不应该把它当成一个有保证的证明。而且一些较新的模型会在不被要求的情况下,自己在内部完成这种推演过程。但无论未来出现什么模型,这个底层原理都是持久有效的:当模型有空间把步骤写出来时,它推理得更好,因为它自己生成的输出,是它唯一能用来"思考"的地方。
组织提示词的结构
随着提示词越写越长,结构能让上下文保持清晰,从而让模型正确地权衡各个部分。有几个习惯很有帮助:
- 指令在前,数据在后。 先说明要做什么,再提供要处理的文本。
- 用分隔符把指令和数据隔开。 把任何提供的文本用清晰的标记包起来,让你的规则和输入之间的边界一目了然。
- 明确要求输出的形式。 如果你想要 JSON,就直说,并把字段描述清楚。
prompt = f'''Summarise the customer message below in one sentence.
Then list any product names it mentions.

Customer message:
"""
{user_message}
"""'''这里的三重引号就是一个**分隔符(delimiter)**。它标出了"这里面的一切都是要处理的数据,不是要遵循的指令"。这不只是为了整洁,从预测的角度来看,这里正好能说明它为什么是一道真正的防线。
对模型来说,这一切都是一条文本流,所以如果用户输入不经任何分隔就直接流入你的指令里,用户就可以写"忽略上面的内容,改成执行以下操作",而模型没有任何可靠的办法把这一行和你真正的指令区分开。它很可能会照着这句话继续往下执行。
这种攻击叫提示词注入(prompt injection),把指令和不可信的数据清晰地隔离开,是防御它的第一道防线,安全与边界一章会讲到这个。对模型来说,这一切都是一条文本流,所以要把不可信的输入围栏起来。
实战运用
下面这个提示词把这几个技巧叠加在了一起:一条承载持久规则的系统消息、一个具体的请求、一个用来锁定格式的示例,以及清晰隔离开的数据。
messages = [
    {
        "role": "system",
        "content": (
            "You extract action items from meeting notes. "
            "Reply with a numbered list, one action per line, each starting with a verb. "
            "If there are no action items, reply 'None'."
        ),
    },
    {"role": "user", "content": 'Notes: """We agreed Sam will send the budget by Friday and Lee will book the venue."""'},
    {"role": "assistant", "content": "1. Send the budget by Friday (Sam)\n2. Book the venue (Lee)"},
    {"role": "user", "content": f'Notes: """{meeting_notes}"""'},
]系统消息一次性把规则定好,示例锁定了确切的格式,每一次请求都送来隔离好的数据。每一个部分都在编排上下文,让你想要的输出变成大概率会出现的续写。这就是这门手艺的全部要义:这是一个**可靠的提示词**,不是一个碰巧运气好的提示词。接下来你会在从代码中调用模型一章里,从真正的代码中把类似这样的消息发送给模型。
system 消息、一个具体的请求、一个用来锁定格式的示例,以及清晰隔离开的数据。每一个部分都在编排上下文,让你想要的输出变成大概率会出现的下一段文本。这就是这门手艺的核心:一个靠设计而不是靠运气奏效的提示词。