

 The AI Engineer Path
开放模型与闭源模型

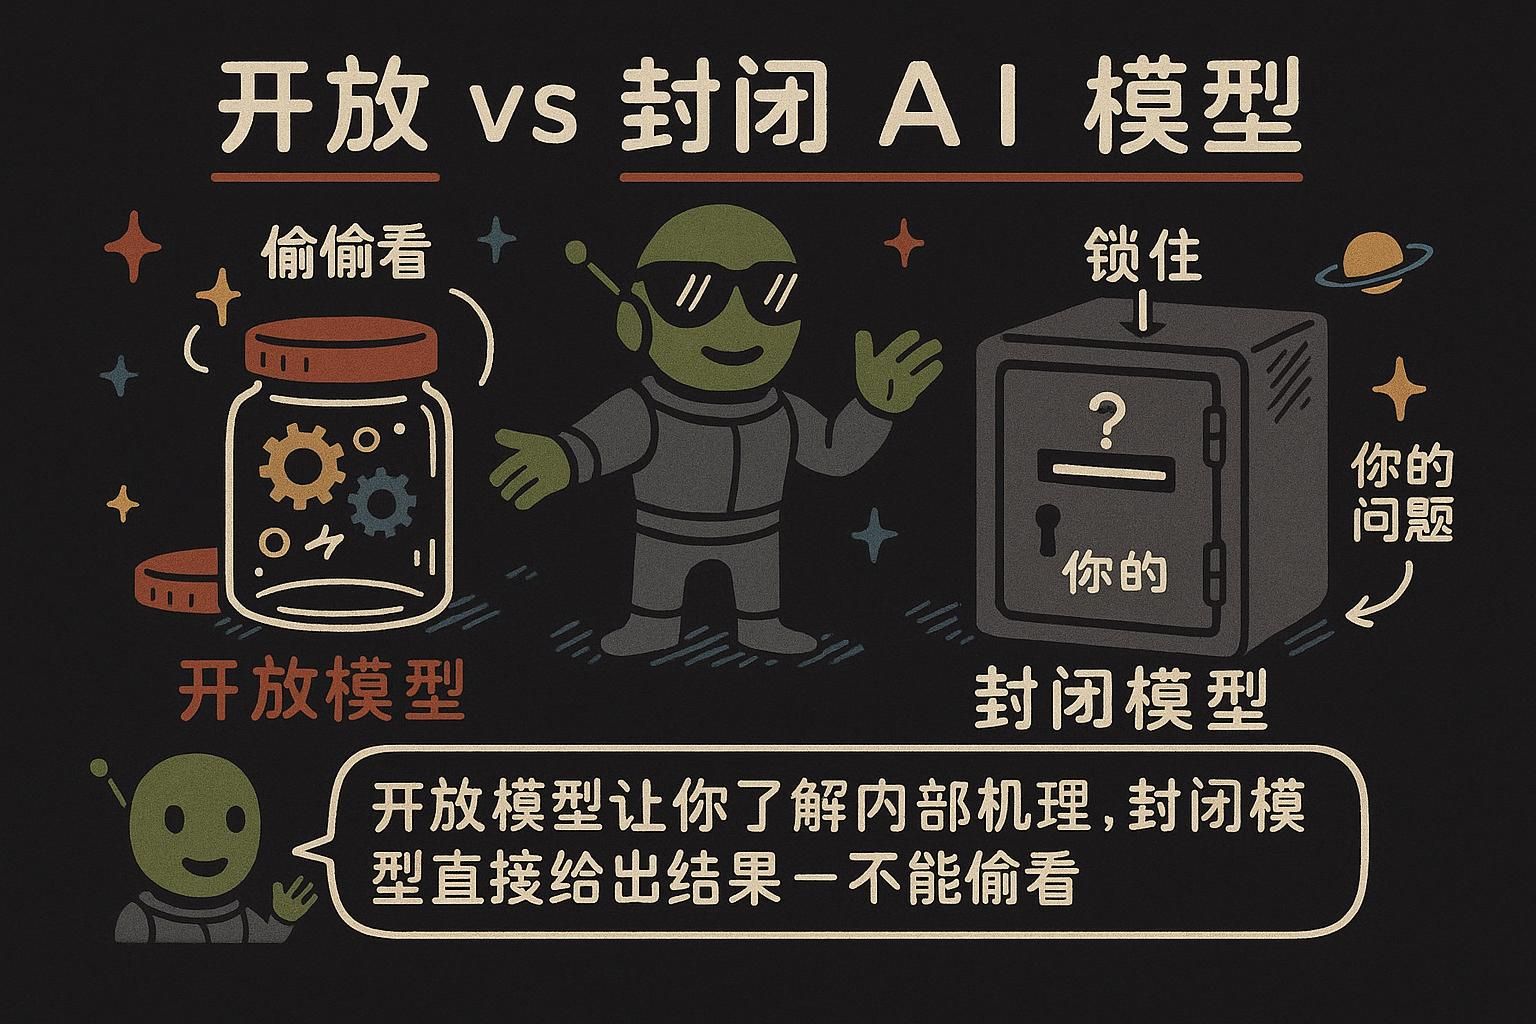
从本质上说,一个模型就是一大堆训练出来的权重(也就是它在训练过程中学到的那些数字),用来预测下一个 token。这一章要讲的是这些权重到达你手中的两种方式——闭源模型是你通过 API 租用的,开放权重模型是你可以自己运行的——以及它们各自实际运行在哪里。大家默认被引导去用的是托管的闭源模型,而服务商也没有什么理由去主动介绍其他选择,所以了解完整的选项,以及每种选项在什么情况下真正有用,是很值得的。
开放权重与闭源权重
获取一个 AI 模型有两种方式,区别就在于模型到底存放在哪里。
第一种是闭源模型,有时也叫专有模型。你只能通过公司提供的 API 接触到它,API 就相当于一个在线的门:你发送文字进去,得到文字回来,整件事就是这样。模型的权重——那一大堆让它运转起来的训练数字——始终被锁在公司自己的服务器上。你是在租用访问权限,而不是拥有任何东西。
第二种是开放权重模型。在这种情况下,公司会公开这些权重,所以你可以下载自己的一份副本,在你能控制的硬件上运行它。可以把它想象成:租一间你永远看不到内部线路的公寓,和拥有一份这栋楼的完整图纸,是两种完全不同的关系。
大多数人一开始都会选择闭源 API,因为这是最容易上手的入门方式,这样开始完全没问题。开放模型这个选项是真实存在的,也值得了解,这样你才明白租用只是一种选择,而不是唯一的路。

模型运行在哪里
有一种流传甚广的说法认为,选择开放模型就意味着你必须自己搭建服务器、亲自运行这个模型。这个说法是错的,值得早点说清楚。
模型可以运行在两种地方之一。对于托管模型,某家公司在自己的机器上运行它,你通过 API 调用在网络上接触到它,API 调用就是你的代码发出的一个小请求,然后得到一个回应。你完全不用碰运行它的那台电脑。而在自建部署(self-hosting)中,你自己运行这个模型,在你自己的电脑或自己的服务器上。
这里是大家容易忽略的一点。开放模型并不会强迫你走自建部署这条路。你完全可以像使用闭源模型那样,通过某家托管公司来使用开放模型:你发送请求,得到回应,机器由别人负责运行维护。自建部署是一个你可以选择的选项,不是你必须遵守的规则。
什么时候该用哪种
这里有一个简单的方式来把握整个选择。托管的闭源模型是租用:不需要搭建任何东西,你能拿到目前最好的质量,每次使用都付一点钱。你自己运行的开放模型更接近拥有:你获得更多的控制权和隐私,也没有需要付给服务商的按次账单,但你要承担让它保持运行的工作。
大多数人一开始通过 API 租用是正确的选择,而且大多数人永远都不需要更多。先租用是正常、合理的路径。
这一章的重点不是说你应该转去自己运行模型。它只是想告诉你,这个选择权在你手里,这样如果有一天你的需求变了,你能认出这个选项本来的样子。
选定了模型之后,接下来的问题是你要如何跟它对话。下一章提示词,讲的就是如何引导你选定的模型,让它给出你真正想要的结果。