Skip to content
This page has been auto-translated and may contain errors.View in English

RAG ​

docs.scrimba.com

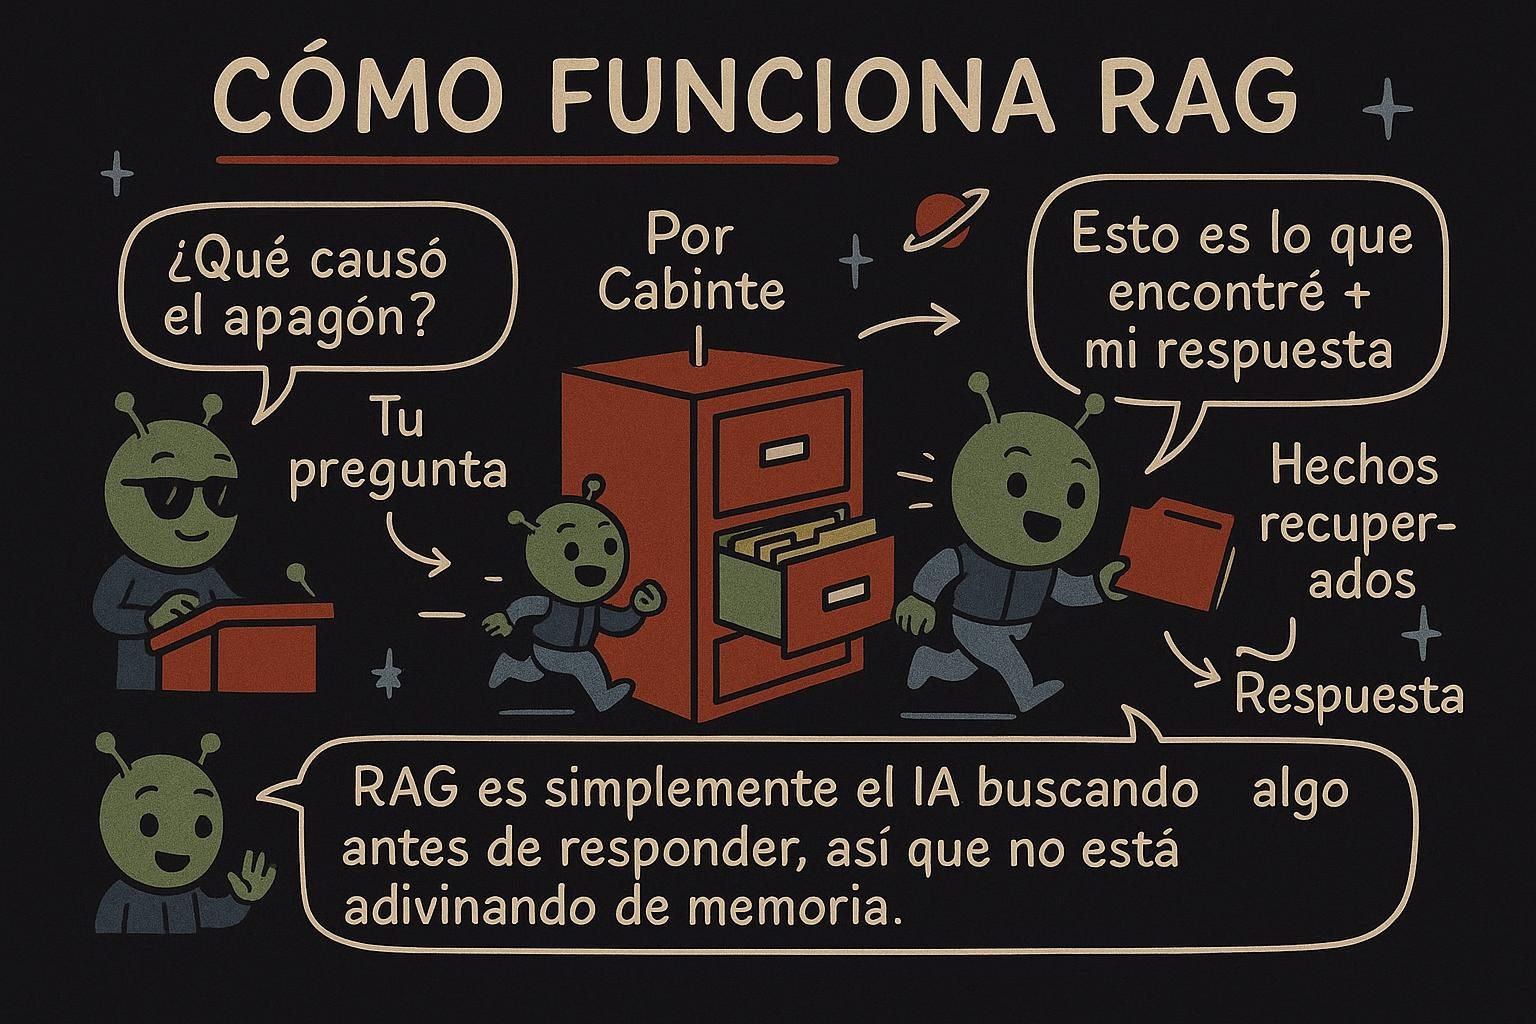
Primero, el nombre. RAG son las siglas de retrieval-augmented generation (generación aumentada por recuperación): tú mismo buscas el texto relevante y se lo entregas al modelo en el momento de la pregunta, de modo que responda a partir de datos que le proporcionaste en lugar de su memoria congelada. Este capítulo trata sobre cómo funciona ese ciclo de buscar y luego responder, y dónde puede fallar.

El patrón de recuperar y luego generar ​

Un modelo no conoce los documentos de ayuda de tu empresa, los detalles de tu producto, ni nada que haya ocurrido después de su entrenamiento. Si le preguntas sobre eso, admitirá que no puede ayudar o, peor aún, se inventará algo que suena convincente. RAG resuelve esto entregándole al modelo el texto relevante en el momento de la pregunta.

La idea toma forma una vez que entiendes los embeddings, el truco que convierte el texto en vectores que puedes comparar por cercanía (la similitud coseno mide cuán cerca apuntan dos vectores). La generación aumentada por recuperación son dos pasos añadidos a una llamada normal al modelo:

  1. Recuperar. Toma la pregunta del usuario, busca en tus documentos las partes más relevantes y reúne las mejores coincidencias.
  2. Generar. Coloca esas partes en el prompt como contexto y luego pídele al modelo que responda la pregunta usando solo ese contexto.

La capacidad general del modelo para redactar hace la escritura; el texto que recuperaste aporta los hechos. Así obtienes respuestas fluidas que están fundamentadas en tu contenido y que pueden mantenerse actualizadas, porque tú controlas lo que entra.

Ayuda entender por qué esto funciona tan bien, en términos del ciclo de predicción. Sin RAG, le estás pidiendo al modelo que recuerde un dato a partir de los patrones congelados en sus parámetros, dato que puede no tener, lo que lleva a una suposición hecha con confianza. Con RAG, el dato está ahí mismo, en el contexto, así que la tarea del modelo cambia de "recuerda esto" a "lee lo que tienes enfrente y responde a partir de eso". La recuperación traslada el trabajo de la memoria a la lectura. La imagen clara es la de un examen: un examen a libro cerrado invita a adivinar, mientras que RAG lo convierte en un examen a libro abierto donde la página relevante ya está abierta sobre el escritorio.

JunoEl patrón de recuperar y luego generar RAG añade dos pasos a una llamada normal al modelo: recuperar los documentos más relevantes para la pregunta y luego generar una respuesta usándolos como contexto. El modelo aporta el lenguaje, el texto que recuperaste aporta los hechos. Esto le permite responder a partir de tu contenido en lugar de su memoria, que es justamente lo que evita que invente respuestas. Me tomó un tiempo confiar en esto, pero un modelo a libro abierto de verdad adivina menos que uno a libro cerrado.

Un modelo no lleva consigo tus documentos de ayuda, los detalles de tu producto, ni nada posterior a la fecha límite de su entrenamiento. Si le preguntas de todos modos, obtienes una negativa o una respuesta inventada que suena bien. La generación aumentada por recuperación cierra esa brecha buscando texto relevante y colocándolo en el prompt en el momento de la solicitud, de modo que el modelo lea el dato en lugar de recordarlo. El mecanismo se apoya en los embeddings, donde cada fragmento de texto se convierte en un vector y la similitud es la distancia entre vectores (similitud coseno, el coseno del ángulo entre ellos).

El ciclo tiene dos pasos:

  1. Recuperar. Convierte la pregunta en un embedding dentro del mismo espacio vectorial que tus documentos y luego extrae los fragmentos más cercanos por similitud.
  2. Generar. Concatena esos fragmentos en el prompt como contexto e indícale al modelo que responda solo a partir de ellos.

El paso de recuperación tiene un ajuste que tú controlas llamado top-k: cuántos de los fragmentos más cercanos conservas en realidad. k es un equilibrio. Si es muy pequeño, te pierdes el fragmento que contenía la respuesta, así que el modelo no tiene con qué trabajar. Si es muy grande, llenas el contexto con texto relacionado solo de forma vaga, lo que diluye la señal, aumenta el costo y agrava el problema de "perdido en el medio". Un k de 3 a 5 es un punto de partida razonable, y lo ajustas contra preguntas reales.

Aquí está la clave: estructura el índice como una lista de registros, cada uno con el texto del fragmento y su vector precalculado, y estructura el prompt de modo que el contexto recuperado quede en un bloque claramente delimitado encima de la pregunta. La capacidad lingüística del modelo escribe; el texto que recuperaste decide qué es verdad.

python
def retrieve(question, index, k=4):
    query_vector = embed(question)
    scored = [
        {"text": item["text"], "score": cosine_similarity(query_vector, item["vector"])}
        for item in index
    ]
    return sorted(scored, key=lambda x: x["score"], reverse=True)[:k]
JunoEl patrón de recuperar y luego generar RAG es recuperar y luego generar: convierte la pregunta en embedding, extrae los fragmentos más cercanos, colócalos en el prompt y responde a partir de ellos. El ajuste que importa aquí es top-k, la cantidad de fragmentos que conservas: si son muy pocos, te pierdes la respuesta; si son demasiados, la entierras en ruido y pagas el precio por ello. Empieza por un rango de 3 a 5 y ajústalo contra preguntas reales, no por intuición.

Un modelo no contiene tu corpus privado ni nada posterior a su fecha límite, y no te dirá cuál es el caso; responde con el mismo tono seguro en ambas situaciones. La generación aumentada por recuperación es el patrón de buscar texto relevante en el momento de la solicitud y fundamentar la respuesta en él, de modo que la corrección dependa de una fuente que tú controlas y no de la memoria paramétrica. Funciona sobre embeddings: texto convertido en vectores, ordenados por similitud coseno (el coseno del ángulo entre dos vectores, es decir, la cercanía de significado sin importar la longitud).

El planteamiento en dos pasos, recuperar y luego generar, es correcto pero oculta dónde está realmente el trabajo. La recuperación es un problema de búsqueda disfrazado de generación, y ahí es donde se determina la calidad de todo el sistema, no en la llamada al modelo. Así que trata "recuperar-y-luego-generar" como "recuperar-clasificar-y-luego-generar" desde el principio, porque la versión ingenua (convertir la consulta en embedding, tomar los k más cercanos, pegarlos) falla en los modos de fallo que los niveles anteriores todavía no han encontrado: coincidencias exactas que se pierden, fragmentos casi duplicados que desplazan la cobertura, y texto obsoleto que responde con toda confianza.

El primer hábito que conviene adoptar desde temprano es entender que esto es un sistema medible, no una cuestión de intuición. Reserva un conjunto de preguntas reales junto con los fragmentos que deberían responderlas y luego mide el recall@k: de los fragmentos que debieron haberse recuperado, la fracción que quedó dentro de tu top k. Recall@k es tu límite superior. Si el fragmento correcto no está en el contexto, ninguna cantidad de habilidad en el prompt lo recupera, y el paso de generación no puede responder algo que la recuperación nunca le entregó. Todo lo que viene después está acotado por este número, así que es lo primero que debes medir y lo primero que debes mejorar.

python
def retrieve(question, index, k=8):
    query_vector = embed(question)
    scored = [
        {"text": it["text"], "score": cosine_similarity(query_vector, it["vector"]), "meta": it["meta"]}
        for it in index
    ]
    # aquí sobre-recuperamos, y luego reclasificamos hasta un conjunto final más pequeño (ver más abajo)
    return sorted(scored, key=lambda x: x["score"], reverse=True)[:k]
JunoEl patrón de recuperar y luego generar RAG es un problema de búsqueda disfrazado de generación: la calidad se determina en la recuperación, no en la llamada al modelo, así que la versión ingenua de "convertir a embedding, tomar k, pegar" te va a fallar en las coincidencias exactas y con texto obsoleto. El número que acota todo es recall@k, la fracción de los fragmentos que debieron recuperarse y que realmente entraron en tu top k. Si el fragmento correcto nunca llega al contexto, ningún prompt te salva. Mide eso antes de ajustar cualquier otra cosa, o estarás puliendo el extremo equivocado.

Fragmentación (chunking) ​

No conviertes en embeddings documentos completos. Primero los divides en fragmentos (chunks) más pequeños, un párrafo o unas pocas oraciones cada uno, y conviertes eso en embeddings. Por dos razones. Primero, la recuperación se vuelve más precisa: extraes el único párrafo relevante en lugar de un manual completo de 40 páginas. Segundo, los fragmentos caben en la ventana de contexto, mientras que un documento gigante podría no caber.

python
# un fragmentador simple: divide por párrafos
def chunk(text):
    return [c.strip() for c in text.split("\n\n") if c.strip()]

El tamaño del fragmento es un equilibrio, y la razón se remonta a los embeddings. Cada fragmento se convierte en un único vector que resume todo su significado. Si haces un fragmento demasiado grande, cubrirá varios temas, así que su único vector será un promedio confuso de todos ellos que no coincidirá bien con ninguna pregunta específica. Si lo haces demasiado pequeño, pierde el significado que lo rodeaba y que necesitaba para tener sentido, así que el vector apunta a un fragmento inconexo. Los fragmentos del tamaño de un párrafo contienen cada uno una idea coherente. A partir de ahí ajustas según el rendimiento de tu recuperación.

JunoFragmentación (chunking) Antes de generar embeddings, divide los documentos en fragmentos más pequeños, más o menos del tamaño de un párrafo, y conviértelos en embeddings. Los fragmentos más pequeños hacen la recuperación más precisa y encajan mejor en la ventana de contexto. El tamaño del fragmento es un equilibrio: si es muy grande, resulta impreciso y desperdicia recursos; si es muy pequeño, pierde el significado que lo rodea. Cuando mis respuestas salían vagas, casi siempre era porque los fragmentos eran demasiado grandes.

Conviertes fragmentos en embeddings, no documentos completos, porque cada fragmento se vuelve un único vector que tiene que resumir todo su significado. Divide un documento en piezas del tamaño de un párrafo y convierte cada una en embedding. Un fragmento demasiado grande promedia varios temas en un vector que no coincide con precisión con nada; uno demasiado pequeño pierde el contexto que lo hacía tener sentido.

Así que trata el tamaño del fragmento como un ajuste que se calibra, no como una regla fija. Un fragmento de unos cientos de tokens suele contener una idea de forma limpia. Este ajuste interactúa con top-k: fragmentos más grandes significan que menos de ellos entran en tu presupuesto de contexto, así que llevas menos cobertura por solicitud. Los fragmentos más pequeños aumentan la precisión pero necesitan un k mayor para reconstruir una idea que se extiende entre varios.

El segundo ajuste es el solapamiento: dejar que fragmentos consecutivos compartan una porción de texto en sus límites, digamos entre 10 y 20 por ciento. Sin solapamiento, una oración que responde la pregunta puede quedar dividida justo en un límite, mitad en un fragmento y mitad en el siguiente, así que ninguno de los dos se recupera bien. El solapamiento te cuesta algo de duplicación y algunos vectores más, y a cambio recupera las respuestas que los límites, de otro modo, partirían en dos.

python
def chunk(text, size=800, overlap=120):
    # tamaño y solapamiento aquí en caracteres; en sistemas reales, calcula en tokens
    out, start = [], 0
    while start < len(text):
        out.append(text[start:start + size])
        start += size - overlap
    return out
JunoFragmentación (chunking) El tamaño del fragmento y el solapamiento son ajustes que se calibran, no configuraciones que aciertas de una vez. Apunta a fragmentos que contengan una sola idea, de unos cientos de tokens, y recuerda que este ajuste compite con top-k: fragmentos más grandes significan que caben menos. Agrega entre 10 y 20 por ciento de solapamiento para que una respuesta que atraviesa un límite siga viviendo completa dentro de al menos un fragmento. Los límites son donde la recuperación pierde respuestas sin que te des cuenta.

La fragmentación es donde se gana o se pierde el recall de la recuperación, antes incluso de que corra una sola consulta. Cada fragmento se convierte en un único vector que tiene que representar todo su significado, así que la forma en que divides decide qué es encontrable. Los límites de párrafo o de sección superan a las ventanas de caracteres fijas cuando el documento tiene estructura, porque un vector sobre una sección coherente es un objetivo de búsqueda más limpio que un vector sobre la mitad de dos secciones distintas.

El tamaño del fragmento y el solapamiento están acoplados a todo tu presupuesto, no son parámetros libres. El tamaño compite con top-k y con la ventana de contexto: los fragmentos grandes llevan más contexto cada uno, pero entran menos, así que la cobertura baja; los fragmentos pequeños aumentan la precisión pero fragmentan las ideas y necesitan un k mayor para reconstruirlas, lo que cuesta tokens y reintroduce el problema de "perdido en el medio". Un solapamiento de aproximadamente 10 a 20 por ciento rescata respuestas que atraviesan un límite, a costa de duplicación en tu índice. Esa duplicación tiene una consecuencia más adelante: fragmentos casi idénticos que se solapan pueden llenar varios de tus lugares del top-k con el mismo contenido, reduciendo la cobertura. Esa es una de las razones por las que la reclasificación y la deduplicación se ganan su lugar más adelante.

El costo que la mayoría ignora hasta que duele: la estrategia de fragmentación queda incrustada en tu índice, así que cambiarla significa volver a convertir en embeddings y reindexar todo el corpus. Eso es cómputo real, dinero real, y una ventana de migración durante la cual los vectores viejos y nuevos no deberían mezclarse. Decide el tamaño del fragmento en función de tus documentos y consultas reales desde temprano, mide recall@k sobre un conjunto reservado, y trata un cambio de fragmentación como un reindexado deliberado, no como un ajuste de configuración que subes un viernes cualquiera.

JunoFragmentación (chunking) Fragmenta según la estructura cuando la tengas, porque cada fragmento es un vector que representa todo su significado, y el tamaño compite con top-k y con la ventana al mismo tiempo. Un solapamiento de 10 a 20 por ciento salva las respuestas que atraviesan un límite, pero genera casi duplicados que saturan tu top-k, que es en parte por qué existe la reclasificación. Y recuerda que la elección de fragmentación queda incrustada en el índice: cambiarla implica reconvertir todo en embeddings y reindexar, un costo real y una migración, no un simple cambio de configuración.

Dónde viven los vectores ​

Para un puñado de fragmentos, puedes mantener los vectores en memoria y compararlos con la función de similitud coseno del capítulo de embeddings, que es justo lo que hace el ejemplo más adelante. Para miles o millones de fragmentos, esto se vuelve lento, y ahí recurres a un almacén de vectores (vector store): una base de datos construida para encontrar los vectores más cercanos rápidamente a gran escala.

No necesitas uno para aprender RAG, ni necesitas elegir uno ahora mismo. Existen varios como servicios alojados y como bibliotecas; lo que importa es el concepto: un lugar donde guardar embeddings y buscarlos rápido. Empieza en memoria y muévete a un almacén cuando la colección lo supere.

JunoDónde viven los vectores Para pocos fragmentos, mantén los vectores en memoria y compáralos directamente. Para colecciones grandes, un almacén de vectores es una base de datos que encuentra los vectores más cercanos rápidamente a gran escala. No necesitas uno para aprender RAG: empieza en memoria y muévete a un almacén de vectores cuando la colección lo supere. No hace falta buscar una base de datos desde el primer día.

Para unos cientos de fragmentos, los vectores viven en memoria y calificas cada uno contra la consulta. Eso es un escaneo lineal: bien a pequeña escala, lento cuando la colección llega a miles o millones, porque comparas contra cada vector en cada consulta. En ese punto pasas a un almacén de vectores, una base de datos que indexa vectores para búsqueda rápida del vecino más cercano.

La asimetría que vale la pena tener presente es "embeddings una sola vez" versus "embeddings por consulta". Conviertes en embeddings e indexas cada fragmento de documento exactamente una vez, de antemano, y ese trabajo se reutiliza para cada pregunta futura. Conviertes la consulta en embedding una vez por solicitud, en el momento de la solicitud, y ese es el único costo de generar embeddings en la ruta crítica. Así que el costo pesado de indexación se paga por adelantado y se amortiza; el costo por consulta es solo una llamada de embedding más una búsqueda. Eso es lo que hace que servir RAG resulte económico una vez construido.

No necesitas elegir un almacén para aprender el patrón. Empieza con una lista de registros en memoria, cambia a un almacén de vectores cuando la escala o la persistencia lo exijan, y mantén la misma interfaz: convertir la consulta en embedding, buscar, devolver el top-k.

JunoDónde viven los vectores En memoria escaneas cada vector por consulta, lo cual está bien hasta que la colección crece, y entonces un almacén de vectores te da búsqueda indexada del vecino más cercano. Ten presente la asimetría: los documentos se convierten en embeddings e indexan una sola vez y se reutilizan para siempre, mientras que la consulta se convierte en embedding de nuevo en cada solicitud. El costo inicial se paga una vez y se amortiza, así que servir sigue siendo económico. Empieza en memoria y cambia a un almacén cuando la escala o la persistencia lo obliguen.

En memoria haces un escaneo lineal, calificando la consulta contra cada vector de fragmento, lo cual es exacto pero es O(n) por consulta y deja de escalar en algún punto de las decenas de miles. Un almacén de vectores reemplaza el escaneo con un índice aproximado de vecino más cercano (ANN, por sus siglas en inglés): intercambia un poco de recall por una gran ganancia en velocidad, al no revisar cada vector. Ese intercambio es un ajuste, y a escala de producción aceptas que el índice pueda perderse ocasionalmente un vecino verdadero, lo que se refleja directamente en tu recall@k.

La asimetría de "embeddings una sola vez" define la forma de tu costo. La indexación convierte en embeddings todo el corpus una sola vez, un costo alto por adelantado en lote; servir convierte en embedding una consulta y ejecuta una búsqueda por solicitud. Así que tu presupuesto de latencia en estado estable es aproximadamente: convertir la consulta en embedding, buscar en el índice, y luego la llamada de generación. La búsqueda suele ser la porción más pequeña; la llamada de generación domina la latencia, y el embedding de la consulta es un impuesto fijo que pagas antes de poder recuperar nada. Vale la pena medir cada tramo, porque la gente recurre a un almacén de vectores más rápido cuando la latencia real estaba, todo el tiempo, en la generación.

Luego está la obsolescencia, el modo de fallo que el juguete en memoria nunca te muestra. Tu índice es una instantánea; los documentos fuente cambian. Cambia una política, se edita un documento, un fragmento viejo sigue en el índice apuntando al pasado, y la recuperación lo entrega con plena confianza. Así que un índice no es de escritura única: necesitas una ruta de reindexación que reconvierta en embeddings los documentos modificados, e idealmente metadatos en cada fragmento (id de fuente, versión, marca de tiempo) para poder invalidar o filtrar entradas obsoletas. Decide la frecuencia de actualización en función de cuán rápido cambia tu fuente de verdad, y trata "el índice está actualizado" como algo que verificas, no que asumes.

JunoDónde viven los vectores Un almacén de vectores cambia el escaneo lineal exacto por un índice aproximado de vecino más cercano: más rápido, pero puede perderse un vecino verdadero, lo cual se refleja en tu recall@k. Los embeddings se calculan una vez para el corpus y una vez por consulta, así que la latencia en estado estable es embedding de la consulta más búsqueda más generación, y la llamada de generación suele dominar, así que mide antes de culpar al almacén. La trampa que el juguete nunca muestra es la obsolescencia: el índice es una instantánea, las fuentes cambian, así que construye una ruta de reindexación y marca los fragmentos con versión y marca de tiempo en lugar de confiar en que el índice está al día.

Fundamentar y citar ​

El paso de generación es un prompt, y la forma en que lo escribes decide si RAG realmente reduce las respuestas inventadas. Dos instrucciones hacen el trabajo pesado: decirle al modelo que responda solo a partir del contexto proporcionado, y decirle que lo indique cuando el contexto no contenga la respuesta.

python
context_text = "\n\n".join(retrieved_chunks)

system_prompt = f'''Responde la pregunta usando SOLO el contexto de abajo.
Si el contexto no contiene la respuesta, di "No tengo esa información."
Cita la parte relevante del contexto en tu respuesta.

Contexto:
"""
{context_text}
"""'''

Esto reúne dos lecciones anteriores. Los delimitadores y el "responde solo a partir de esto" explícito vienen de los prompts. El permiso para decir "no tengo esa información" es la defensa contra las alucinaciones: un modelo fundamentado con una vía de escape inventa muchísimo menos que uno al que se le deja adivinar. Fundamentar más una vía de escape es lo que reduce las respuestas inventadas. Pedirle que cite la fuente también le da a los usuarios algo que verificar.

JunoFundamentar y citar El paso de generación es un prompt, y decide si RAG funciona. Dile al modelo que responda solo a partir del contexto proporcionado y que lo indique cuando la respuesta no esté ahí. Esa fundamentación, más el permiso para admitir que no sabe, es lo que reduce las respuestas inventadas. Pedirle que cite la fuente le da a los usuarios algo que revisar, y a ti una pista de cuándo falló la recuperación.

La recuperación puede entregarle al modelo un contexto perfecto y el modelo puede seguir ignorándolo. El prompt de generación es lo que ata la respuesta al contexto, así que escríbelo con cuidado: indícale al modelo que responda solo a partir del contexto proporcionado, que admita cuando el contexto no tiene la respuesta, y que cite el fragmento que usó.

python
context_text = "\n\n".join(f"[{i}] {c}" for i, c in enumerate(retrieved_chunks))

system_prompt = f'''Responde usando SOLO el contexto de abajo.
Si la respuesta no está en el contexto, responde exactamente: "No tengo esa información."
Cita el número o los números de fragmento que usaste, como [2].

Contexto:
"""
{context_text}
"""'''

Numerar los fragmentos convierte "cita la fuente" en una cita que puedes verificar de forma programática: el modelo señala el fragmento [2], y tú puedes confirmar que el fragmento [2] realmente respalda la afirmación. Ese es tu recurso frente al modo de fallo más frecuente en RAG, la respuesta correcta con los fragmentos equivocados recuperados, donde el modelo produce una respuesta que suena correcta pero que el contexto proporcionado no respalda. Sin citas, no puedes distinguir una respuesta fundamentada de una adivinanza afortunada.

La vía de escape importa tanto como la instrucción. Un modelo al que se le dice que responda solo a partir del contexto pero al que no se le da permiso para fallar de todos modos armará algo con una recuperación pobre. Dale una salida explícita, la cadena exacta "No tengo esa información", y una recuperación fallida se manifiesta como un vacío limpio en lugar de una invención hecha con confianza. La forma del mensaje aquí sigue el estilo de OpenAI; el orden de sistema-luego-contexto varía según el proveedor, pero el principio se mantiene.

JunoFundamentar y citar El prompt de generación ata la respuesta al contexto: responde solo a partir de él, admite cuando no está ahí, y cita el fragmento. Numera los fragmentos para que la cita sea verificable, lo que atrapa la falla escurridiza donde la respuesta es correcta pero los fragmentos recuperados nunca la respaldaron. Dale al modelo la cadena exacta de escape, o una recuperación débil se termina convirtiendo en una respuesta incorrecta pero segura de sí misma. La forma varía según el proveedor, pero la estructura de sistema-luego-contexto se mantiene.

Fundamentar es el contrato entre la recuperación y el modelo, y es la palanca de confiabilidad más económica que tienes, así que invierte el esfuerzo del prompt ahí. Indícale al modelo que responda solo a partir del contexto proporcionado, que devuelva una cadena fija de abstención cuando el contexto no respalde una respuesta, y que cite los ids de los fragmentos que usó.

python
context_text = "\n\n".join(f"[{c['id']}] {c['text']}" for c in retrieved)

system_prompt = f'''Responde usando SOLO el contexto de abajo.
Si el contexto no respalda una respuesta, responde exactamente: "No tengo esa información."
Por cada afirmación, cita el id o los ids del fragmento entre corchetes, por ejemplo [doc12].

Contexto:
"""
{context_text}
"""'''

Las citas no son un adorno; son lo que hace que fundamentar sea medible. Con ids de fragmento en la salida puedes verificar, de forma automática, si un fragmento citado realmente contiene la afirmación, lo cual separa una respuesta fundamentada de una adivinanza fluida. Así también detectas la falla que derrota al RAG ingenuo: la respuesta parece plausiblemente correcta pero el contexto recuperado nunca la respaldó, así que la recuperación falló y el modelo llenó el vacío desde su memoria paramétrica. Sin ids estás haciendo verificaciones al azar; con ellos puedes calificar la fidelidad en tus evals (un conjunto reservado de preguntas con respuestas conocidas y correctas, calificado automáticamente) y observar la fidelidad como un número.

Dos notas para producción. La vía de abstención tiene que ser económica y estar autorizada, porque un modelo sin permiso para fallar siempre producirá algo, y una recuperación pobre se convierte entonces en una respuesta incorrecta pero segura de sí misma en lugar de un vacío limpio. Y la estructura del mensaje aquí sigue la forma del SDK de OpenAI; la división entre sistema y usuario, y cómo se adjunta el contexto, varía según el proveedor, así que trata la disposición como portable y los nombres exactos de los campos como no lo son. La regla duradera detrás de todo esto: nunca dejes que el modelo sea la fuente, solo el que formula una fuente que puedas citar y verificar.

JunoFundamentar y citar Fundamentar es el contrato: responde solo a partir del contexto, absente con una cadena fija, y cita ids de fragmento para que la fidelidad se convierta en algo que calificas en evals, no que evalúas a simple vista. Las citas son cómo detectas la respuesta que es correcta pero no está respaldada, donde la recuperación falló y el modelo tapó el hueco desde su memoria. Mantén la vía de abstención económica y autorizada, o una recuperación débil se convierte en una respuesta incorrecta pero segura de sí misma. La forma varía según el proveedor; la estructura se traslada, los nombres de los campos no.

Más allá del vecino más cercano: búsqueda híbrida y reclasificación ​

La búsqueda vectorial pura coincide por significado, que es lo que quieres la mayor parte del tiempo. Pero tiene un punto ciego: puede pasar por alto una palabra exacta que importa. Busca un código de error como E_4021 o el nombre específico de un producto, y una búsqueda basada en significado puede devolverte fragmentos que tratan del mismo tema mientras se salta el que contiene la cadena exacta.

La solución tiene nombre, búsqueda híbrida: combinar la búsqueda basada en significado con la búsqueda tradicional por palabras clave, de modo que los términos exactos y el significado general tengan ambos voz y voto. No necesitas construir esto para empezar con RAG. Recurre a ella cuando los términos exactos importan y los vectores puros sigan fallando en encontrarlos.

JunoMás allá del vecino más cercano: búsqueda híbrida y reclasificación La búsqueda vectorial coincide por significado, lo cual es genial hasta que alguien busca un código exacto o el nombre de un producto y el fragmento correcto se salta. La búsqueda híbrida mezcla búsqueda simple por palabras clave para que los términos exactos también cuenten. Puedes empezar con RAG sin ella y agregarla cuando notes que se acumulan los casos de coincidencias exactas perdidas.

La búsqueda vectorial por vecino más cercano coincide por significado, y eso también es su debilidad. Puede clasificar más arriba un fragmento cercano por tema que el único fragmento que contiene el token exacto que necesitas: un código de error, un SKU, un nombre de función, un nombre propio poco común. Los embeddings difuminan esas cosas en "más o menos esta zona de significado", y las cadenas exactas se pierden en esa mezcla.

La búsqueda híbrida ejecuta dos recuperadores y los combina: la búsqueda vectorial por significado, más una búsqueda por palabras clave (coincidencia de términos clásica, a menudo BM25, que califica documentos según cuántas de las palabras exactas de la consulta contienen y cuán poco comunes son esas palabras). Tomas candidatos de ambas y combinas las clasificaciones, de modo que un fragmento que gana ya sea por términos exactos o por cercanía semántica pueda salir a la superficie. La ganancia práctica es recall justo en las consultas donde los vectores puros fallan.

La segunda técnica es la reclasificación (re-ranking): una segunda pasada que vuelve a calificar los candidatos de tu primera pasada con un modelo más preciso pero también más costoso. El patrón es sobre-recuperar y luego reducir. Recupera un conjunto generoso de forma económica, digamos el top 20, y luego ejecuta un reclasificador que lee cada candidato junto con la consulta y los reordena, y conserva el top 4 para enviarlo realmente. La recuperación de primera pasada es rápida y aproximada; el reclasificador es lento y preciso, así que solo lo ejecutas sobre la lista corta. El resultado es un mejor k final sin pagar el costo del reclasificador en todo tu índice.

JunoMás allá del vecino más cercano: búsqueda híbrida y reclasificación La búsqueda vectorial pura se pierde cadenas exactas como códigos de error y SKUs porque los embeddings las difuminan en una región de significado. La búsqueda híbrida añade coincidencia por palabras clave (BM25) para que los términos exactos también tengan voto junto con la semántica. La reclasificación es un patrón de económico-y-luego-preciso: sobre-recupera un conjunto amplio con recuperación rápida, luego vuelve a calificar la lista corta con un modelo más lento y preciso, y conserva los mejores. Obtienes mejores resultados finales sin correr el calificador costoso sobre todo.

El vecino más cercano aproximado puro es una opción predeterminada sólida y también una superficie de fallo conocida. Optimiza por proximidad semántica, así que rinde mal justo cuando la consulta gira sobre un token exacto, un código de error, un identificador, un SKU, un nombre propio poco común, porque el embedding comprime ese token en un vecindario de significado donde las cadenas exactas se mezclan entre sí. Eso no es un problema de ajuste; es lo que hacen los vectores densos por naturaleza.

La búsqueda híbrida lo aborda ejecutando recuperación densa (vectores, significado) junto con recuperación dispersa (coincidencia de términos por palabras clave, típicamente BM25, que califica según la frecuencia exacta de términos ponderada por su rareza) y fusionando las listas de resultados, comúnmente con fusión de rango recíproco, que combina dos clasificaciones según la posición de cada elemento en lugar de puntuaciones brutas incomparables. La ganancia es medible como recall@k en consultas de coincidencia exacta, que es justo la porción que la búsqueda densa pura deja pasar sin que te enteres. El costo es un segundo índice y un paso de fusión, así que vale la pena precisamente cuando tu tráfico incluye identificadores y términos poco comunes, y menos cuando todo es paráfrasis en lenguaje natural.

La reclasificación ataca una falla distinta. La recuperación de primera pasada (densa, dispersa o híbrida) está construida para la velocidad sobre un índice grande, así que clasifica de forma tosca. Un reclasificador es un codificador cruzado (cross-encoder, un modelo que lee la consulta y un fragmento candidato juntos y califica su relevancia de manera conjunta, en lugar de comparar dos vectores precalculados) que es más preciso pero demasiado lento para ejecutarse sobre todo el corpus. Así que sobre-recuperas con el recuperador económico, top 20 a 50, y luego reclasificas esa lista corta y conservas los últimos pocos.

Esta es la corrección de recall con mayor retorno en la mayoría de los sistemas RAG en producción: ataca directamente la falla de "respuesta correcta con fragmentos equivocados" al elevar el fragmento que realmente respalda la respuesta por encima de los que son solo temáticamente relacionados, y mides la ganancia como recall@k antes versus después de la etapa de reclasificación. Cuantifícalo bien: el reclasificador añade latencia en la ruta crítica y costo por consulta, así que dimensiona la sobre-recuperación en función de tu objetivo de latencia, no de cuántos candidatos puedes permitirte calificar en abstracto.

JunoMás allá del vecino más cercano: búsqueda híbrida y reclasificación Los vectores densos difuminan los tokens exactos, así que la búsqueda híbrida ejecuta recuperación dispersa por palabras clave (BM25) junto con la densa y fusiona las listas con fusión de rango recíproco, recuperando recall@k en identificadores y términos poco comunes. La reclasificación es la ganancia mayor: sobre-recupera de forma económica, y luego vuelve a calificar la lista corta con un codificador cruzado que lee consulta y fragmento juntos, corrigiendo directamente la falla de "respuesta correcta con fragmentos equivocados" al elevar el fragmento que respalda la respuesta. Mide recall@k antes y después, y cuantifica la latencia y el costo por consulta del reclasificador contra tu objetivo de ruta crítica.

En la práctica ​

Una respuesta mínima con RAG, reutilizando los ayudantes search y embed del capítulo de embeddings:

python
def answer_from_docs(question, index):
    # 1. recuperar: los fragmentos que más coinciden con la pregunta
    query_vector = embed(question)
    scored = [{"text": item["text"], "score": cosine_similarity(query_vector, item["vector"])} for item in index]
    top = sorted(scored, key=lambda x: x["score"], reverse=True)[:3]

    # 2. generar: responder usando solo esos fragmentos
    context = "\n\n".join(t["text"] for t in top)
    response = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": f'Responde usando SOLO este contexto. Si no está aquí, di que no lo sabes.\n\n"""{context}"""'},
            {"role": "user", "content": question},
        ],
    )
    return response.choices[0].message.content

Recupera los tres fragmentos más cercanos, colócalos en el prompt y deja que el modelo responda a partir de ellos. Eso es todo el pipeline de RAG: la búsqueda de embeddings alimentando una llamada al modelo, sostenida por un prompt fundamentado. Casi toda la calidad vive en recuperar los fragmentos correctos.

JunoEn la práctica Una respuesta mínima con RAG es una búsqueda de embeddings que alimenta una llamada al modelo: recupera los fragmentos más cercanos, colócalos en el prompt y pídele al modelo que responda solo a partir de ellos. La recuperación aporta los hechos y el prompt fundamentado mantiene la respuesta anclada a ellos. Casi toda la calidad vive en recuperar los fragmentos correctos, así que ahí es donde debes invertir tu tiempo.

Una llamada de RAG que funciona bien es recuperar, fundamentar, generar, con el recurso de citación de antes ya integrado:

python
def answer_from_docs(question, index, k=4):
    top = retrieve(question, index, k)  # de la sección del patrón
    context = "\n\n".join(f"[{i}] {t['text']}" for i, t in enumerate(top))
    response = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content":
                f'Responde usando SOLO este contexto. Si no está aquí, responde '
                f'"No tengo esa información." Cita fragmentos como [1].\n\n"""{context}"""'},
            {"role": "user", "content": question},
        ],
    )
    return response.choices[0].message.content

Todo esto es la búsqueda de embeddings alimentando una llamada al modelo, sostenida por un prompt fundamentado. La forma de chat.completions sigue el estilo de OpenAI; los roles de los mensajes y la firma de la llamada varían según el proveedor, pero el flujo de recuperar-luego-fundamentar-luego-generar es el mismo en todas partes.

Cuando una respuesta está mal, depura en orden por etapas. Primero revisa los fragmentos recuperados: ¿el texto relevante llegó a top? Si no es así, la solución está en la recuperación, sube k, corrige la fragmentación, agrega búsqueda híbrida o reclasificación, no en el prompt. Si el fragmento correcto sí se recuperó y la respuesta sigue estando mal, entonces es un problema de prompt. Este orden te evita ajustar la redacción del prompt contra un error de recuperación, algo que nunca converge.

JunoEn la práctica Una llamada de RAG que funciona bien es recuperar, fundamentar con citas, generar, y la forma del mensaje al estilo OpenAI se traslada a otros proveedores en estructura si no en los nombres de los campos. Depura en un orden fijo: mira primero los fragmentos recuperados. Si el texto correcto nunca llegó, corrige la recuperación (k, fragmentación, híbrida, reclasificación), no el prompt. Solo una vez que el fragmento correcto está en el contexto, una respuesta incorrecta es un problema de prompt.

En la práctica, el pipeline de recuperar-clasificar-generar es una sola función, y las partes que instrumentas son las uniones entre etapas:

python
def answer_from_docs(question, index, k_fetch=20, k_final=4):
    candidates = retrieve(question, index, k=k_fetch)   # densa (o híbrida)
    top = rerank(question, candidates)[:k_final]        # pasada con codificador cruzado
    context = "\n\n".join(f"[{c['id']}] {c['text']}" for c in top)
    response = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content":
                f'Responde usando SOLO este contexto. Si no está respaldado, responde '
                f'"No tengo esa información." Cita ids como [doc12].\n\n"""{context}"""'},
            {"role": "user", "content": question},
        ],
    )
    return response.choices[0].message.content, [c["id"] for c in top]

Devolver los ids de los fragmentos junto con la respuesta es lo que hace que el sistema sea observable: registras lo que se recuperó, lo que se citó, y si los ids citados realmente respaldan la respuesta, lo cual es tu señal de fidelidad en los evals. La forma de chat.completions sigue el SDK de OpenAI; trata el flujo como portable y los nombres de los campos como específicos de cada proveedor.

El mapa de latencia y costo de este pipeline vale la pena tenerlo presente, porque la optimización debe ir donde está el tiempo:

  • La conversión de la consulta en embedding es un impuesto fijo y pequeño.
  • La recuperación de primera pasada es económica.
  • La reclasificación añade un impacto real por consulta que escala con el tamaño de tu sobre-recuperación.
  • La llamada de generación domina tanto la latencia como el costo en dinero.

Así que antes de perseguir un almacén de vectores más rápido, confirma que la búsqueda haya sido en algún momento el cuello de botella; por lo general, era la generación.

Y depura las fallas por etapa en orden: conjunto recuperado, luego conjunto reclasificado, luego citas, luego prompt. Una respuesta incorrecta cuyo fragmento correcto nunca entró en candidates es un error de recuperación, y ningún cambio de prompt corrige un fragmento que nunca estuvo ahí.

JunoEn la práctica El pipeline es recuperar, reclasificar, fundamentar, generar, y devolver los ids de fragmento junto con la respuesta es lo que lo hace observable: registra lo recuperado frente a lo citado y podrás calificar la fidelidad en evals en lugar de adivinar. Vigila el mapa de costos, la generación domina la latencia y el dinero, así que confirma que la búsqueda fuera el cuello de botella antes de cambiar de almacén de vectores. Depura por etapa en orden, recuperado luego reclasificado luego citado luego prompt, porque ningún prompt corrige un fragmento que nunca entró al conjunto de candidatos. La forma sigue el SDK de OpenAI; el flujo se traslada, los nombres de los campos no.

Cuándo no necesitas RAG ​

RAG no es gratis, y no siempre es la respuesta correcta. Sáltatelo cuando:

  • Los datos son pequeños y caben en el prompt. Si toda tu base de conocimiento es de unos pocos párrafos, pégala directamente. RAG es para cuando hay demasiado como para enviarlo todo de una vez.
  • Un modelo de contexto largo puede contenerlo todo. Algunos modelos aceptan entradas muy grandes, suficientes para tomar un documento entero de una sola vez, lo cual puede ser menos trabajo que construir una recuperación.

Y recuerda el límite real: la calidad de RAG es principalmente la calidad de la recuperación. Si el paso de búsqueda devuelve los fragmentos equivocados, ni el prompt más perfecto puede salvar la respuesta. La mayor parte del esfuerzo en los sistemas RAG reales va en recuperar el texto correcto, no en la llamada final al modelo.

Los embeddings y RAG le dan conocimiento al modelo en el momento de la pregunta, sin cambiar nunca el modelo en sí. El siguiente capítulo, Fine-tuning, cubre la otra opción: cambiar el modelo con tus propios ejemplos, y cuándo eso vale la pena frente a usar prompts o RAG.

JunoCuándo no necesitas RAG Sáltate RAG cuando tus datos sean lo suficientemente pequeños como para pegarlos en el prompt, o cuando un modelo de contexto largo pueda contenerlo todo de una vez. Y ten presente el límite real: la calidad de RAG es principalmente la calidad de la recuperación, así que si la búsqueda devuelve los fragmentos equivocados, ningún prompt puede rescatar la respuesta. La mayor parte del trabajo real está en recuperar el texto correcto, no en la llamada final.

RAG es infraestructura: un índice, un paso de embeddings, un paso de recuperación, una ruta de reindexación, y solo se justifica ese costo adicional cuando los datos son demasiado grandes para enviarlos y cambian con suficiente frecuencia como para que reentrenar no sea una opción. Sáltatelo cuando una forma más económica hace el trabajo:

  • El corpus cabe en el prompt. Unos pocos párrafos o un pequeño documento de políticas entran directamente en el contexto. RAG solo se justifica cuando hay más de lo que puedes enviar de una vez.
  • Un modelo de contexto largo contiene toda la fuente. Si el documento cabe en una ventana grande, enviarlo completo puede superar a un pipeline de recuperación que tienes que construir y ajustar, aunque pagas esos tokens en cada llamada y de todos modos te topas con el problema de "perdido en el medio".

Ten presente el hecho que lo rige todo: la calidad de RAG está acotada por la calidad de la recuperación. Un prompt perfecto sobre los fragmentos equivocados sigue respondiendo mal, así que el índice y el paso de recuperación son donde está el trabajo y las ganancias, no la llamada final al modelo. Cuando necesites cambiar el comportamiento en lugar de aportar datos, Fine-tuning es el siguiente capítulo, y resuelve un problema distinto al de RAG.

JunoCuándo no necesitas RAG RAG es infraestructura con un costo real, así que sáltatelo cuando el corpus cabe en el prompt o un modelo de contexto largo puede tragarse toda la fuente, recordando que la ruta de contexto largo paga tokens en cada llamada y de todos modos se degrada en el medio. El hecho que lo rige todo se mantiene: la calidad está acotada por la recuperación, así que un prompt perfecto sobre fragmentos equivocados sigue respondiendo mal. Invierte en el índice y la recuperación, no en la llamada final.

RAG te compra actualidad y fundamentación al precio de un sistema de recuperación que tienes que construir, ajustar, monitorear y reindexar. Así que la decisión es de costo-beneficio, no algo que se aplica por defecto. Sáltatelo cuando una forma más ligera supere el listón:

  • Corpus pequeño y estable. Si cabe en el prompt y rara vez cambia, ponlo en el contexto y apóyate en el caché de prompts para que ese bloque fijo se sirva de forma económica en llamadas repetidas. Un pipeline de recuperación aquí es un costo sin retorno.
  • Contexto largo, reutilización modesta. Si la fuente cabe en una ventana grande, enviarla completa evita la construcción, pero pagas esos tokens de entrada en cada solicitud y el recall sigue degradándose en el medio, así que pierde frente a RAG en cuanto el volumen o el tamaño del documento aumenta.

La restricción que lo rige todo es la misma que gobierna todo el capítulo: la calidad de punta a punta está acotada por recall@k. Ningún prompt, ninguna mejora de modelo, ninguna reclasificación recupera un dato que la recuperación nunca puso en el contexto. Así que la inversión de ingeniería va hacia la recuperación, la fragmentación, la búsqueda híbrida, la reclasificación, los evals, el reindexado, y la llamada al modelo es la parte económica de hacer bien. Y mantén RAG y el fine-tuning en sus carriles separados: la recuperación aporta lo que es verdad y se mantiene actualizada a medida que cambian las fuentes, mientras que el fine-tuning moldea cómo responde el modelo y es una forma obsoleta y sin fuente de inyectar datos. Usa la recuperación para el conocimiento, el fine-tuning para la forma, y no le pidas a ninguno que haga el trabajo del otro.

JunoCuándo no necesitas RAG RAG te compra actualidad y fundamentación al precio de un sistema que tienes que construir y reindexar, así que sáltatelo cuando el corpus es pequeño y estable (pégalo, apóyate en el caché de prompts) o cabe en una ventana larga con reutilización modesta. La restricción que gobierna todo es recall@k: nada aguas abajo recupera un dato que la recuperación nunca sacó a la luz, así que invierte en la recuperación, no en la llamada al modelo. Mantén los carriles limpios: la recuperación para lo que es verdad, el fine-tuning para cómo suena, y nunca le pidas a uno que haga el trabajo del otro.