 Learn HTML & CSS
网页是如何工作的
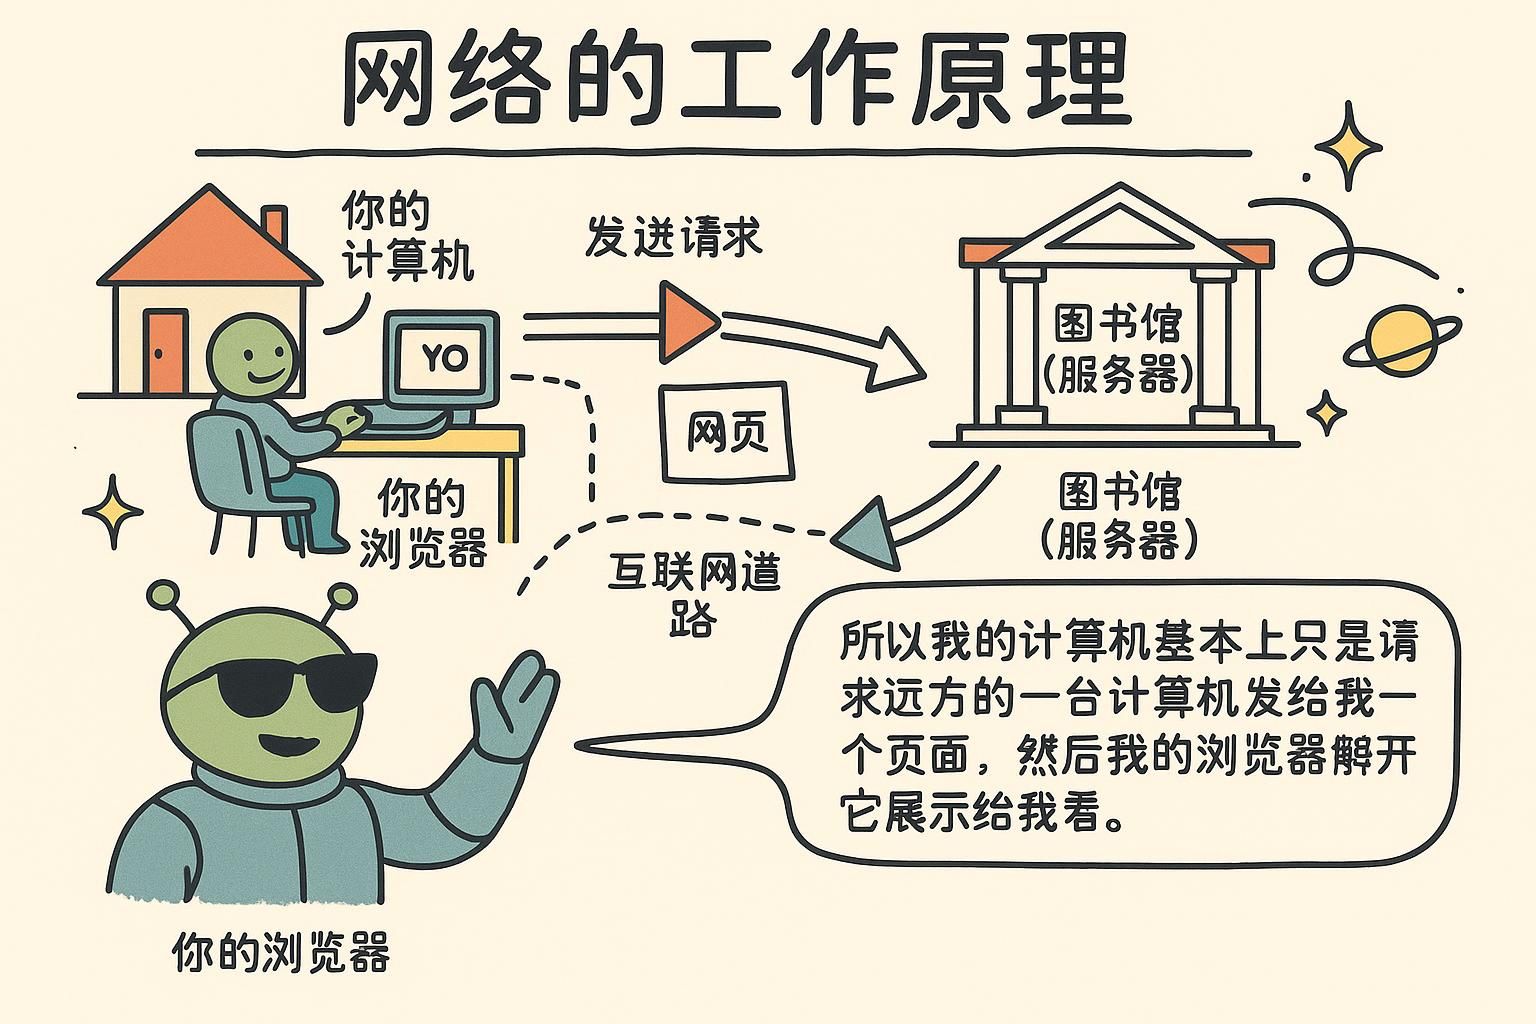
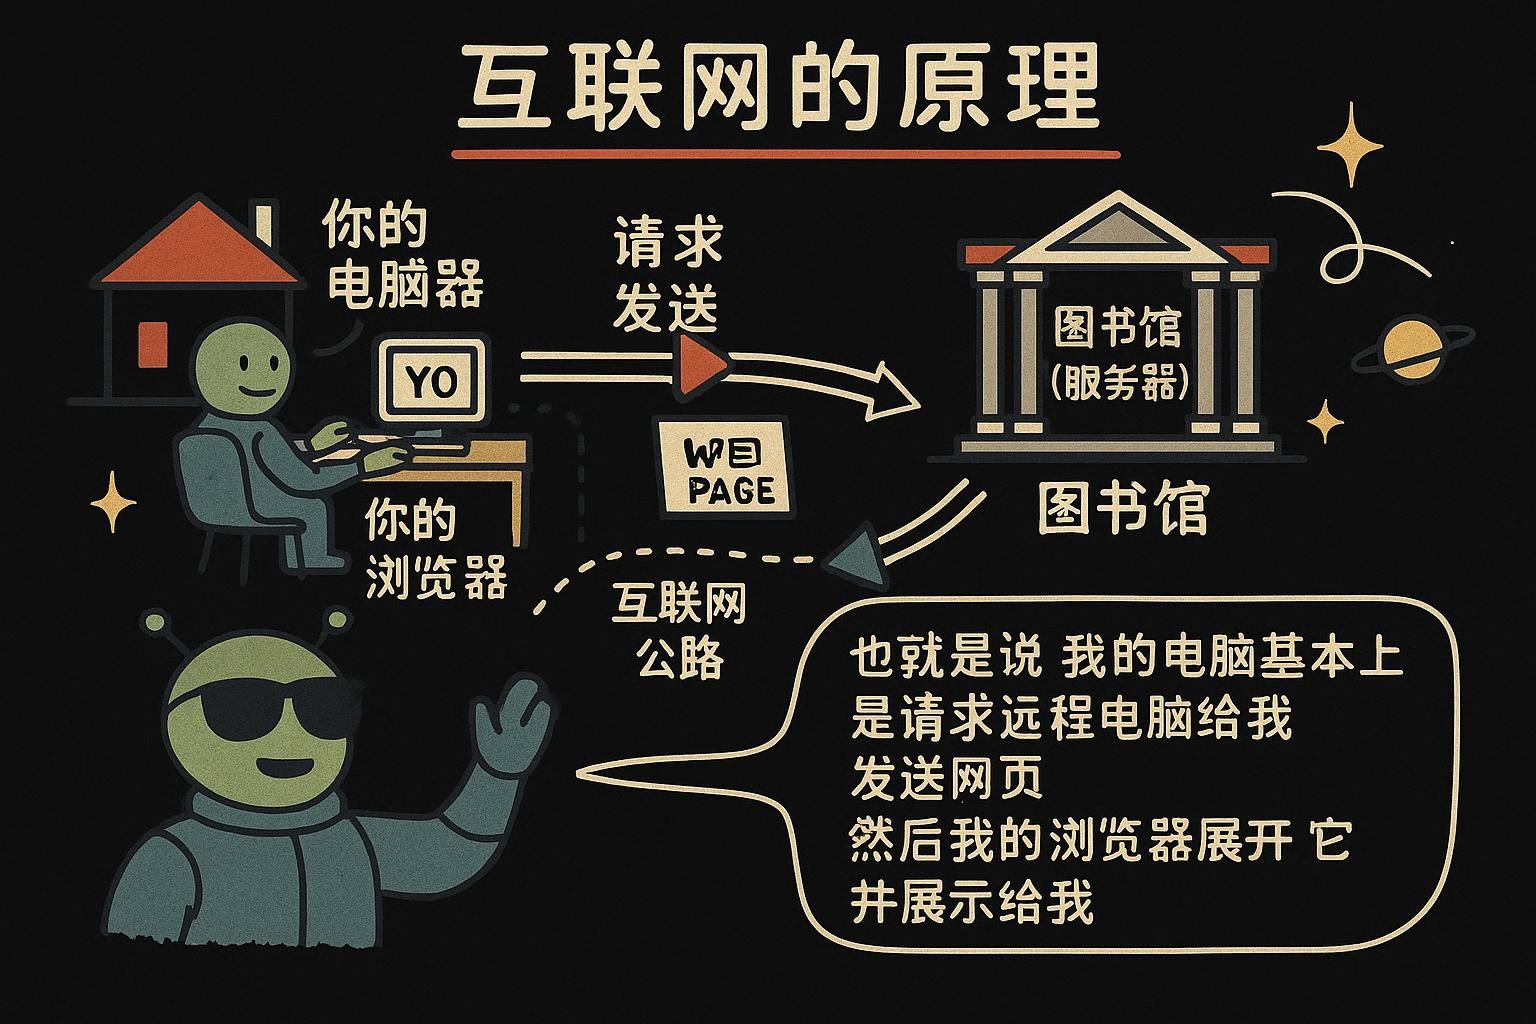
你打开的每一个页面都经历同样简短的旅程。你根据地址请求某个东西,某处的一台机器把一份文本文档发回来,你的浏览器再把这段文本变成你看到的页面。HTML 正是这段文本所使用的语言,所以理解这趟旅程,是理解本手册后面所有内容的基础。
客户端和服务器
网络本质上是两方之间的一场对话。你的浏览器是**客户端(client):负责发出请求页面的程序。而保存着网站、并把内容交出来的那台机器,是服务器(server)**。你问,它答。
可以想象在餐厅点餐的场景。你是顾客,厨房你看不见,服务员在中间来回传话。你不会自己走进厨房去做饭。你点一道菜,厨房准备好之后端出来给你。你的浏览器就是顾客,服务器就是厨房,网络就是那个在两者之间跑来跑去的服务员。
URL 和域名
你输入的地址就是一个**URL**:统一资源定位符(Uniform Resource Locator)。它是网络上某个东西的完整地址,就像邮政地址指向某一栋房子。
看看 https://scrimba.com/learn 这个例子。https 部分说明浏览器该用什么方式和服务器通信。scrimba.com 部分是域名(domain),也就是网站的名字,相当于街道和城镇。/learn 部分是通往某个具体页面的路径,相当于门牌号。三者合在一起精确指向一个页面,输入它们就是在告诉浏览器该去哪儿。
https 说明该怎么和服务器通信,像 scrimba.com 这样的域名是网站的名字,像 /learn 这样的路径指向网站上的某一页。从左往右读,它就精确告诉你浏览器要去哪儿。 请求与响应的循环
当你按下回车,浏览器会向服务器发出一个**请求(request):一条简短的消息,大意是“请把这个页面发给我”。服务器则送回一个响应(response)**:也就是页面本身。这一来一回是一次完整的往返,而这正是你每次打开页面或点击链接时发生的事。
想象向图书管理员借书。你说出书名(你的请求),管理员找到书交给你(响应),你就拿到了书。如果这本书不存在,管理员也会告诉你(这也是一种回复)。网络的工作方式和这一样,只不过快得多,而且每秒都要发生很多次。
浏览器拿到 HTML 之后做了什么
响应里装着一整页的 HTML 文本。你的浏览器从上到下读这段文本,再把它画到屏幕上:看到标题标签,就显示大号粗体文字;看到段落标签,就显示一行正文;看到图片标签,就去获取那张图片。
可以把它想成读一份菜谱再照着做菜。文本本身不是那道菜,而是那道菜的描述,浏览器就是那个把描述变成你真能看到、能用的东西的厨师。同一份 HTML 永远得到同一个页面,因为浏览器每次都遵循同一套说明。