Skip to content
This page has been auto-translated and may contain errors.View in English

表格 ​

docs.scrimba.com

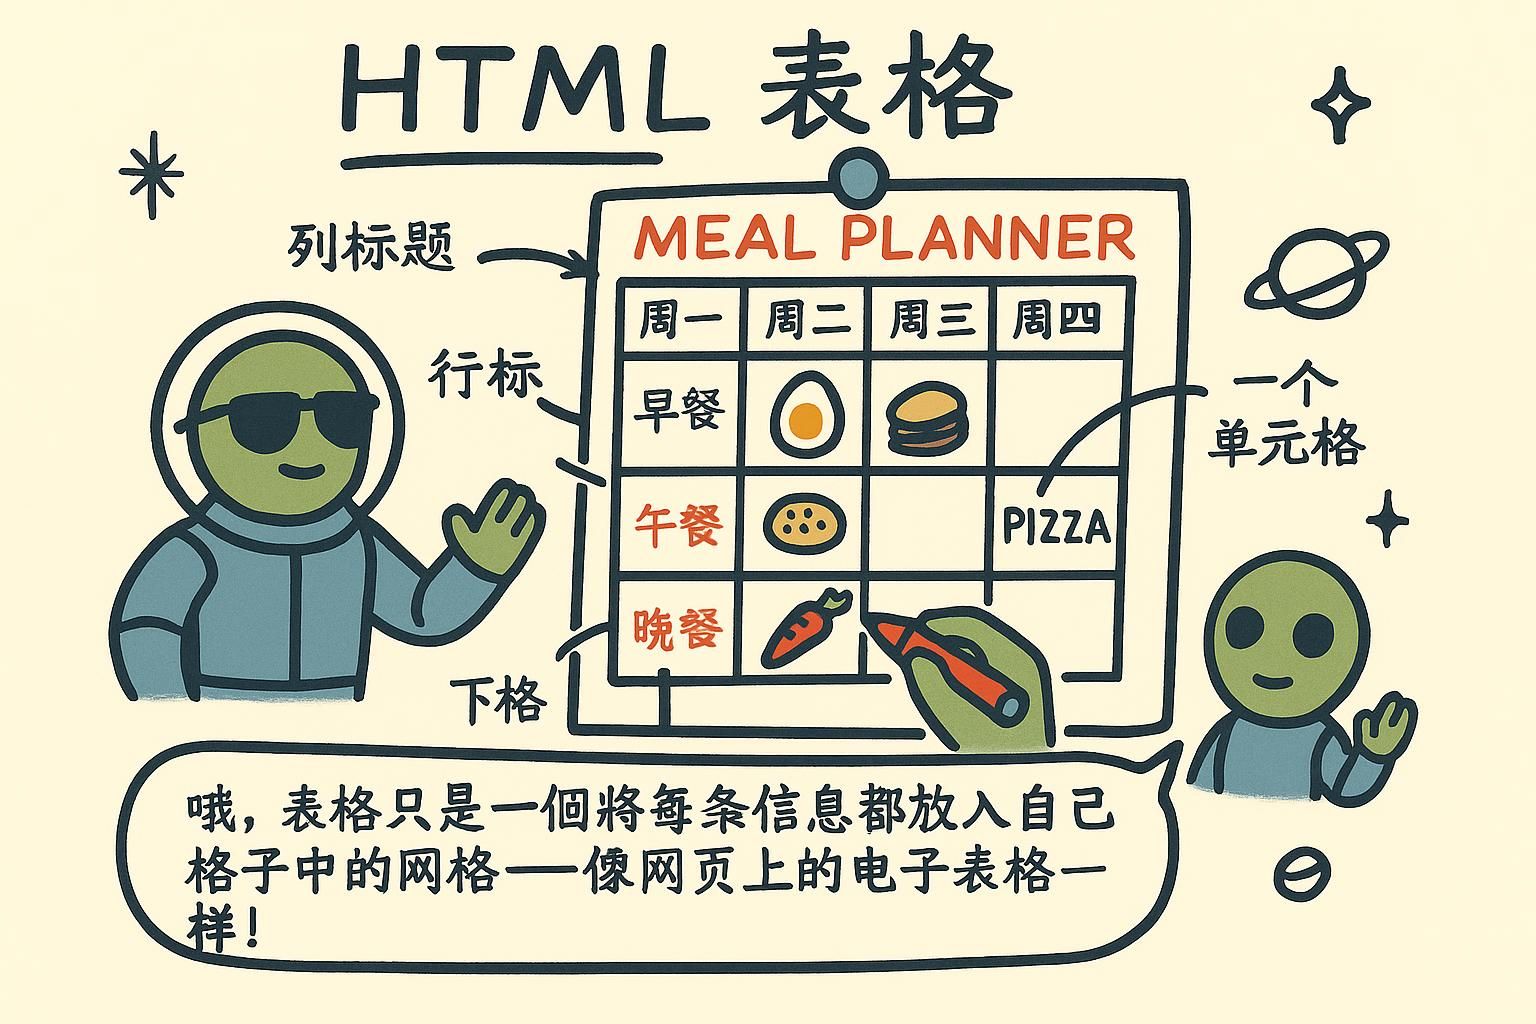
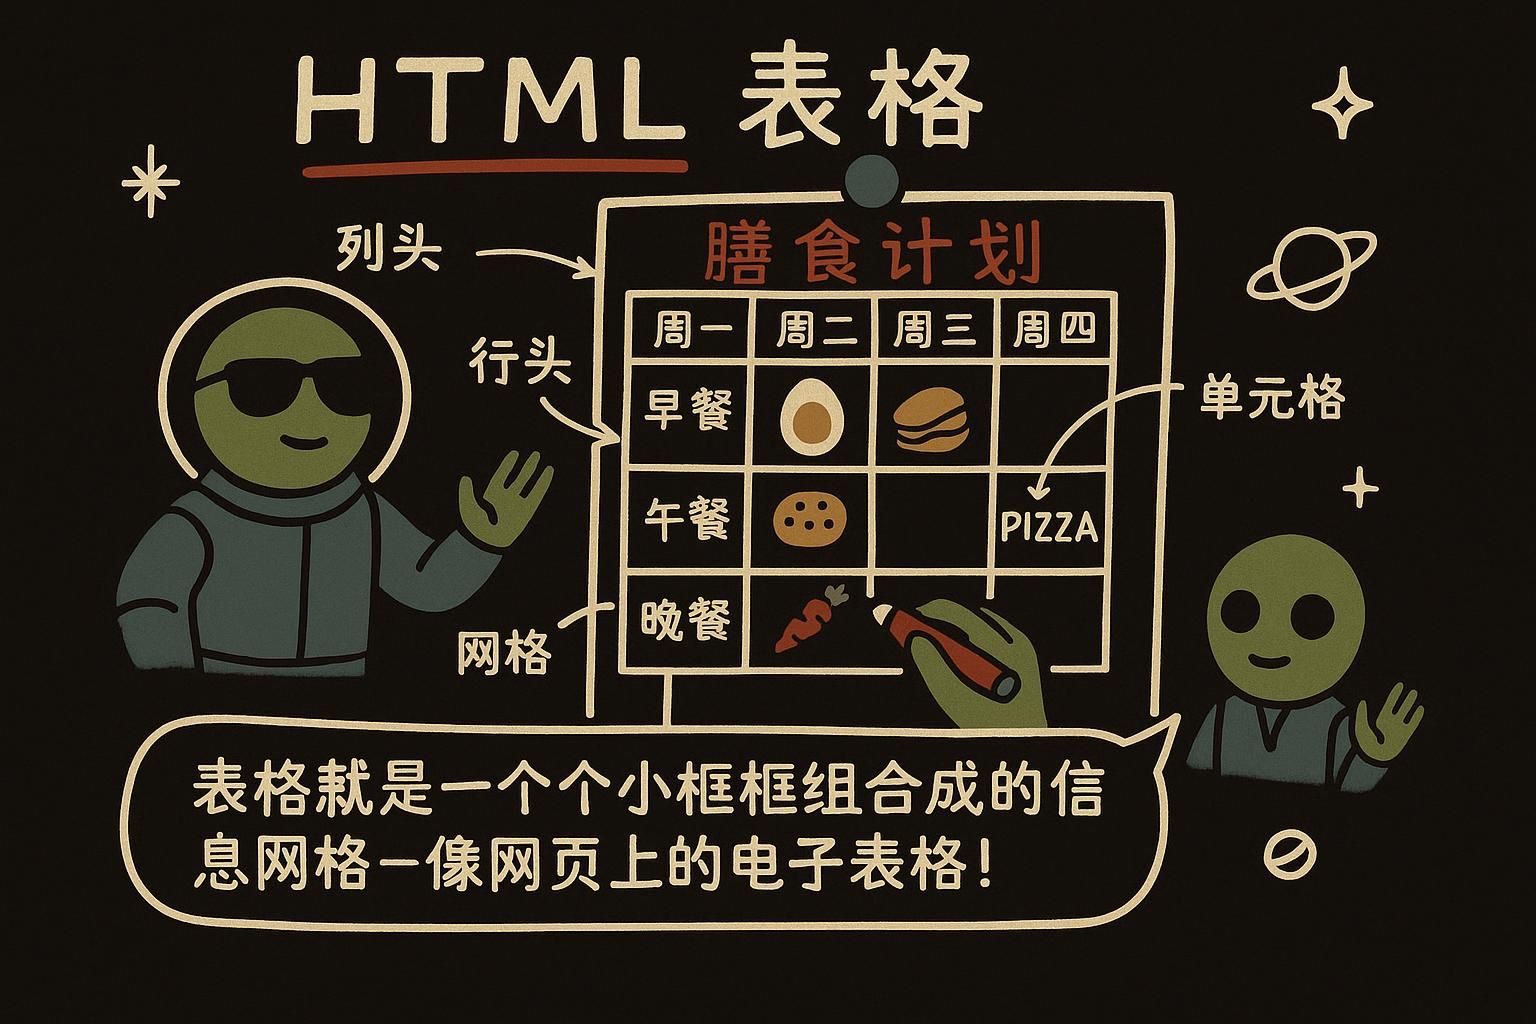
有些信息天生就是网格状的。火车时间表、价格方案、联赛排名、营养成分表:它们都有行和列,意义就藏在它们的对齐方式里。HTML 专门为这类内容准备了一组元素,用它们能让网格在屏幕上和被朗读软件读出来时都保持清晰易懂。

表格基础 ​

**表格**是一个由行和列组成的网格,形状和电子表格一样。你要用四个元素来搭建它。<table> 包住整个网格。每个 <tr> 是一行(tr 是 table row 的缩写)。在一行里,每个 <td> 是一个数据单元格(td 是 table data 的缩写)。当一个单元格是用来标注它所在的列或行时,就要换成 <th>(th 是 table header 的缩写),浏览器会把它显示为粗体并居中,让它跟数据区分开来。

搭建表格要一行一行地来,绝不能一列一列地来。<table> 是容器,每个 <tr> 是一行,单元格按它们在页面上出现的顺序排列在行内。数据单元格是 <td>;**表头单元格**是 <th>。没有专门表示"列"的元素。列只是每一行都按相同顺序排列单元格所产生的自然结果,所以只要有一行的单元格顺序乱了,整个网格就会对不齐。

<th> 和 <td> 的区别不只是外观上的。<th> 标记一个单元格是它所在行或列的标题。浏览器默认的粗体加居中样式,只是这一含义在视觉上的一半体现;另一半是可以被其他软件读取到的语义。

表格的源码是**按行组织**的:你一次写一行,每个单元格所属的列完全由它在这一行中的位置决定。浏览器逐行读取这份源码,再从中构建出一个二维网格,通过逐个计数来把单元格归入对应的列。标记里并没有任何东西显式命名一列,所以网格能不能对齐,完全取决于你各行写得是否一致。

<th> 和 <td> 的区分是语义上的,不是样式上的。<th>(表头单元格)会告诉浏览器,以及任何读取页面的辅助技术(比如屏幕阅读器这类把页面朗读出来给看不见的人听的软件),这个单元格是它周围数据的标签。默认的粗体居中外观只是附带效果:用 CSS 把它去掉,表头依然表示"这是标题",因为意义存在于元素本身,而不是它的外观。这正是为什么要用真正的表格,而不是用别的办法画一个看起来像网格的东西。

html
<table>
  <tr>
    <th>Day</th>
    <th>Opening hours</th>
  </tr>
  <tr>
    <td>Monday</td>
    <td>8:00 to 18:00</td>
  </tr>
  <tr>
    <td>Saturday</td>
    <td>9:00 to 14:00</td>
  </tr>
</table>

顶部两个表头单元格,接着是两行数据。浏览器会画出这个网格,按内容自动调整每列宽度,并把那两个 <th> 单元格渲染成粗体。
Juno表格基础 四个元素就能搭出一个网格:<table> 包住整体,<tr> 对应每一行,<td> 是一个单元格,<th> 是表头单元格。表头单元格会自动变成粗体并居中,跟数据区分开来。一行一行地搭建,列自然就会对齐。
Juno表格基础 表格是用 <tr> 一行一行铺开的,列则是每一行都保持相同单元格顺序自然产生的结果。表头用 <th>,数据用 <td>,这个选择关乎语义,不只是粗体外观。哪一行数一错单元格数量,整个网格就会歪掉。
Juno表格基础 标记是按行组织的,所以"列"之所以存在,是因为每一行都保持了单元格顺序的一致。数数要仔细。<th> 的价值在于能告诉屏幕阅读器这个单元格是一个标签,这一点是再多的 CSS 粗体样式都做不到的。这种语义上的区分,正是要用真正的表格的理由。

组织表格结构 ​

行的顺序就是别人阅读它们的顺序,所以要把由 <th> 单元格构成的**表头行**放在最上面。然后保证每一行长度一致:如果表头行有三个单元格,下面每个 <tr> 也都得有三个 <td> 单元格。少了一个单元格,网格里就会出现一个空缺,列也就对不齐了。这里没有新知识要学,只是要对你已经熟悉的行多加留意。

表格大了以后,把行归到**行分组**里,能让结构更明确。把表头行包在 <thead> 里,数据行包在 <tbody> 里,像合计这样的汇总行包在 <tfoot> 里。这些分组本身对布局的影响不大,但它们标注出了表格的各个部分,方便样式设置、打印,也方便辅助软件识别。

用 <caption> 给表格加个标题,把它放在 <table> 的第一个子元素位置。它会渲染在网格上方,而且和放在表格旁边的标题不同,它在标记层面就与表格绑定在一起。

当某个单元格需要跨越多列或多行时,用 colspan 或 rowspan。colspan="2" 让一个单元格占据两列的宽度;rowspan="2" 让它占据两行的高度。它所覆盖的那些位置就要从对应的行里省略掉,因为那个空间已经被占用了:

html
<thead>
  <tr>
    <th rowspan="2">Region</th>
    <th colspan="2">2024</th>
  </tr>
  <tr>
    <th>Q1</th>
    <th>Q2</th>
  </tr>
</thead>

"Region" 填满了两个表头行,"2024" 填满了两列,Q1 和 Q2 在第二行里排在它下方。

行分组不是装饰性的。<thead> 和 <tfoot> 被规定为在长表格打印时会在每一页上重复出现,好让表头在分页之后依然可见,它们也能让你在 <tbody> 滚动时保持表头或表尾固定不动。一个表格可以有多个 <tbody> 分组,这是把一大批数据拆分成带标签的若干区块、同时又不破坏整个网格的干净做法。

colspan 和 rowspan 控制**单元格跨度**(一个单元格覆盖多列或多行),这也是表格最容易悄无声息地出错的地方。每一行仍然必须覆盖整个网格的完整宽度。一个 colspan="2" 的单元格占据两列,那么它所跨越的那些行,就必须把这些位置留空,而不是自己再补一个单元格。数错了,浏览器照样会渲染出点东西来,但那不是你想要的网格。<caption> 是表格的无障碍名称:当读者到达这个表格时,辅助软件(比如把页面朗读出来的屏幕阅读器之类的工具)会把它读出来,这是旁边放一个标题做不到的事。

html
<table>
  <caption>Quarterly revenue by region</caption>
  <thead>
    <tr>
      <th>Region</th>
      <th>Q1</th>
      <th>Q2</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <th>North</th>
      <td>£12,000</td>
      <td>£15,400</td>
    </tr>
    <tr>
      <th>South</th>
      <td>£9,800</td>
      <td>£11,200</td>
    </tr>
  </tbody>
  <tfoot>
    <tr>
      <th>Total</th>
      <td>£21,800</td>
      <td>£26,600</td>
    </tr>
  </tfoot>
</table>
Juno组织表格结构 行是从上往下读的,所以要把由 <th> 单元格组成的表头行放在最前面。然后保证每一行长度一致:上面有三个表头,下面每一行就要有三个 <td> 单元格。少了一个单元格,网格就会出现空缺,这正是新手最容易踩的坑。
Juno组织表格结构 表格大了就分组:表头行用 <thead>,数据用 <tbody>,合计行用 <tfoot>,标题则用作为第一个子元素的 <caption>。colspan 和 rowspan 能把一个单元格跨列或跨行拉伸,但要记住被覆盖的位置需要从那些行里去掉。数对了,网格才不会散。
Juno组织表格结构 这些分组是有实际作用的:<thead> 和 <tfoot> 会在表格打印时重复出现,还能在正文滚动时固定住,<caption> 则是屏幕阅读器会读出来的名称。跨度是个不易察觉的陷阱,因为每一行仍然要填满整个网格宽度,被覆盖的位置就不能有单元格。浏览器对数错的情况照样会正常渲染出来,这正是它难被发现的原因。

无障碍表格 ​

一个具有无障碍性的表格,应该对每个人都讲得通,包括那些用**屏幕阅读器**(把页面朗读出来的软件)听页面而不是用眼睛看页面的人。你能做的最有用的事,其实早就在你的工具箱里了:每个表头单元格都用 <th>,而不是 <td>。这样屏幕阅读器就能告诉听的人哪些单元格是标签、哪些是数据,于是像"£15"这样的值,就会连同它所属的列一起被读出来。如果表格里所有单元格都是普通的 <td>,读出来就是一堵没有任何锚点的数字墙。

<th> 会标记一个单元格是表头,但在既有列标题又有行标题的表格里,它没说清楚是哪一种。scope 属性能把这一点明确出来。scope="col" 表示这个表头标注的是整个列;scope="row" 表示它标注的是整个行。给每个 <th> 都加上它,屏幕阅读器就能一次性把任何数据单元格和它对应的列标题、行标题都配对上。

html
<th scope="col">Month</th>
<th scope="row">Rainfall</th>

对于简单的网格,浏览器往往能自己猜出这些关联,但用 scope 明确写出来省去了猜测,而且加上它成本很低。

scope 能覆盖的是只有一层行表头和列表头的表格。复杂表格——比如表头跨越多列,或者列标题分了两层——即便用了 scope 也还是不明确,因为这时一个数据单元格上方已经不再只对应恰好一个列表头和一个行表头。对于这种情况,要用**id 和 headers**把单元格显式关联起来。给每个表头单元格一个 id(该元素独一无二的名字),再在每个数据单元格的 headers 属性里列出相关的那些 id:

html
<th id="q1">Q1</th>
<th id="north">North</th>
<td headers="north q1">£12,000</td>

这样数据单元格就明确指出了到底是哪些表头描述它,以及应该按什么顺序去读,不用任何算法去推断这层关系。这种写法比较繁琐,所以只用在真正需要的表格上。优先用 scope,只有当表头结构太不规则、scope 表达不了的时候,才升级到用 id 和 headers。

无障碍性涉及的范围远不止表格;无障碍性这一章讲了更完整的内容。

Juno无障碍表格 最大的收益不需要多花任何成本:表头用 <th>,数据用 <td>。屏幕阅读器靠这个区分,把每个值和它所属的表头一起读出来,所以 £15 会连着它所在的列一起出现,而不是孤零零一个数字。省掉这一步,整个表格听起来就是一堆散乱的数字。
Juno无障碍表格 给表头单元格加上 scope:列标题用 scope="col",行标题用 scope="row"。这样屏幕阅读器就能把每个数据单元格和横纵两个方向上对应的标题都对上号。简单的网格浏览器能自己猜,但明确写出来成本很低,还能省去猜测。
Juno无障碍表格scope 能应付普通的、每个方向只有一层表头的网格。当表头出现跨越或分层、一个单元格在某个方向上对应不止一个表头时,就换成在表头上用 id、在数据单元格上用 headers,手动把它们连起来。这种写法比较啰嗦,所以只用在真正需要的表格上,其他的交给 scope 就够了。

表格是用来做什么的 ​

在 CSS 还没能处理布局的那个年代,人们曾经用表格来搭建整个页面的布局:用一个 <table> 把菜单放在左边、内容放在右边。这种做法在视觉上确实能用,所以你还能在老页面和一些邮件模板里看到它。不要照着学。表格是用来放**表格数据**的,也就是本来就该排成行和列的信息。安排页面各部分的位置是 CSS 的工作。用表格来摆放东西而不是承载数据,会让页面对使用屏幕阅读器的人来说更难读,之后也更难调整。

这条规则很简单:<table> 意味着"这些内容是一组相互关联的数据网格"。只有当信息真正具有行和列的结构时才用它:时间表、对比表、结果列表。不要用它来做页面布局,也不要用它来对齐那些本来就不是数据的东西。CSS 的 grid 和 flexbox 才是真正处理布局的工具,它们能适应屏幕尺寸,也能让你的 HTML 保持描述内容本身,而不是描述排版方式。

用表格来实现分栏,是最典型的误用。如果内容是一个导航栏,或者是在页面上铺开的一个表单,那它就不是表格数据,即便硬凹也能凹出正确的样子,用表格依然是错的工具。

当你用表格来做布局时,你其实是把一个并非数据的东西,交给辅助软件(比如把页面朗读出来的屏幕阅读器一类工具)当作数据结构来处理。屏幕阅读器会先报出表格的行列数,再让用户一格一格地移动,把布局用的架子当成网格里一个个相互关联的值来对待。结果就是,本来是一个页头、一个侧边栏、一篇文章的东西,却被读成"表格,四列,十行"这样的播报。

这里还有一个阅读顺序的问题。辅助软件和搜索引擎按**源码顺序**读取页面,也就是元素在你 HTML 里出现的顺序,而不是它们在屏幕上恰好呈现的位置顺序。用表格做布局,会强行让你的源码顺序去匹配视觉上的网格排列,于是对听众来说本该排在最前面的内容——比如主体文章——可能会排在一列导航之后,只是因为视觉排列上需要它在那个位置。CSS 布局打破了这种绑定:你可以让重要内容在源码里靠前,同时还能把它放在屏幕上任何位置。让表格只承载数据,阅读顺序就始终由你说了算。

唯一比较模糊的例外是 HTML 邮件,因为一些老旧的邮件客户端至今仍不能可靠地支持 CSS 布局,基于表格的结构在那里依然常见。那是那个媒介本身的限制,不是应该拿回网页上重新用的模式。

html
<!-- Wrong: a table used to place a sidebar next to an article -->
<table>
  <tr>
    <td><nav>...</nav></td>
    <td><article>...</article></td>
  </tr>
</table>

<!-- Right: real elements, with CSS handling the columns -->
<nav>...</nav>
<article>...</article>

这和 什么是 HTML 里讲到的结构与呈现分离的原则是一致的:结构交给 HTML,布局交给 CSS。关于按语义来选择元素,可以参考语义化 HTML。

Juno表格是用来做什么的 表格是用来放数据的,是一组相互关联的值排成的行和列。它不是用来排版页面的,尽管老网站曾经那样用过。安排页面各部分的位置是 CSS 的工作,把这活儿硬塞给表格,会让页面更难被朗读出来,也更难修改。
Juno表格是用来做什么的 只有当内容真的是一组数据网格时才用 <table>:时间表、对比表、结果列表。要排版页面或对齐非数据内容,用 CSS 的 grid 或 flexbox,它们能适应屏幕,也能让你的 HTML 专注于内容本身。把表格拿来干布局的活,是最典型的用错工具。
Juno表格是用来做什么的 用来做布局的表格会误导屏幕阅读器:它听到的是一个数据网格,读出来的行列信息其实毫无意义。它还会把你的源码顺序死死钉在视觉网格上,而源码顺序才是辅助技术和搜索引擎真正读取的东西。让表格只管数据,把摆放交给 CSS,阅读顺序就还在你手里。HTML 邮件是唯一的例外,而且仅仅是因为它的客户端还停留在过去。