Skip to content
This page has been auto-translated and may contain errors.View in English

Cómo funciona la web ​

docs.scrimba.com

Cada página que abres sigue el mismo recorrido corto. Pides algo a través de su dirección, una máquina en algún lugar te devuelve un documento de texto, y tu navegador convierte ese texto en la página que ves. HTML es el lenguaje en el que está escrito ese texto, así que entender este recorrido es la base de todo lo demás en este manual.

Cliente y servidor ​

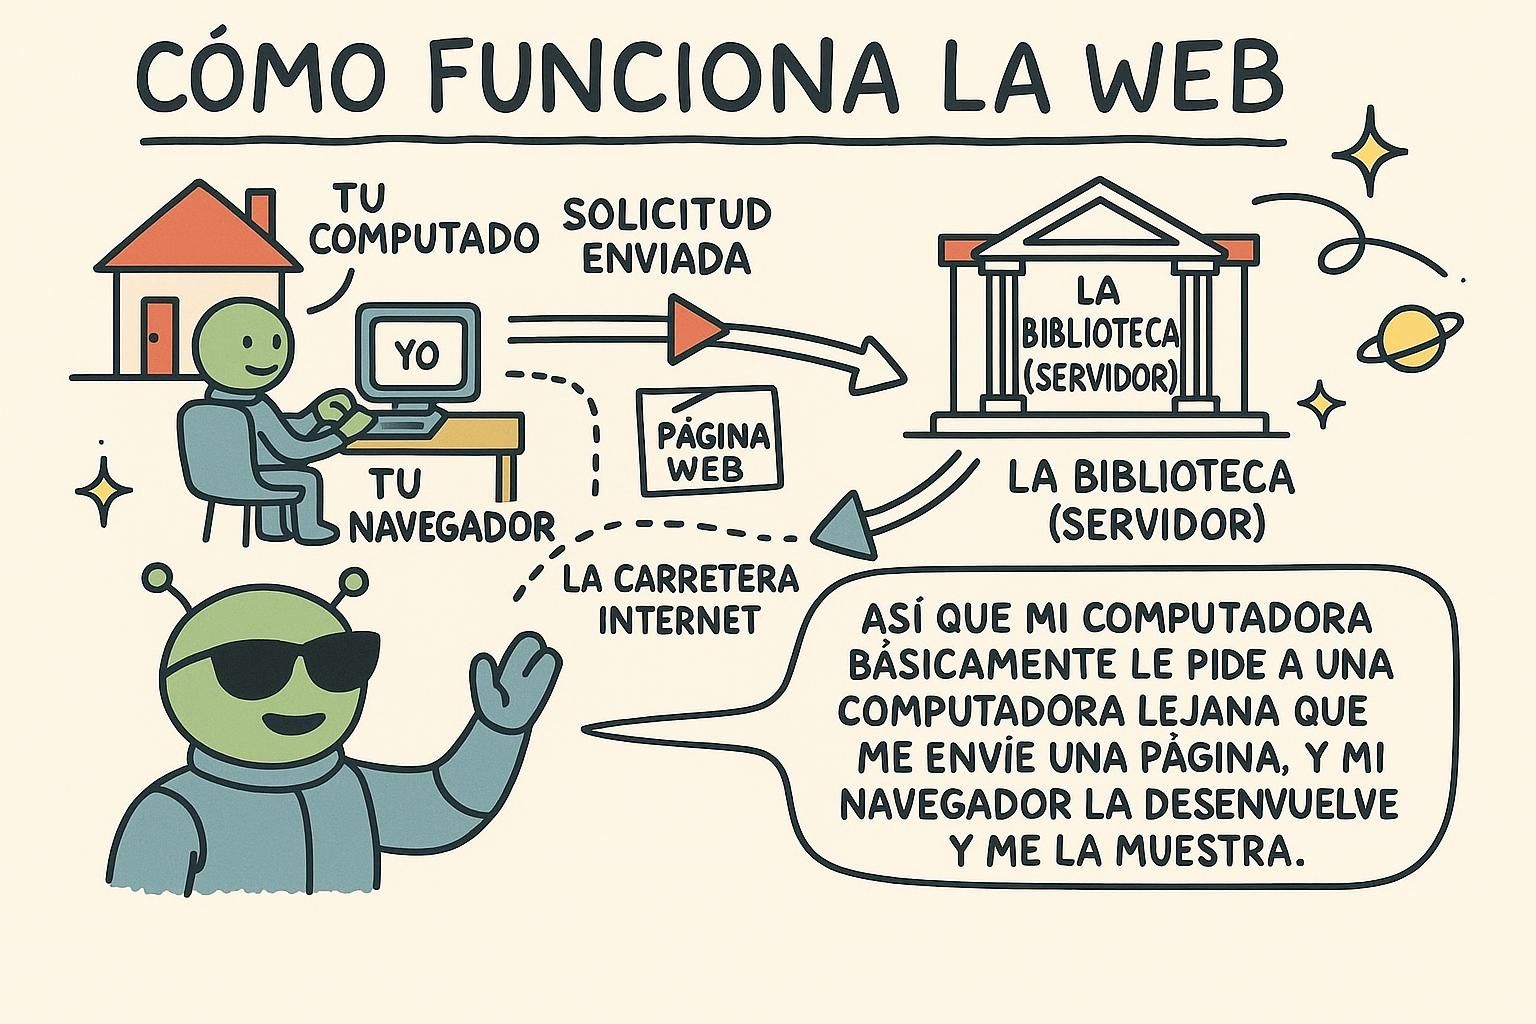
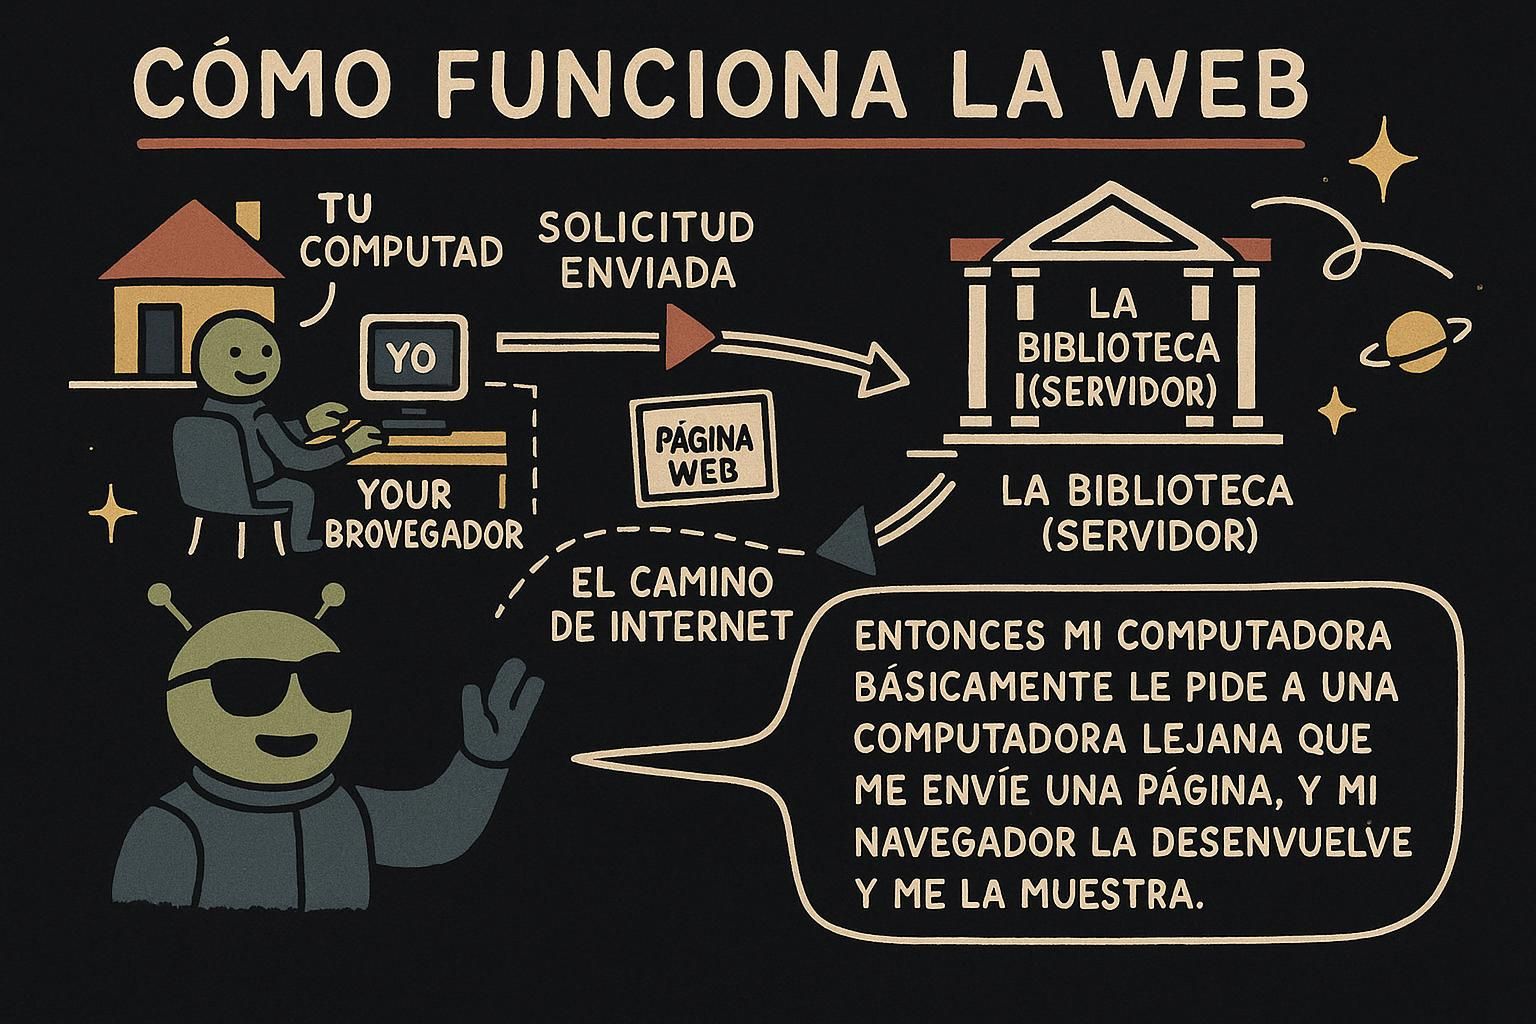
La web es una conversación entre dos partes. Tu navegador es el cliente: el programa que pide páginas. La máquina que guarda un sitio web y lo entrega es el servidor. Tú preguntas, él responde.

Piénsalo como pedir comida en un restaurante. Tú eres el cliente, la cocina está fuera de tu vista, y un mesero lleva tu pedido de un lado a otro. No entras a la cocina a cocinar. Pides un plato, y la cocina lo prepara y lo envía. Tu navegador es el cliente, el servidor es la cocina, y la web es el mesero que corre entre ambos.
Cada carga de página es un cliente hablando con un servidor. El cliente es el programa que hace la solicitud, casi siempre un navegador, aunque también puede ser una app móvil o una herramienta de línea de comandos. El servidor es un programa que corre en una máquina en algún lugar, esperando solicitudes y devolviendo respuestas.

La relación es unidireccional al inicio: el cliente siempre habla primero. Un servidor no te envía una página de la nada. Se queda esperando hasta que un cliente pide algo, y solo entonces responde. Un mismo servidor puede responder a miles de clientes a la vez, y por eso un único sitio web puede atender a muchos visitantes desde la misma dirección.

Cliente y servidor son roles, no máquinas fijas. Un cliente es cualquier cosa que inicia una solicitud; un servidor es cualquier cosa que espera solicitudes y devuelve respuestas. La misma computadora física puede ser servidor en una conexión y cliente en otra, por ejemplo un servidor web que a su vez llama a una base de datos.

El modelo funciona por solicitudes y es, en esencia, sin estado. Sin estado significa que el servidor trata cada solicitud como algo completo en sí mismo: por defecto no recuerda nada de la solicitud anterior. Por eso el inicio de sesión debe volver a establecerse en cada solicitud posterior, normalmente con una cookie o un token que el cliente envía cada vez, ya que la conexión en sí no guarda memoria. Mantener el protocolo sin estado es lo que permite que un solo servidor escale a un tráfico enorme, porque no mantiene un hilo abierto de contexto para cada visitante entre una solicitud y otra.

JunoCliente y servidor Dos partes, una sola conversación: tu navegador es el cliente que pregunta, el servidor es la máquina que responde. Como un cliente y una cocina con un mesero en medio, nunca entras a la cocina, haces el pedido y la comida sale lista. Guarda esta imagen en mente, todo lo demás en esta página es una versión de ella.
JunoCliente y servidor El cliente pregunta, el servidor responde, y el cliente siempre habla primero. Un mismo servidor atiende a muchos clientes a la vez, así es como una sola dirección sirve a toda una multitud de visitantes. Cuando algo carga, estás viendo una ronda de ese intercambio.
JunoCliente y servidor Cliente y servidor son roles, no cajas fijas, y la misma máquina puede cumplir ambos papeles. La web es sin estado por defecto, así que el servidor no recuerda nada entre solicitudes a menos que el cliente vuelva a enviar una prueba cada vez, que es justo lo que hace una cookie o un token. Esa falta de estado no es una limitación que hay que sortear, es lo que permite que un solo servidor aguante tráfico real.

URLs y dominios ​

La dirección que escribes es una URL: un Localizador Uniforme de Recursos. Es la dirección completa de una cosa en la web, de la misma forma en que una dirección postal apunta a una casa.

Mira https://scrimba.com/learn. La parte https indica cómo debe hablar el navegador con el servidor. La parte scrimba.com es el dominio, el nombre del sitio web, como la calle y la ciudad. La parte /learn es la ruta a una página en particular, como el número de la casa. Juntas apuntan exactamente a una página, y al escribirlas le dices al navegador a dónde ir.

Una URL está formada por partes, y nombrarlas hace que sea más fácil leerla en conjunto. Toma https://scrimba.com/learn/html:

  • https es el esquema: el protocolo que usa el navegador para obtener la página.
  • scrimba.com es el dominio: el nombre legible del sitio.
  • /learn/html es la ruta: qué página específica de ese sitio.

El dominio es un sustituto amigable de un número. Todo servidor es alcanzable mediante una dirección IP, una cadena como 192.0.2.10, y el nombre de dominio existe justamente para que no tengas que memorizarla. Cuando escribes un dominio, el navegador busca su dirección IP a través del DNS, el Sistema de Nombres de Dominio, que funciona como una guía telefónica que convierte nombres en números.

Una URL codifica todo lo que el navegador necesita para localizar un recurso, y cada segmento tiene una función. En https://shop.example.com:443/products?id=42#reviews: el esquema es https, shop es un subdominio, example.com es el dominio registrado, 443 es el puerto, /products es la ruta, ?id=42 es la cadena de consulta, y #reviews es el fragmento.

El puerto es la puerta numerada del servidor (443 es el valor por defecto para HTTPS, así que normalmente se omite). La cadena de consulta pasa parámetros al servidor, que pueden cambiar lo que este devuelve. El fragmento después del # lo maneja únicamente el navegador y nunca se envía al servidor; apunta a una ubicación dentro de la página. Resolver el dominio a una dirección IP pasa por el DNS (el Sistema de Nombres de Dominio, el directorio de la web que convierte nombres en números), y esa búsqueda es en sí misma un viaje de ida y vuelta por la red, así que una resolución de DNS en frío es latencia que el usuario paga antes de que llegue un solo byte de la página. Conocer esta anatomía es práctico: te dice qué puede ver el servidor (ruta y consulta), qué no puede ver (el fragmento), y dónde puede esconderse una primera carga lenta.

JunoURLs y dominios Una URL es la dirección completa de una página. El https indica cómo hablar con el servidor, el dominio como scrimba.com es el nombre del sitio, y la ruta como /learn apunta a una página específica de ese sitio. Léela de izquierda a derecha y te dice exactamente a dónde va el navegador.
JunoURLs y dominios Una URL se divide en esquema, dominio y ruta, y una vez que reconoces esas partes puedes leer cualquier dirección de un vistazo. El dominio es un nombre amigable para un número: el DNS es la guía telefónica que convierte scrimba.com en una dirección IP que el navegador realmente puede alcanzar. Esa búsqueda ocurre en silencio antes de que la página cargue.
JunoURLs y dominios Cada parte de una URL tiene su función: esquema, subdominio, dominio, puerto, ruta, consulta, fragmento. El servidor ve la ruta y la consulta pero nunca el fragmento, ya que la parte después de # se queda en el navegador. Y la resolución de DNS es un viaje de ida y vuelta real, así que una búsqueda en frío es latencia que el usuario paga antes del primer byte, algo que conviene recordar cuando una primera carga se siente lenta.

El ciclo de solicitud y respuesta ​

Cuando presionas enter, tu navegador envía una solicitud al servidor: un mensaje corto que dice "por favor, envíame esta página". El servidor devuelve una respuesta: la página misma. Esa ida y vuelta es un viaje completo, y es lo que ocurre cada vez que abres una página o haces clic en un enlace.

Imagina que le pides un libro a un bibliotecario. Le das el título (tu solicitud), el bibliotecario lo encuentra y te lo entrega (la respuesta), y ahora lo tienes en tus manos. Si el libro no existe, el bibliotecario te lo dice, y eso también es una respuesta. La web funciona igual, solo que mucho más rápido y muchas veces por segundo.

Una carga de página es una solicitud y una respuesta. El navegador envía una solicitud indicando qué página quiere y de qué forma la quiere; el servidor devuelve una respuesta que contiene la página, más un código de estado que indica cómo resultó la solicitud.

Vas a ver tres códigos de estado constantemente, así que aprende primero estos:

  • 200 OK: funcionó, aquí está lo que pediste.
  • 404 Not Found: el servidor está bien, pero no hay nada en esa dirección.
  • 301 Moved Permanently: esta página ahora vive en otro lugar, y el navegador debe seguir a la nueva dirección.

Lo que el servidor devuelve para una página normal no es una imagen de la página. Es un documento de texto plano escrito en HTML, con las mismas etiquetas que escribes a mano. El navegador recibe ese texto y a partir de él construye la página visible.

El ciclo de solicitud y respuesta lo define HTTP, el Protocolo de Transferencia de Hipertexto: el conjunto acordado de reglas sobre cómo un cliente y un servidor formulan sus mensajes. Una solicitud lleva un método (el verbo: GET para obtener, POST para enviar datos), una ruta, y encabezados (pares de nombre y valor con metadatos, por ejemplo qué formatos acepta el cliente). La respuesta lleva un código de estado, sus propios encabezados, y normalmente un cuerpo, el contenido en sí.

Los códigos de estado vienen en rangos, y el rango te dice a quién mirar. 2xx es éxito (200 OK). 3xx es redirección (301 Moved Permanently le dice al navegador y a los motores de búsqueda que el recurso tiene una nueva dirección canónica, así que vale la pena aplicarlo bien de cara al SEO). 4xx es un error del cliente, lo que significa que la solicitud estuvo mal (404 Not Found, 403 Forbidden). 5xx es un error del servidor, lo que significa que la solicitud estaba bien pero el servidor falló (500 Internal Server Error). La distinción es práctica: un 4xx te señala a la solicitud, un 5xx te señala al servidor. El cuerpo de la respuesta para un documento es texto HTML, y el encabezado Content-Type es lo que le indica al navegador que lo trate como HTML en lugar de texto plano o una imagen. Una línea más que vale la pena conocer: HTTP envía todo de forma legible por la red, mientras que HTTPS envuelve ese mismo protocolo en cifrado para que nadie en medio pueda leerlo o manipularlo, y por eso todo sitio real usa HTTPS hoy en día.

JunoEl ciclo de solicitud y respuesta Cada página es una ida y vuelta: tu navegador envía una solicitud que dice por favor envíame esto, y el servidor envía una respuesta con la página. Como pedirle un libro a un bibliotecario y que te lo entregue, o que te diga que no lo tiene. Ese viaje de ida y vuelta ocurre cada vez que abres una página, en silencio y muy rápido.
JunoEl ciclo de solicitud y respuesta Una solicitud de ida, una respuesta de vuelta, con un código de estado incluido. Aprende primero 200 (funcionó), 404 (no hay nada en esa dirección) y 301 (se movió, síguela), cubren la mayoría de lo que vas a ver. Y recuerda que lo que realmente vuelve para una página es texto HTML plano, no una imagen, que el navegador luego convierte en lo que ves.
JunoEl ciclo de solicitud y respuesta HTTP es la gramática del viaje: una solicitud tiene un método, una ruta y encabezados, una respuesta tiene un código de estado, encabezados y un cuerpo. Lee los códigos de estado por rango, un 4xx significa arreglar la solicitud, un 5xx significa que el servidor falló, y esa distinción te dice dónde mirar. El cuerpo es texto HTML etiquetado por Content-Type, y HTTPS es HTTP envuelto en cifrado, por eso todo sitio real lo usa.

Qué hace el navegador con el HTML que recibe ​

La respuesta es el HTML completo de una página, en forma de texto. Tu navegador lee ese texto de arriba a abajo y lo dibuja en pantalla: ve una etiqueta de encabezado y muestra texto grande y en negrita, ve una etiqueta de párrafo y muestra una línea de texto normal, ve una etiqueta de imagen y va a buscar la imagen.

Puedes pensarlo como leer una receta y cocinarla. El texto no es la comida, es la descripción de la comida, y el navegador es el cocinero que convierte esa descripción en algo que realmente puedes ver y usar. El mismo HTML siempre produce la misma página, porque el navegador sigue las mismas instrucciones cada vez.

El navegador no muestra el texto HTML tal cual, construye una página a partir de él. Mientras lee el documento de arriba a abajo, convierte las etiquetas en el DOM, el Modelo de Objetos del Documento: un árbol vivo de los elementos de la página, guardado en memoria. El DOM es lo que realmente se muestra, y lo que CSS y JavaScript leen y modifican después.

Aquí el orden importa. El navegador lee el documento en el orden en que lo escribiste, así que un <script> o una hoja de estilos cerca del inicio se procesan antes que el contenido que viene después. Esta es la razón práctica por la que las páginas colocan información sobre la página dentro de <head> y su contenido visible dentro de <body>, y por qué el lugar donde pones una etiqueta afecta cuándo ocurre su efecto. No solo estás enumerando elementos, le estás dando al navegador un orden de lectura.

Convertir HTML en píxeles es un proceso por etapas, y conocer su forma explica por qué algunas páginas se pintan más lento que otras. El navegador parsea el texto HTML (lo lee y construye una estructura) hacia el DOM (el Modelo de Objetos del Documento: el árbol en memoria de cada elemento). Parsea el CSS en un árbol paralelo, combina ambos, calcula la geometría (layout: dónde se ubica cada caja) y finalmente pinta los píxeles en pantalla.

Como el analizador lee de arriba a abajo, la ubicación cambia el momento en que algo ocurre. Un recurso es bloqueante para el renderizado cuando el navegador no pinta contenido hasta terminar de procesarlo. Una hoja de estilos en el <head> es bloqueante por diseño, para que la página no aparezca sin estilos por un instante, pero si es lenta detiene todo el primer pintado. Un <script> clásico en el <head> es peor: el analizador se detiene, descarga y ejecuta el script, y luego continúa, así que un script ubicado arriba en el documento retrasa cada elemento que viene después (los atributos defer y async existen justamente para romper ese bloqueo). Por eso el orden del documento y la ubicación dentro del <head> determinan qué se pinta primero: todo lo que está antes de un recurso bloqueante tiene que esperarlo.

Eso se conecta con la latencia, el tiempo que tarda un byte en viajar hasta el usuario, algo que ninguna velocidad local puede eliminar. Cada solicitud tiene un costo de ida y vuelta, así que menos solicitudes y bytes más pequeños y tempranos hacen que la página empiece a pintarse antes. La palanca que controlas en el HTML es el orden: coloca arriba en el documento lo que el usuario necesita ver primero, mantén los recursos bloqueantes fuera de su camino, y el primer pintado significativo llega antes. Menos bytes y más tempranos: ese es todo el juego del rendimiento en esta capa.

JunoQué hace el navegador con el HTML que recibe El HTML que llega de vuelta es una descripción de la página, y el navegador es el cocinero que la convierte en algo real. Lee de arriba a abajo: etiqueta de encabezado, texto grande en negrita, etiqueta de párrafo, texto normal, etiqueta de imagen, va a buscar la imagen. El mismo HTML de entrada da la misma página de salida, siempre.
JunoQué hace el navegador con el HTML que recibe El navegador lee tu HTML de arriba a abajo y construye el DOM, un árbol vivo de elementos que es lo que realmente se muestra. Como lee en orden, dónde pones una etiqueta decide cuándo entra en efecto, y esa es la razón real de la división entre head y body. Le estás dando al navegador un orden de lectura, más que un montón de elementos.
JunoQué hace el navegador con el HTML que recibe Parsear al DOM, combinar con CSS, calcular el layout, pintar: ese proceso explica por qué la ubicación cambia el tiempo. Todo lo que está antes de un recurso bloqueante tiene que esperarlo, así que una hoja de estilos lenta o un simple <script> en el head detienen el primer pintado, que es justo para lo que existen defer y async. Suma la latencia que no puedes eliminar, y la jugada es siempre la misma: menos bytes y más tempranos, con lo más importante arriba en el documento.