Skip to content
This page has been auto-translated and may contain errors.View in English

Como a web funciona ​

docs.scrimba.com

Toda página que você abre segue o mesmo trajeto curto. Você pede algo pelo endereço dele, uma máquina em algum lugar devolve um documento de texto, e seu navegador transforma esse texto na página que você vê. O HTML é a linguagem em que esse texto é escrito, então entender essa jornada é a base para tudo o mais neste guia.

Cliente e servidor ​

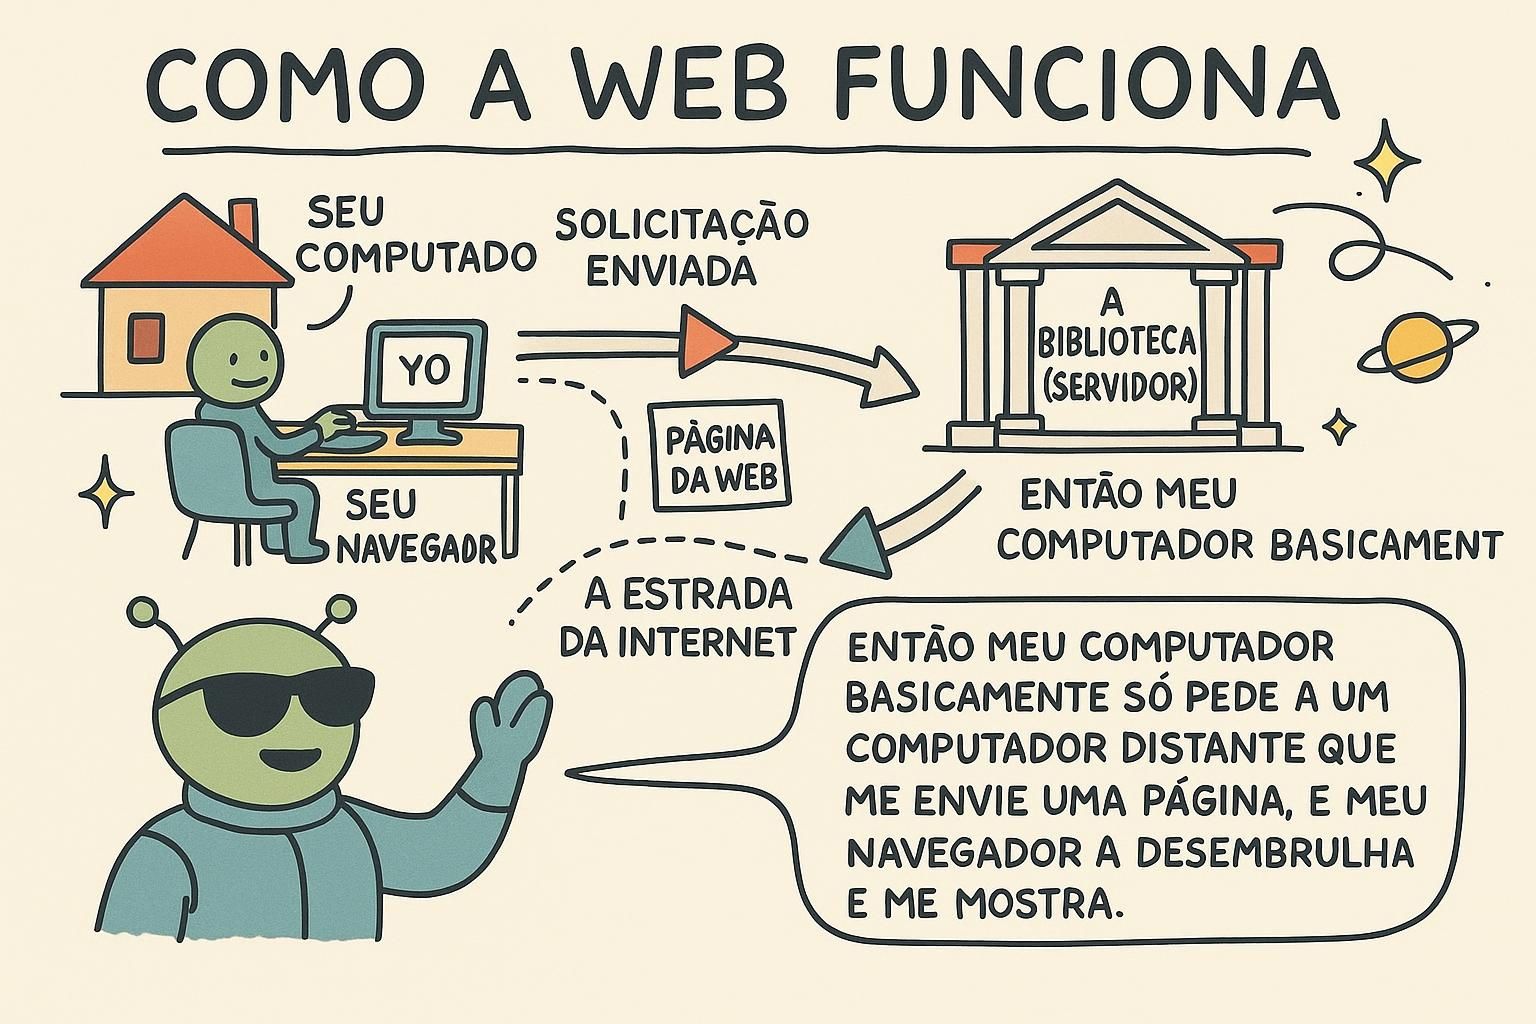
A web é uma conversa entre dois lados. Seu navegador é o cliente: o programa que pede as páginas. A máquina que guarda um site e o entrega é o servidor. Você pede, ele responde.

Pense em fazer um pedido em um restaurante. Você é o cliente, a cozinha fica fora de vista, e um garçom leva seu pedido de um lado para o outro. Você não entra na cozinha e cozinha o próprio prato. Você pede um prato, a cozinha o prepara e o envia. Seu navegador é o cliente, o servidor é a cozinha, e a web é o garçom que corre entre os dois.
Todo carregamento de página é um cliente conversando com um servidor. O cliente é o programa que faz a requisição, quase sempre um navegador, mas também pode ser um aplicativo de celular ou uma ferramenta de linha de comando. O servidor é um programa rodando em uma máquina em algum lugar, esperando requisições e devolvendo respostas.

A relação é de mão única no início: o cliente sempre fala primeiro. Um servidor não empurra uma página para você do nada. Ele fica esperando até que um cliente peça algo, e então responde. Um único servidor responde a milhares de clientes ao mesmo tempo, e é por isso que um único site pode atender muitos visitantes a partir do mesmo endereço.

Cliente e servidor são papéis, não máquinas fixas. Um cliente é o que quer que inicie uma requisição; um servidor é o que quer que escute requisições e devolva respostas. O mesmo computador físico pode ser servidor em uma conexão e cliente em outra, por exemplo um servidor web que ele mesmo chama um banco de dados.

O modelo é orientado a requisições e, no fundo, sem estado. Sem estado (stateless) significa que o servidor trata cada requisição como completa em si mesma: nada da requisição anterior é lembrado por padrão. É por isso que o login precisa ser reestabelecido em requisições posteriores, geralmente com um cookie ou token que o cliente envia a cada vez, porque a conexão em si não carrega memória nenhuma. Manter o protocolo sem estado é o que permite que um único servidor escale para um tráfego enorme, já que ele não precisa manter um contexto aberto para cada visitante entre uma requisição e outra.

JunoCliente e servidor Dois lados, uma conversa: seu navegador é o cliente que pede, o servidor é a máquina que responde. Como um cliente e uma cozinha com um garçom no meio, você nunca entra na cozinha, você faz o pedido e a comida sai. Guarde essa imagem, tudo o mais nesta página é uma versão dela.
JunoCliente e servidor O cliente pede, o servidor responde, e o cliente sempre fala primeiro. Um único servidor atende muitos clientes ao mesmo tempo, e é assim que um único endereço serve uma multidão inteira de visitantes. Quando algo carrega, você está vendo uma rodada dessa ida e volta.
JunoCliente e servidor Cliente e servidor são papéis, não caixas, e a mesma máquina pode desempenhar os dois. A web é sem estado por padrão, então o servidor não lembra de nada entre requisições, a menos que o cliente reenvie uma prova a cada vez, que é o que um cookie ou token faz. Essa ausência de estado não é uma limitação a ser contornada, é o que permite que um único servidor aguente tráfego real.

URLs e domínios ​

O endereço que você digita é uma URL: um Uniform Resource Locator (Localizador Uniforme de Recursos). É o endereço completo de uma coisa na web, da mesma forma que um endereço postal aponta para uma casa.

Olhe para https://scrimba.com/learn. A parte https diz como o navegador deve falar com o servidor. A parte scrimba.com é o domínio, o nome do site, como a rua e a cidade. A parte /learn é o caminho até uma página específica, como o número da casa. Juntas, elas apontam para exatamente uma página, e digitá-las diz ao navegador para onde ir.

Uma URL é feita de partes, e nomeá-las torna o conjunto mais fácil de ler. Veja https://scrimba.com/learn/html:

  • https é o esquema: o protocolo que o navegador usa para buscar a página.
  • scrimba.com é o domínio: o nome legível do site.
  • /learn/html é o caminho: qual página nesse site.

O domínio é um substituto amigável para um número. Todo servidor pode ser alcançado por um endereço IP, uma sequência como 192.0.2.10, e o nome de domínio é o que evita que você precise memorizá-lo. Quando você digita um domínio, o navegador procura o endereço IP correspondente por meio do DNS, o Domain Name System (Sistema de Nomes de Domínio), que funciona como uma lista telefônica que transforma nomes em números.

Uma URL codifica tudo o que o navegador precisa para localizar um recurso, e cada segmento tem uma função. Em https://shop.example.com:443/products?id=42#reviews: o esquema é https, shop é um subdomínio, example.com é o domínio registrado, 443 é a porta, /products é o caminho, ?id=42 é a query string, e #reviews é o fragmento.

A porta é a porta numerada do servidor (443 é o padrão para HTTPS, por isso geralmente é omitida). A query string passa parâmetros ao servidor, o que pode mudar o que ele devolve. O fragmento após o # é tratado apenas pelo navegador e nunca é enviado ao servidor; ele aponta para um local dentro da página. Resolver o domínio para um endereço IP passa pelo DNS (o Domain Name System, o catálogo de nomes para números da web), e essa consulta é, em si, uma ida e volta pela rede, então uma resolução de DNS "fria" é latência que o usuário paga antes de um único byte da página chegar. Conhecer essa anatomia é útil na prática: ela mostra o que o servidor pode ver (caminho e query), o que não pode (o fragmento), e onde um primeiro carregamento lento pode se escondER.

JunoURLs e domínios Uma URL é o endereço completo de uma página. O https diz como falar com o servidor, o domínio como scrimba.com é o nome do site, e o caminho como /learn aponta para uma página específica nele. Leia da esquerda para a direita e ela diz exatamente para onde o navegador está indo.
JunoURLs e domínios Uma URL se divide em esquema, domínio e caminho, e uma vez que você reconhece essas partes, consegue ler qualquer endereço rapidamente. O domínio é um nome amigável para um número: o DNS é a lista telefônica que transforma scrimba.com em um endereço IP que o navegador consegue realmente alcançar. Essa consulta acontece silenciosamente antes de a página carregar.
JunoURLs e domínios Cada parte de uma URL tem seu papel: esquema, subdomínio, domínio, porta, caminho, query, fragmento. O servidor vê o caminho e a query, mas nunca o fragmento, já que a parte depois do # fica só no navegador. E a resolução de DNS é uma ida e volta real pela rede, então uma consulta "fria" é latência que o usuário paga antes do primeiro byte, o que vale lembrar quando um primeiro carregamento parece lento.

O ciclo de requisição e resposta ​

Quando você aperta enter, seu navegador envia uma requisição ao servidor: uma mensagem curta que diz "por favor, me envie esta página". O servidor devolve uma resposta: a própria página. Essa ida e volta é uma viagem completa, e é o que acontece toda vez que você abre uma página ou clica em um link.

Imagine pedir um livro para um bibliotecário. Você dá o título (sua requisição), o bibliotecário encontra o livro e o entrega (a resposta), e agora você o tem em mãos. Se o livro não existir, o bibliotecário te avisa disso, o que também é uma resposta. A web funciona da mesma forma, só que muito mais rápido e muitas vezes por segundo.

Um carregamento de página é uma requisição e uma resposta. O navegador envia uma requisição nomeando a página que quer e como quer que ela seja entregue; o servidor devolve uma resposta contendo a página, além de um código de status que diz como a requisição foi.

Você vai ver três códigos de status constantemente, então aprenda estes primeiro:

  • 200 OK: funcionou, aqui está o que você pediu.
  • 404 Not Found: o servidor está bem, mas não há nada naquele endereço.
  • 301 Moved Permanently: essa página agora vive em outro lugar, e o navegador deve seguir para o novo endereço.

O que o servidor devolve para uma página normal não é uma imagem da página. É um documento de texto simples escrito em HTML, as mesmas tags que você escreve à mão. O navegador recebe esse texto e constrói a página visível a partir dele.

O ciclo de requisição e resposta é definido pelo HTTP, o HyperText Transfer Protocol (Protocolo de Transferência de Hipertexto): o conjunto acordado de regras sobre como um cliente e um servidor formulam suas mensagens. Uma requisição carrega um método (o verbo: GET para buscar, POST para enviar dados), um caminho, e cabeçalhos (pares de nome e valor com metadados, por exemplo quais formatos o cliente aceita). A resposta carrega um código de status, seus próprios cabeçalhos, e geralmente um corpo, o conteúdo em si.

Os códigos de status vêm em faixas, e a faixa te diz para onde olhar. 2xx é sucesso (200 OK). 3xx é redirecionamento (301 Moved Permanently diz ao navegador e aos motores de busca que o recurso tem um novo endereço canônico, o que vale a pena acertar para SEO). 4xx é erro do cliente, ou seja, a requisição estava errada (404 Not Found, 403 Forbidden). 5xx é erro do servidor, ou seja, a requisição estava correta, mas o servidor falhou (500 Internal Server Error). A distinção é prática: um 4xx aponta para a requisição, um 5xx aponta para o servidor. O corpo da resposta para um documento é texto HTML, e o cabeçalho Content-Type é o que diz ao navegador para tratá-lo como HTML em vez de texto simples ou imagem. Mais uma coisa que vale saber: o HTTP envia tudo de forma legível pela rede, enquanto o HTTPS envolve o mesmo protocolo em criptografia, de modo que ninguém no meio do caminho consiga ler ou adulterar os dados, e é por isso que todo site de verdade usa HTTPS hoje.

JunoO ciclo de requisição e resposta Toda página é uma ida e volta: seu navegador envia uma requisição que diz por favor me envie isso, e o servidor envia uma resposta com a página. Como pedir um livro a um bibliotecário e recebê-lo, ou ser avisado de que não está ali. Essa viagem de ida e volta acontece toda vez que você abre uma página, silenciosa e rápida.
JunoO ciclo de requisição e resposta Uma requisição vai, uma resposta volta, com um código de status junto. Aprenda primeiro 200 (funcionou), 404 (nada nesse endereço) e 301 (mudou de lugar, me siga), eles cobrem a maior parte do que você vai encontrar. E lembre-se de que o que realmente volta para uma página é texto HTML simples, não uma imagem, que o navegador então transforma na visualização.
JunoO ciclo de requisição e resposta HTTP é a gramática dessa viagem: uma requisição tem método, caminho e cabeçalhos, uma resposta tem código de status, cabeçalhos e um corpo. Leia os códigos de status por faixa, um 4xx significa corrigir a requisição, um 5xx significa que o servidor falhou, e essa divisão diz para onde olhar. O corpo é texto HTML identificado pelo Content-Type, e o HTTPS é o HTTP envolto em criptografia, e é por isso que todo site de verdade o usa.

O que o navegador faz com o HTML que recebe ​

A resposta é o HTML de uma página inteira, em forma de texto. Seu navegador lê esse texto de cima para baixo e o desenha na tela: ele vê uma tag de título e mostra um texto grande e em negrito, vê uma tag de parágrafo e mostra uma linha de texto comum, vê uma tag de imagem e busca a figura.

Você pode pensar nisso como ler uma receita e cozinhá-la. O texto não é a comida, é a descrição da comida, e o navegador é o cozinheiro que transforma a descrição em algo que você realmente pode ver e usar. O mesmo HTML sempre produz a mesma página, porque o navegador segue as mesmas instruções todas as vezes.

O navegador não exibe o texto HTML, ele constrói uma página a partir dele. Ao ler o documento de cima para baixo, ele transforma as tags no DOM, o Document Object Model (Modelo de Objeto do Documento): uma árvore viva dos elementos da página, mantida em memória. O DOM é o que de fato é exibido e o que o CSS e o JavaScript, depois, leem e alteram.

A ordem importa aqui. O navegador lê o documento na ordem em que você o escreveu, então um <script> ou uma folha de estilos próxima ao topo é processado antes do conteúdo abaixo dele. Essa é a razão prática pela qual as páginas colocam informações sobre a página no <head> e o conteúdo visível no <body>, e por que o lugar onde você coloca uma tag afeta quando o efeito dela acontece. Você não está apenas listando elementos, está entregando ao navegador uma ordem de leitura.

Transformar HTML em pixels é um pipeline, e conhecer seu formato explica por que algumas páginas pintam mais lentamente que outras. O navegador analisa (parse) o texto HTML (lê-o e constrói a estrutura) transformando-o no DOM (o Document Object Model: a árvore em memória de cada elemento). Ele analisa o CSS em uma árvore paralela, combina as duas, calcula a geometria (layout: onde cada caixa fica) e, por fim, pinta os pixels na tela.

Como o analisador lê de cima para baixo, a posição muda o momento em que as coisas acontecem. Um recurso é bloqueador de renderização (render blocking) quando o navegador não vai pintar o conteúdo até terminar de processar esse recurso. Uma folha de estilos no <head> é bloqueadora de renderização por design, para que a página não pisque sem estilo, mas uma folha de estilos lenta atrasa toda a primeira pintura. Um <script> clássico no <head> é ainda pior: o analisador para, baixa e executa o script, e só então retoma, então um script no início do documento atrasa todo elemento abaixo dele (os atributos defer e async existem justamente para quebrar esse bloqueio). É por isso que a ordem do documento e a posição no <head> decidem o que pinta primeiro: tudo acima de um recurso bloqueador espera por ele.

Isso se conecta à latência, o tempo que um byte leva para viajar até o usuário, o que nenhuma velocidade local consegue eliminar. Toda requisição tem um custo de ida e volta, então menos requisições e bytes menores e mais antecipados fazem a página começar a pintar mais rápido. A alavanca que você controla no HTML é a ordem: coloque o que o usuário precisa ver primeiro no início do documento, mantenha os recursos bloqueadores fora do caminho, e a primeira pintura significativa chega mais rápido. Menos bytes, chegando mais cedo, é todo o jogo de desempenho nesse nível.

JunoO que o navegador faz com o HTML que recebe O HTML que volta é uma descrição da página, e o navegador é o cozinheiro que a transforma na coisa real. Ele lê de cima para baixo: tag de título, texto grande e em negrito, tag de parágrafo, texto comum, tag de imagem, busca a figura. O mesmo HTML na entrada, a mesma página na saída, sempre.
JunoO que o navegador faz com o HTML que recebe O navegador lê seu HTML de cima para baixo e constrói o DOM, uma árvore viva de elementos que é o que realmente é mostrado. Como ele lê em ordem, onde você coloca uma tag decide quando ela entra em efeito, que é a razão real para a divisão entre head e body. Você está entregando ao navegador uma ordem de leitura, mais do que uma pilha de elementos.
JunoO que o navegador faz com o HTML que recebe Analisar para gerar o DOM, combinar com o CSS, montar o layout, pintar: esse pipeline explica por que a posição muda o momento das coisas. Tudo acima de um recurso bloqueador de renderização espera por ele, então uma folha de estilos lenta ou um <script> simples no head atrasa a primeira pintura, que é para isso que servem defer e async. Some a isso a latência que você não consegue eliminar, e a jogada é sempre a mesma: menos bytes, chegando mais cedo, com o que importa mais posicionado no início do documento.