 Learn Git and GitHub
¿Qué es Git?
Casi con certeza ya has hecho control de versiones a mano. Una carpeta con informe.docx, informe_final.docx, informe_final_v2.docx e informe_final_DEFINITIVO.docx es control de versiones, pero de la peor clase posible. No puedes saber qué cambió entre dos de esos archivos, no puedes combinar ediciones que hicieron dos personas al mismo tiempo, y definitivamente no puedes recuperar ese buen párrafo que borraste tres copias atrás.
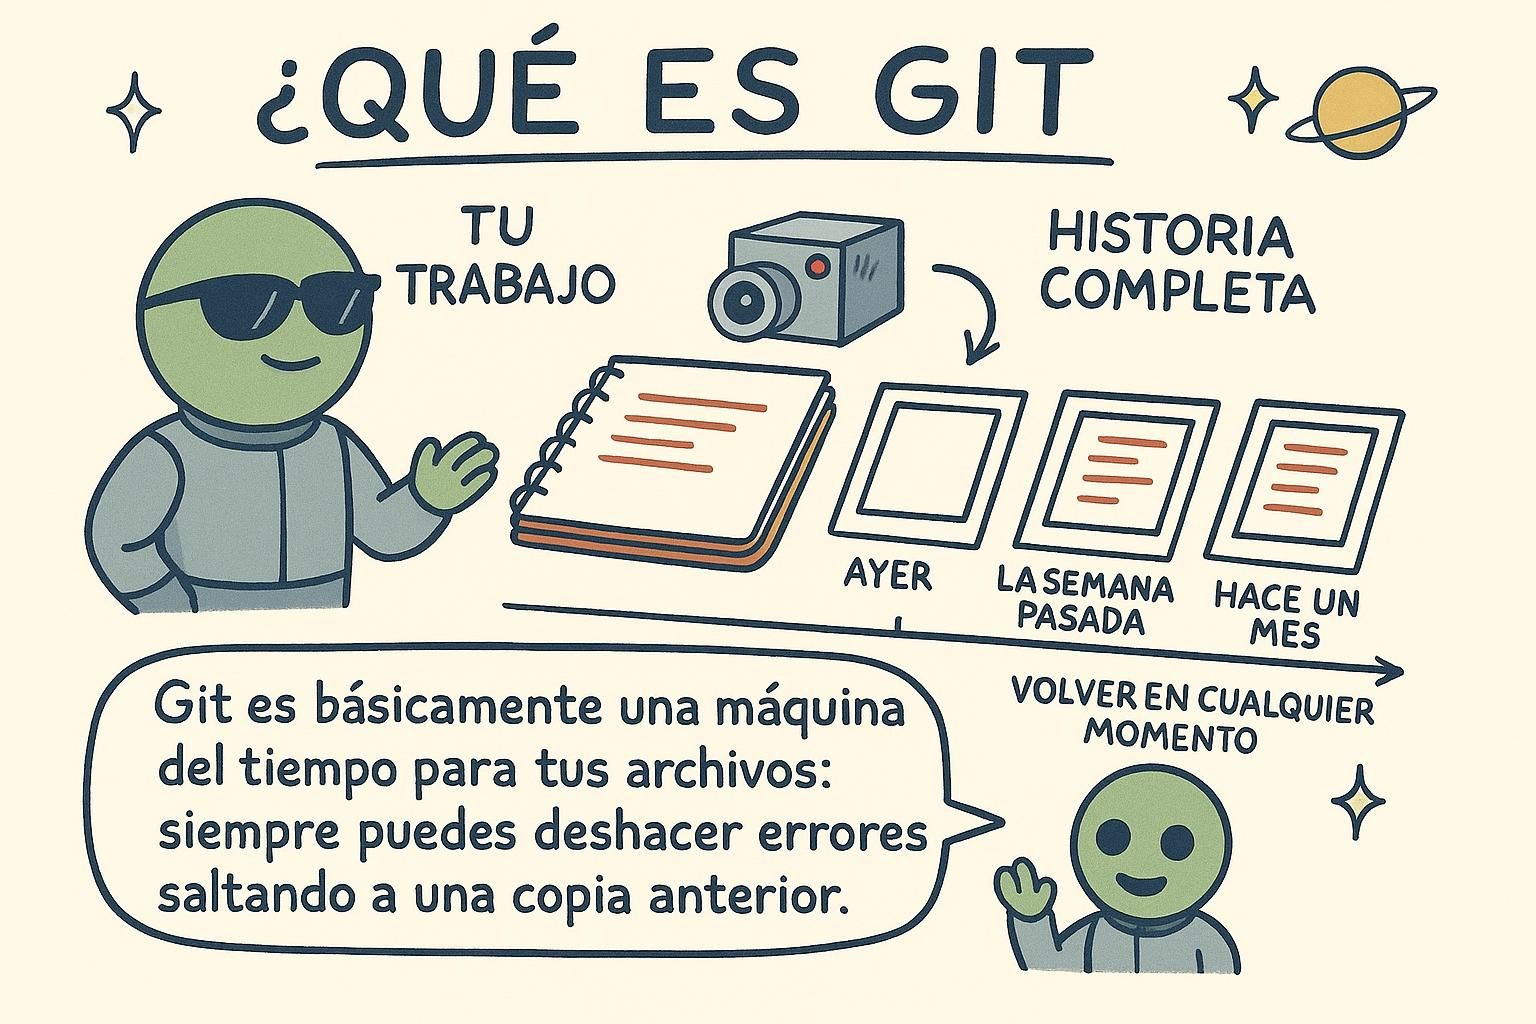
Git resuelve ese problema de raíz. Es una herramienta que registra instantáneas de tu proyecto a lo largo del tiempo, de modo que toda tu historia vive en un solo lugar en vez de estar repartida en un montón de copias. La herramienta en sí es un pequeño programa que corre en tu propia computadora: escribes comandos que empiezan con git en una terminal, y ella te responde en texto.
Qué hace Git por ti
En esencia, Git mantiene una línea de tiempo de tu proyecto. Cada vez que llegas a un punto que vale la pena guardar, registras un commit: una instantánea de todos los archivos, más un mensaje corto que describe qué cambió y por qué. Más adelante puedes revisar esa línea de tiempo y ver exactamente cómo el proyecto llegó a donde está. Aquí tienes una línea de tiempo real, impresa por git log, el comando que lista los commits de un proyecto (la opción --oneline acorta cada uno a una sola línea):
$ git log --oneline
a1b2c3d Agregar medidor de fortaleza de contraseña
9f8e7d6 Corregir validación del formulario de registro
5c4b3a2 Configurar estructura del proyecto
Eso son tres puntos guardados en la historia de un proyecto, el más reciente arriba, cada uno con un ID corto y el mensaje que escribió su autor. (En cada ejemplo como este, la línea que empieza con $ es un comando escrito en una terminal, sin incluir el $ mismo, y las líneas debajo son la respuesta de Git.) Vas a aprender cada comando que produce y lee este historial en los próximos capítulos. Por ahora, la idea que debes retener es que Git registra tu trabajo como una serie de instantáneas a las que siempre puedes volver.
Una vez que tu proyecto tiene un historial así, se vuelven posibles muchas cosas. Puedes ver qué cambió y quién lo cambió. Puedes probar una idea riesgosa por separado y descartarla limpiamente si no funciona. Puedes entregarle el proyecto completo, con toda su historia, a otra persona. Y cuando dos personas editan el mismo código, Git puede combinar su trabajo y marcar los puntos donde están en conflicto para que una persona los resuelva. Esas cuatro capacidades —historial, experimentos seguros, compartir y combinar trabajo— son la razón por la que Git funciona en casi todo proyecto de código profesional.
informe_final_v2_DEFINITIVO es justo el problema que Git nació para resolver, y te prometo que se siente genial la primera vez que borras una de esas. Git y GitHub son cosas distintas
Este punto confunde a casi todo el mundo al principio, así que vamos directo al grano. Git es la herramienta de control de versiones. Corre en tu propia computadora, registra tus commits, y no necesita conexión a internet ni ninguna cuenta para funcionar. GitHub es un sitio web que almacena repositorios Git en línea y agrega cosas alrededor de ellos: un lugar para compartir tu código, revisar los cambios de otros, reportar problemas y colaborar.
La forma más clara de sentir la diferencia: puedes usar Git todos los días, haciendo commits y ramas en tu laptop, sin crear nunca una cuenta de GitHub. GitHub solo entra en escena cuando quieres poner tu repositorio en algún lugar compartido para que otras personas, u otras máquinas, puedan acceder a él. Git es el motor; GitHub es un lugar donde puedes alojar lo que produce. Existen otros, como GitLab y Bitbucket, y todos alojan por debajo los mismos repositorios Git.
De dónde viene Git
La historia de Git explica bastante sobre por qué funciona como funciona. Fue escrito en 2005 por Linus Torvalds, la misma persona que inició Linux. El kernel de Linux lo construyen miles de voluntarios repartidos por todo el mundo, y durante varios años habían coordinado todo ese trabajo usando una herramienta comercial llamada BitKeeper, que la empresa detrás de ella dejaba usar gratis a proyectos de código abierto.
En 2005 ese acuerdo gratuito se rompió, y la comunidad del kernel de repente se quedó sin herramienta para gestionar su enorme y acelerada base de código. Nada de lo disponible en ese momento podía estar a la altura. Así que Torvalds se apartó del trabajo en el kernel durante un par de semanas y escribió su propia herramienta de control de versiones, con unos pocos objetivos firmes, moldeados justamente por ese problema.
Quería que fuera distribuida, de modo que cada colaborador tuviera el historial completo del proyecto en su propia máquina y pudiera trabajar sin depender de un servidor central. Quería que fuera rápida, lo suficiente para manejar un proyecto del tamaño del kernel sin hacer esperar a la gente. Y quería garantizar la integridad, de modo que nadie pudiera alterar el historial en silencio y que ningún error de disco pudiera corromper un proyecto sin que se notara.
Esos objetivos son la razón por la que Git se comporta hoy como se comporta. Cuando haces clone de un proyecto, obtienes todo su historial para trabajar con él, que es el objetivo de ser distribuido en acción: puedes hacer commits, ramificar y explorar el historial en un avión sin wifi. Y cada commit lleva una huella calculada a partir de su contenido exacto, así que si un solo byte cambia, la huella deja de coincidir y Git lo detecta. Las decisiones de diseño que Torvalds tomó a las carreras en 2005 son las que hoy sostienen todo lo que haces cuando usas Git.
clone te da todo el historial para trabajar sin conexión, y por eso cada commit obtiene una huella. Un contexto útil para una herramienta que vas a usar durante años. Hacia dónde va este manual a continuación
Con el modelo mental ya en su lugar, el resto del recorrido trata de ponerse a trabajar. Tu primer repositorio empieza desde cero: abrir una terminal, instalar Git si tu máquina no lo tiene, y convertir una carpeta en un repositorio al que puedas hacer commits. A partir de ahí vas a aprender el ciclo diario de guardar cambios, luego ramas, fusiones y el flujo de colaboración en GitHub. Si alguna vez un término te pierde, el Glosario tiene una definición breve para cada término de vocabulario de Git en estos documentos.