 Learn Git and GitHub
O que é Git?
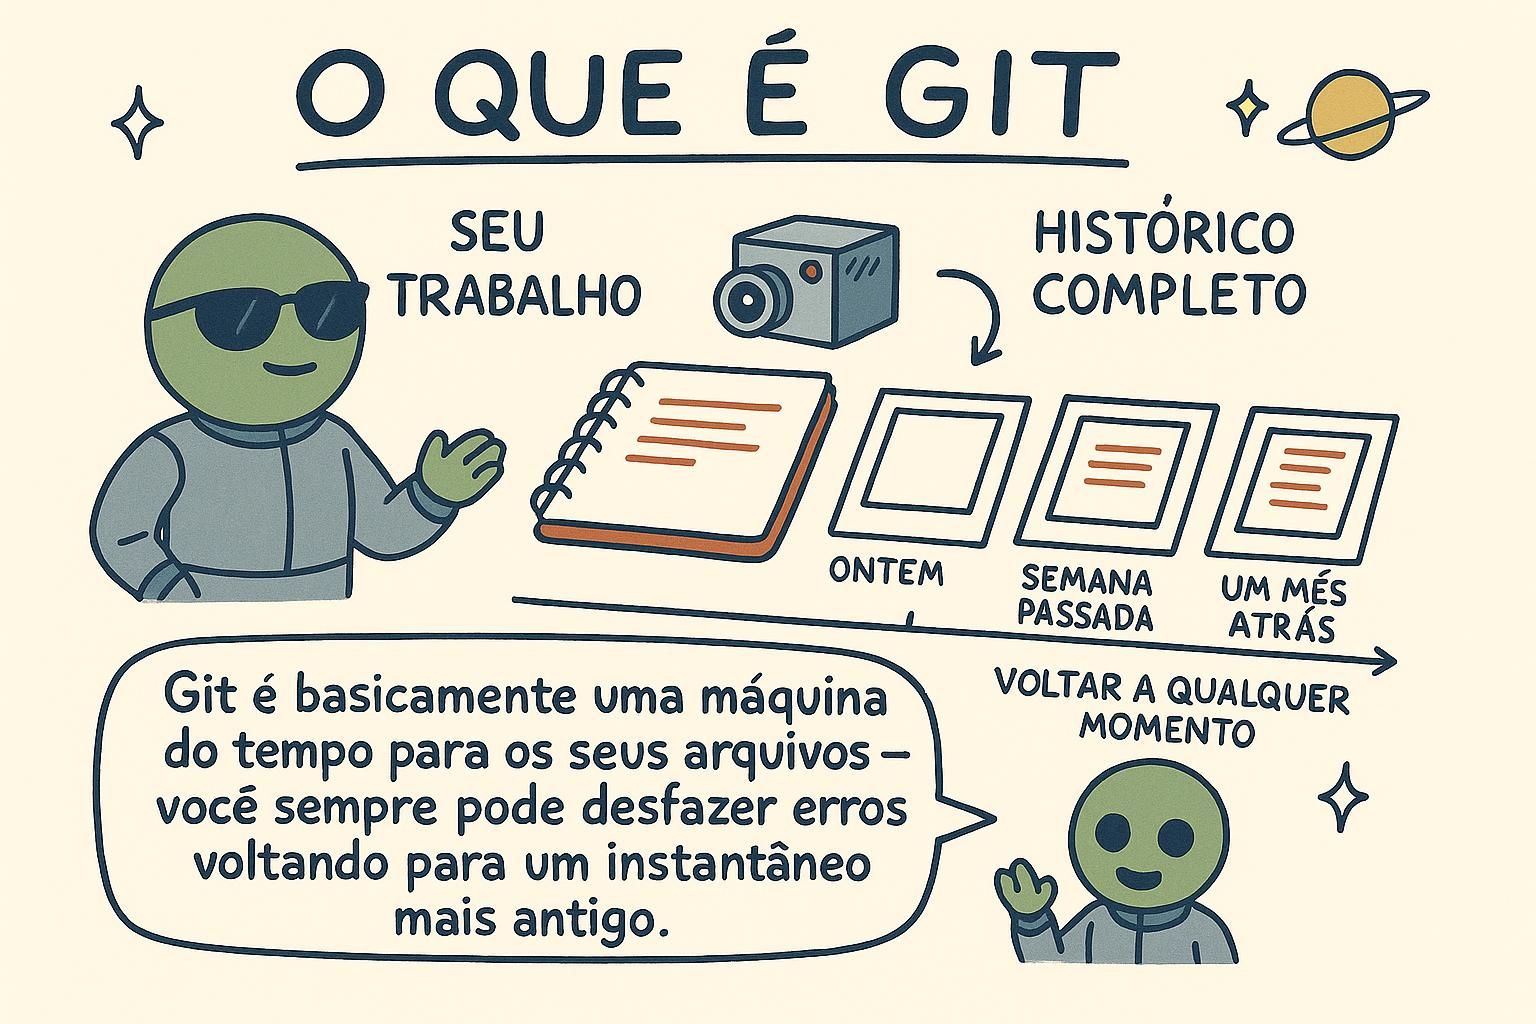
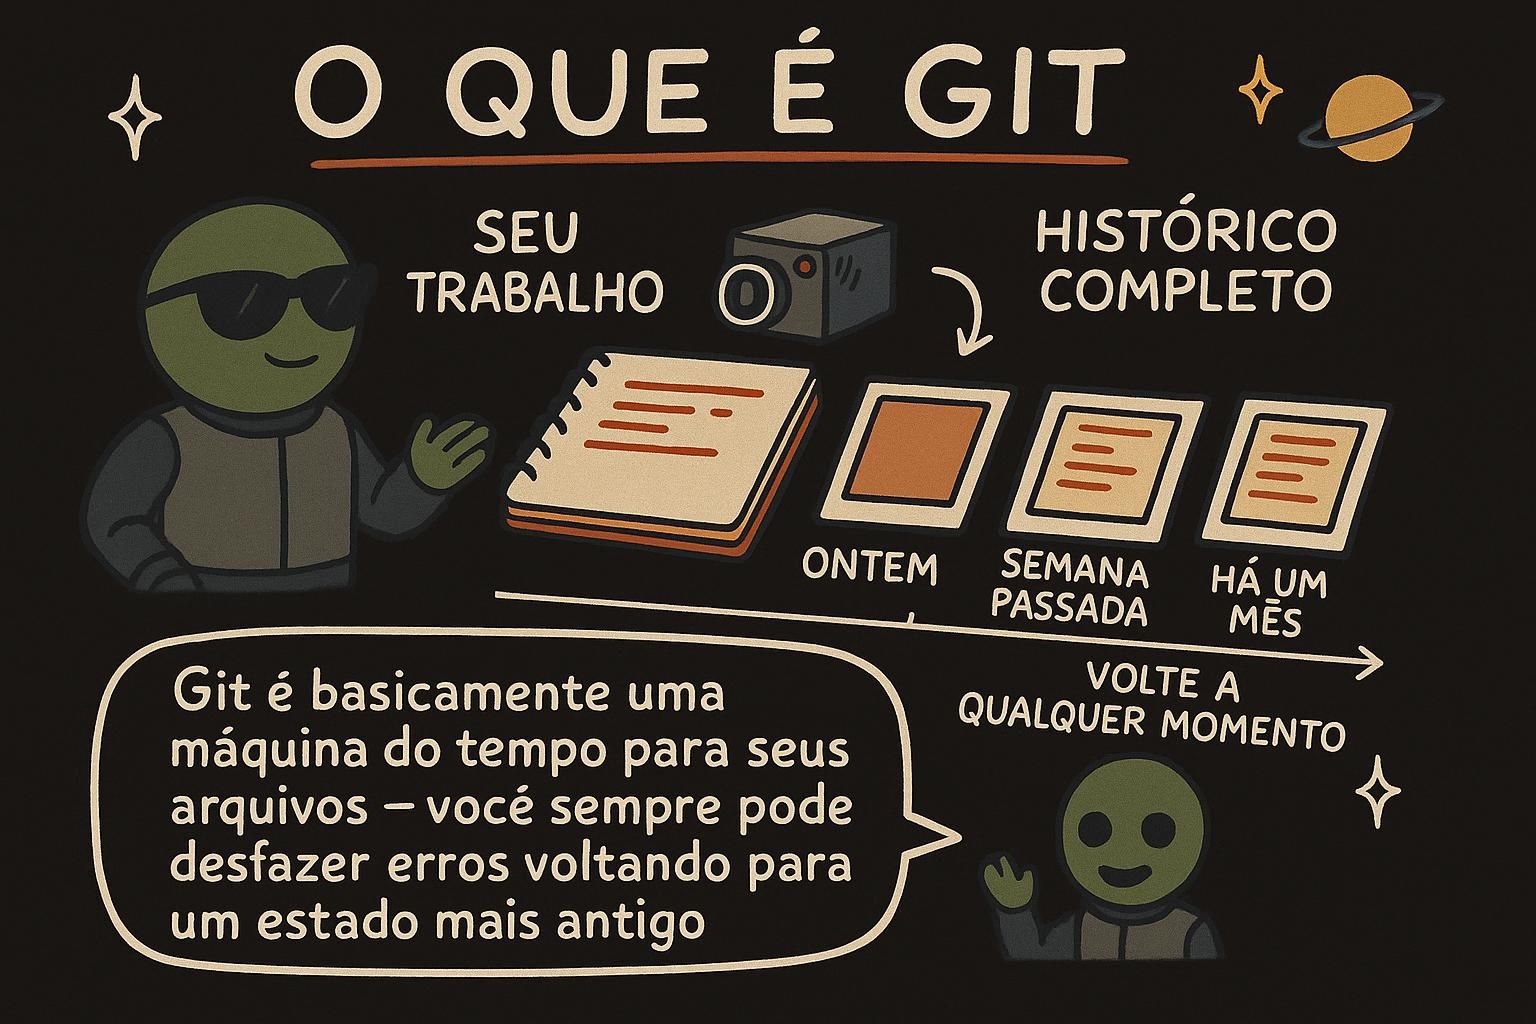
Você quase certamente já fez controle de versão na mão. Uma pasta com relatorio.docx, relatorio_final.docx, relatorio_final_v2.docx e relatorio_final_DEFINITIVO.docx é controle de versão, do peor tipo possível. Você não consegue saber o que mudou entre dois desses arquivos, não consegue combinar as edições que duas pessoas fizeram ao mesmo tempo, e definitivamente não consegue recuperar aquele parágrafo bom que você apagou três cópias atrás.
O Git resolve esse problema de verdade. É uma ferramenta que registra snapshots do seu projeto ao longo do tempo, de modo que todo o histórico fica em um único lugar, em vez de uma pilha de cópias. A ferramenta em si é um pequeno programa instalado no seu próprio computador: você digita comandos que começam com git em um terminal, e ele responde em texto.
O que o Git faz por você
No fundo, o Git mantém uma linha do tempo do seu projeto. Cada vez que você chega a um ponto que vale a pena salvar, você registra um commit: um snapshot de todos os arquivos, junto com uma mensagem curta descrevendo o que mudou e por quê. Depois, você pode olhar para trás nessa linha do tempo e ver exatamente como o projeto chegou até onde está. Aqui está uma linha do tempo real, impressa pelo git log, o comando que lista os commits de um projeto (a flag --oneline resume cada um a uma única linha):
$ git log --oneline
a1b2c3d Adiciona medidor de força de senha
9f8e7d6 Corrige validação do formulário de cadastro
5c4b3a2 Configura estrutura do projeto
Isso são três pontos salvos no histórico de um projeto, o mais recente no topo, cada um com um ID curto e a mensagem escrita por quem o criou. (Em todo exemplo como esse, a linha que começa com $ é um comando digitado em um terminal, sem o próprio $, e as linhas abaixo dela são a resposta do Git.) Você vai aprender todos os comandos que produzem e leem esse histórico nos próximos capítulos. Por agora, a ideia para guardar é que o Git está registrando seu trabalho como uma série de snapshots para os quais você sempre pode voltar.
Assim que seu projeto tem um histórico como esse, muita coisa se torna possível. Você pode ver o que mudou e quem mudou. Você pode testar uma ideia arriscada em paralelo e descartá-la de forma limpa se não der certo. Você pode entregar o projeto inteiro, com todo o seu histórico, para outra pessoa. E quando duas pessoas editam o mesmo código, o Git consegue combinar o trabalho de ambas e sinalizar os pontos em que elas discordam, para que uma pessoa resolva isso. Essas quatro capacidades, histórico, experimentos seguros, compartilhamento e combinação de trabalho, são o motivo pelo qual o Git roda por baixo de quase todo código profissional.
final_v2_DEFINITIVO é o problema que o Git foi criado para acabar, e eu prometo que é uma sensação ótima na primeira vez que você apaga uma dessas. Git e GitHub são coisas diferentes
Esse é o ponto que confunde quase todo mundo no início, então vamos direto ao ponto. O Git é a ferramenta de controle de versão. Ele roda no seu próprio computador, registra seus commits e não precisa de conexão com a internet nem de conta para funcionar. O GitHub é um site que armazena repositórios Git online e adiciona recursos ao redor deles: um lugar para compartilhar seu código, revisar as mudanças umas das outras, reportar problemas e colaborar.
O jeito mais claro de sentir a diferença: você pode usar o Git todos os dias, fazendo commits e criando branches no seu notebook, sem nunca criar uma conta no GitHub. O GitHub só entra em cena quando você quer colocar seu repositório em algum lugar compartilhado, para que outras pessoas, ou outras máquinas, possam acessá-lo. O Git é o motor; o GitHub é um dos lugares onde você pode hospedar o que ele produz. Existem outros, como o GitLab e o Bitbucket, e todos eles hospedam os mesmos repositórios Git por baixo dos panos.
De onde o Git veio
A história do Git explica muita coisa sobre por que ele funciona da forma como funciona. Ele foi escrito em 2005 por Linus Torvalds, a mesma pessoa que criou o Linux. O kernel do Linux é construído por milhares de voluntários espalhados pelo mundo, e por alguns anos eles coordenaram todo esse trabalho usando uma ferramenta comercial chamada BitKeeper, que a empresa por trás dela deixava projetos de código aberto usarem de graça.
Em 2005, esse arranjo gratuito acabou, e a comunidade do kernel de repente ficou sem uma ferramenta para gerenciar sua base de código enorme e em constante movimento. Nada mais disponível na época conseguia acompanhar o ritmo. Então Torvalds se afastou do trabalho no kernel por algumas semanas e escreveu sua própria ferramenta de controle de versão, com algumas metas firmes moldadas exatamente por esse problema.
Ele queria que ela fosse distribuída, de modo que cada colaborador tivesse o histórico completo do projeto na própria máquina e pudesse trabalhar sem precisar se conectar a um servidor central. Ele queria que ela fosse rápida, rápida o suficiente para lidar com um projeto do tamanho do kernel sem fazer as pessoas esperarem. E ele queria garantir a integridade, de modo que ninguém pudesse alterar o histórico silenciosamente e nenhum erro de disco pudesse corromper um projeto sem que isso fosse percebido.
Essas metas explicam por que o Git se comporta como se comporta hoje. Quando você faz clone de um projeto, você recebe todo o seu histórico para trabalhar, o que é a meta de ser distribuído em ação: você pode fazer commits, criar branches e navegar pelo histórico em um avião sem wifi. E cada commit recebe uma impressão digital calculada a partir do seu conteúdo exato, então, se um único byte mudar, a impressão digital deixa de coincidir e o Git percebe. As decisões de design que Torvalds tomou às pressas em 2005 são as mesmas em que você se apoia toda vez que usa o Git hoje.
clone te dá o histórico completo para trabalhar offline, e por que cada commit recebe uma impressão digital. Um contexto útil para uma ferramenta que você vai usar por anos. Para onde este manual vai a seguir
Com o modelo mental estabelecido, o restante da trilha é sobre pôr a mão na massa. Seu primeiro repositório começa do zero: abrindo um terminal, instalando o Git se a sua máquina ainda não tiver, e transformando uma pasta em um repositório no qual você pode fazer commits. A partir daí, você vai aprender o ciclo do dia a dia de salvar mudanças, depois branches, merges e o fluxo de colaboração no GitHub. Se algum termo te deixar perdido, o Glossário tem uma definição curta para cada palavra do vocabulário do Git usada nestes documentos.