Skip to content
This page has been auto-translated and may contain errors.View in English

Ignorando archivos y buenos hábitos ​

docs.scrimba.com

Clonas un proyecto llamado weather-app, corres npm install, y revisas el estado de tu nuevo repositorio.

bash
$ git status
Untracked files:
  (use "git add <file>..." to include in what will be committed)
	node_modules/
	dist/
	.env

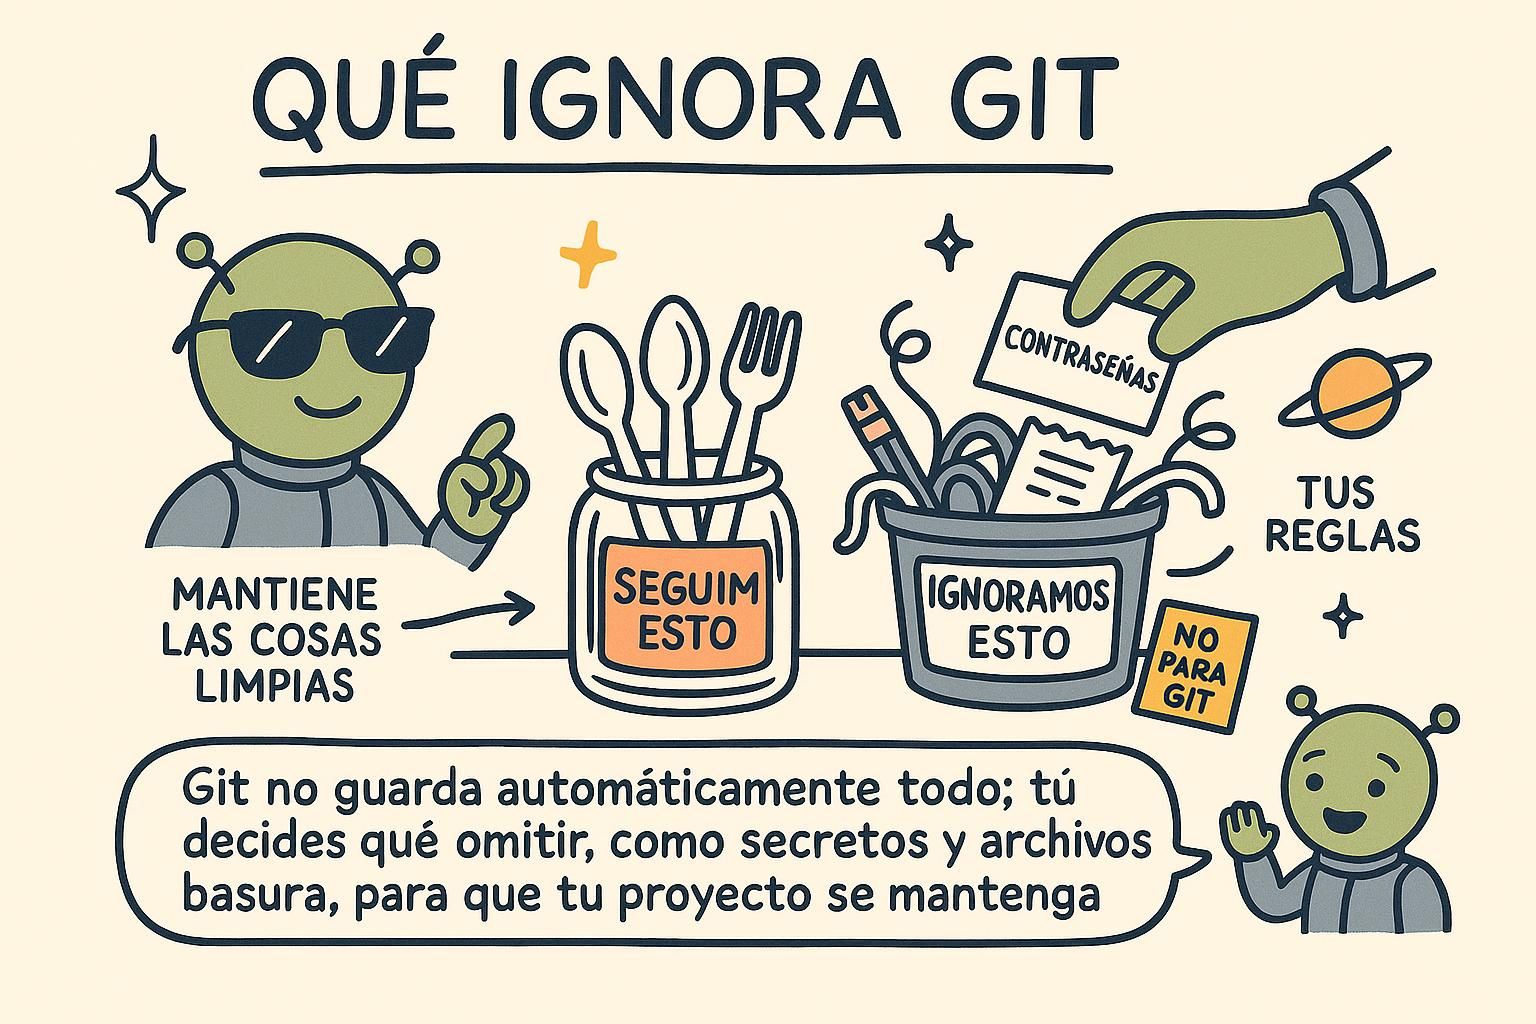
Aparecen tres carpetas y archivos como no rastreados, y ninguno de ellos debería estar en un commit. node_modules/ son miles de archivos que npm install regenera desde package.json en segundos. dist/ es el resultado del build, que se reconstruye a partir de tu código fuente cada vez. Y .env guarda una API key. Nada de eso debería terminar jamás en el historial de tu proyecto, y escribir git add . sin pensarlo es justo cómo pasa.

Decirle a Git qué debe ignorar ​

Un archivo .gitignore lista patrones de archivos y carpetas que Git nunca debe rastrear. Lo creas una sola vez en la raíz de tu proyecto, el mismo lugar donde corriste git init cuando configuraste el repositorio en Tu primer repositorio, y desde ese momento, git status y git add . ignoran silenciosamente todo lo que coincida.

bash
# .gitignore
node_modules/
dist/
.env

Cada línea es un patrón: un nombre de carpeta simple como dist/ ignora toda esa carpeta, dondequiera que aparezca en el proyecto. Haz commit del archivo .gitignore mismo. Es pequeño, le es útil a cualquiera que clone el proyecto, y pertenece al historial igual que tu código fuente.

bash
$ git status
On branch main
nothing to commit, working tree clean

Con los patrones en su lugar, git status se queda callado. Ese es justamente el punto: las carpetas y archivos que nunca quieres comitear dejan de aparecer como ruido, así que lo que sí aparece es realmente lo que importa.
Los patrones admiten globs, así que *.log ignora todo archivo que termine en .log, sin importar su nombre. Una barra al final restringe un patrón a directorios, así que dist/ solo coincide con una carpeta llamada dist y deja en paz a cualquier archivo que casualmente comparta ese nombre. Empieza una línea con ! para dejar de ignorar algo que un patrón más amplio atraparía de otra forma, útil cuando un archivo dentro de una carpeta ignorada necesita rastrearse:

bash
# .gitignore
logs/
!logs/keep-this.log

Git también lee un archivo de ignorados global, uno por máquina, para los patrones que quieres en todos los repositorios sin importar el proyecto: basura de editor como .DS_Store o *.swp. Configúralo una sola vez con git config --global core.excludesfile ~/.gitignore_global, y nunca más tendrás que agregar esos patrones proyecto por proyecto.

Los patrones de ignorados se comparan de la misma forma que los globs de la shell: * para cualquier secuencia de caracteres, ? para uno solo, ** para coincidir a través de directorios. Un patrón sin barra coincide en cualquier nivel de profundidad del proyecto, mientras que un patrón que contiene una barra queda anclado a esa ruta. La comparación de estos patrones es un comportamiento puramente local: Git solo consulta .gitignore al decidir qué te muestra git status y git add. Esto no impide que un archivo siga rastreado una vez que Git ya lo tiene, algo que importa en la siguiente sección.

JunoDecirle a Git qué debe ignorar Un archivo .gitignore lista lo que Git nunca debe rastrear: node_modules/, dist/ y .env son los sospechosos habituales en casi cualquier proyecto. Haz commit del archivo .gitignore mismo para que todos los que clonen el proyecto obtengan el mismo estado limpio. Una vez perdí toda una tarde agregando por accidente miles de archivos de dependencias al staging antes de aprender esto.
JunoDecirle a Git qué debe ignorar Los patrones admiten globs como *.log, una barra al final significa "solo directorio", y un ! al inicio deja de ignorar algo dentro de una coincidencia más amplia. Un archivo de ignorados global, configurado con core.excludesfile, es donde debe ir la basura del editor y del sistema operativo, para que deje de agregar .DS_Store a mano en el .gitignore de cada proyecto.
JunoDecirle a Git qué debe ignorar Las reglas de ignorados son coincidencias de tipo glob de la shell, aplicadas del lado del cliente, y solo cambian lo que Git te muestra como no rastreado. Ten en cuenta que una regla solo puede afectar a un archivo que Git aún no conoce. Esa distinción es pequeña en el papel y costosa en la práctica.

Nunca comitees secretos ​

Una API key, una contraseña de base de datos o un certificado de firma nunca deberían aparecer en un commit. Eso vale tanto para un repositorio privado como para uno público, y vale desde el primer commit en adelante. Pon los secretos en un archivo como .env, agrega ese archivo a .gitignore desde el primer día, y carga los valores en tu aplicación desde ahí en vez de escribirlos directamente en tus archivos de código.

bash
# .env
WEATHER_API_KEY=sk_live_9f8e7d6c5b4a
bash
# .gitignore
.env

Sigue esta regla de forma automática, siempre, sin excepciones. Una clave que quede en un commit es accesible para cualquiera con acceso al repositorio, y en un repositorio público, para cualquier persona.

En un proyecto real, los secretos suelen vivir en más de un lugar: un archivo .env para tu propia máquina, y un gestor de secretos o la configuración de variables de entorno de tu servicio de hosting para lo que se despliega. Ambos funcionan igual en la práctica: el valor vive fuera de tus archivos de código y fuera de Git, y tu código lo lee desde el entorno en tiempo de ejecución. Publica en su lugar un archivo .env.example, con los nombres de las variables pero sin valores reales, para que tus compañeros de equipo sepan qué configurar sin ver nunca tu clave real.

Este es el hecho que hace que esta regla no sea negociable: un commit del que borras un secreto no lo elimina del historial. Todo commit anterior que tenía la clave sigue teniéndola, guardada para siempre en el historial del repositorio, y cada clon que alguien haya hecho carga esos commits antiguos junto con él. Borrar el archivo en un commit nuevo solo significa que la instantánea más reciente ya no lo tiene; el objeto que guarda el valor antiguo sigue ahí en .git, accesible para cualquiera que revise un commit anterior o busque en el log.

"Borrar el archivo y comitear de nuevo" nunca arregla un secreto que ya se filtró. Si un secreto real llega a aparecer en un commit, rótalo o revócalo en el proveedor (emite una clave nueva, invalida la vieja) para que el valor filtrado deje de servir, sin importar lo que hagas después con el repositorio. Reescribir el historial para eliminar un secreto es posible, pero no anula ningún uso que la clave ya haya tenido mientras estuvo expuesta. Trata la rotación como la solución que realmente importa y la limpieza del historial como un extra opcional encima de eso.

JunoNunca comitees secretos Nunca pongas una API key real, una contraseña o un certificado en un commit. Guarda los secretos en un archivo como .env y agrega .env a tu .gitignore antes de correr git add por primera vez. Esta es la única regla de todo este capítulo que vale la pena tratar como absoluta.
JunoNunca comitees secretos Los secretos locales van en .env, los secretos de producción van en las variables de entorno de tu servicio de hosting o en un gestor de secretos, y ninguno de los dos se comitea jamás. Publica un .env.example con solo los nombres de las variables, para que tus compañeros de equipo sepan qué configurar sin ver un valor real.
JunoNunca comitees secretos Borrar un secreto en un commit nuevo no lo elimina del historial. Todo commit anterior y todo clon existente sigue teniéndolo. Rota la clave en el proveedor en el momento en que se filtre: esa rotación es la solución que realmente importa.

Agregar un archivo a .gitignore después de que ya está rastreado ​

Este es el tropiezo que atrapa a casi todo el mundo al menos una vez. Comiteas un archivo por accidente, te das cuenta del error, lo agregas a .gitignore (la línea de echo de abajo añade la ruta a ese archivo), y esperas que Git lo olvide. No lo hace.

bash
$ git add config/settings.json
$ git commit -m "Add app settings"

# más adelante, te das cuenta de que fue un error
$ echo "config/settings.json" >> .gitignore
$ git status
On branch main
nothing to commit, working tree clean

git status muestra un árbol limpio, pero config/settings.json sigue rastreado y sigue apareciendo en cada git log futuro y en cada clon. Las reglas de ignorados solo aplican a archivos que Git aún no conoce. Una vez que un archivo fue agregado y comiteado, es parte de tu historial, y .gitignore no tiene ninguna opinión sobre archivos que ya están en ese historial.

Para realmente dejar de rastrearlo de ahí en adelante, dile a Git que deje de seguirlo, dejando el archivo intacto en tu disco:

bash
$ git rm --cached config/settings.json
$ git commit -m "Stop tracking config/settings.json"

git rm --cached <archivo> quita el archivo del rastreo de Git sin borrarlo de tu directorio de trabajo. Comitea esa eliminación, y desde ese momento tu patrón en .gitignore hace el trabajo que querías que hiciera desde el principio.

El mismo arreglo funciona con una carpeta completa usando git rm -r --cached <carpeta>, que es lo que suele hacerse después de darse cuenta de que node_modules/ o dist/ se comitearon al inicio de la vida de un proyecto, antes de que alguien agregara un .gitignore. Corre el comando una vez, comitea la eliminación, y la carpeta desaparece de los commits futuros mientras la copia local de los archivos de cada compañero de equipo se queda intacta en el disco.

Este comportamiento se deriva directamente de lo que realmente es el área de staging. Git rastrea los archivos a través del índice, el registro exacto de lo que va a entrar en el próximo commit. Agregar y comitear un archivo escribe una entrada para él en el índice y en la instantánea del commit; .gitignore solo se consulta cuando Git está decidiendo qué hacer con un archivo que todavía no tiene entrada en el índice.

Una vez que existe una entrada, los patrones de ignorados le son irrelevantes. git rm --cached elimina la entrada del índice mientras mantiene el archivo en el disco, y por eso es el comando que realmente arregla esto, mientras que editar el patrón de ignorados por sí solo no hace nada.

JunoAgregar un archivo a .gitignore después de que ya está rastreado Agregar un archivo a .gitignore después de que Git ya lo rastrea no le hace nada a ese archivo. Las reglas de ignorados solo aplican a archivos que Git nunca ha agregado. Para dejar de rastrear un archivo que se coló por accidente, corre git rm --cached <archivo> y comitea ese cambio.
JunoAgregar un archivo a .gitignore después de que ya está rastreado.gitignore solo afecta a archivos no rastreados. Para algo que ya está comiteado, elimínalo con git rm --cached <archivo>, o git rm -r --cached <carpeta> para una carpeta completa, y luego comitea. Los archivos locales de todos se quedan igual, solo cambia cómo Git los rastrea.
JunoAgregar un archivo a .gitignore después de que ya está rastreado El índice guarda una entrada por cada archivo rastreado, y .gitignore solo se consulta cuando todavía no hay una entrada. git rm --cached borra la entrada del índice sin tocar el archivo en el disco, que es el verdadero arreglo aquí. Agrega también el patrón de ignorados para asegurarte de que el archivo no se vuelva a colar.

Buenos hábitos: commits pequeños y un repositorio limpio ​

Un .gitignore bien cuidado es la mitad de mantener un repositorio agradable para trabajar. La otra mitad es cómo organizas tus commits. Haz que cada commit sea un cambio enfocado: una corrección de bug, una pequeña funcionalidad, un solo refactor. Si una tarde de trabajo toca varias cosas sin relación entre sí, divídela en varios commits en vez de meterlo todo en uno solo al final del día.

bash
$ git add src/weather-widget.js
$ git commit -m "Fix temperature rounding in weather widget"

Los commits pequeños son más fáciles de revisar, más fáciles de revertir si algo se rompe, y más fáciles de entender seis meses después cuando estás tratando de recordar por qué existe una línea de código. El ciclo del commit explica qué hace útil a un mensaje de commit; este hábito se trata de mantener el cambio en sí lo bastante pequeño como para que sea posible escribir un buen mensaje.

Combina ese hábito con un .gitignore limpio y el beneficio se multiplica: un historial hecho de commits pequeños y con propósito, sin carpetas generadas ni archivos de configuración sueltos ensuciando el diff. Revisar un cambio lleno de ruido de dist/ junto a las dos líneas reales que alguien editó es un fastidio para todos los involucrados, y es totalmente evitable con un .gitignore configurado desde el primer día.

A gran escala, esto rinde beneficios más allá de la legibilidad. Un repositorio libre de archivos generados y carpetas de dependencias se mantiene lo bastante pequeño como para clonarse rápido y buscarse con claridad, y un historial de commits enfocados es lo que hace que git log --oneline y git diff entre dos puntos en el tiempo sean realmente útiles para entender qué pasó y por qué. Nada de eso funciona bien contra un historial donde la mitad de los commits son ruido de node_modules/ y la otra mitad mezcla cinco cambios sin relación entre sí.

JunoBuenos hábitos: commits pequeños y un repositorio limpio Mantén cada commit enfocado en un solo cambio, y mantén tu .gitignore cubriendo las carpetas y secretos que nunca deben rastrearse. Esos dos hábitos juntos son la mayor parte de lo que hace agradable trabajar en un repositorio. Los hábitos pequeños, formados desde el principio, te ahorran mucha limpieza después.
JunoBuenos hábitos: commits pequeños y un repositorio limpio Commits pequeños y enfocados más un .gitignore limpio hacen que las revisiones y los diffs sean realmente legibles en vez de estar enterrados en ruido generado. Configura el .gitignore antes de tu primer commit. Esperar hasta que node_modules/ aparezca en un pull request por quinta vez cuesta más limpieza de la que ahorra.
JunoBuenos hábitos: commits pequeños y un repositorio limpio Un repositorio ligero y un historial de commits enfocados son lo que mantiene los clones rápidos y el historial legible cuando lo revisas. Cada archivo generado o carpeta de dependencias que se cuela en el historial es un pequeño costo que paga cada clon y cada búsqueda futura. Configura las reglas de ignorados desde el principio y deja de ser un problema en el que valga la pena volver a pensar.