Skip to content
This page has been auto-translated and may contain errors.View in English

提交循环 ​

docs.scrimba.com

假设你在 weather-app 项目上已经忙活了二十分钟。你修复了 src/index.js 里的一个真实 bug(温度换算算错了),顺手又开始重新调整 styles.css 的样式,但这部分改动还没写完,也还不想让别人看到。你现在想把这个 bug 修复保存成一个独立的检查点,而不想把没写完的样式改动也一起带上。

这正是提交循环要解决的问题。如果你还没有建好仓库,可以先看 你的第一个仓库,那里讲了 git init 和克隆仓库的方法。从这里开始,本章假设你已经有一个打开的仓库了。

三个环节:工作目录、暂存区、提交 ​

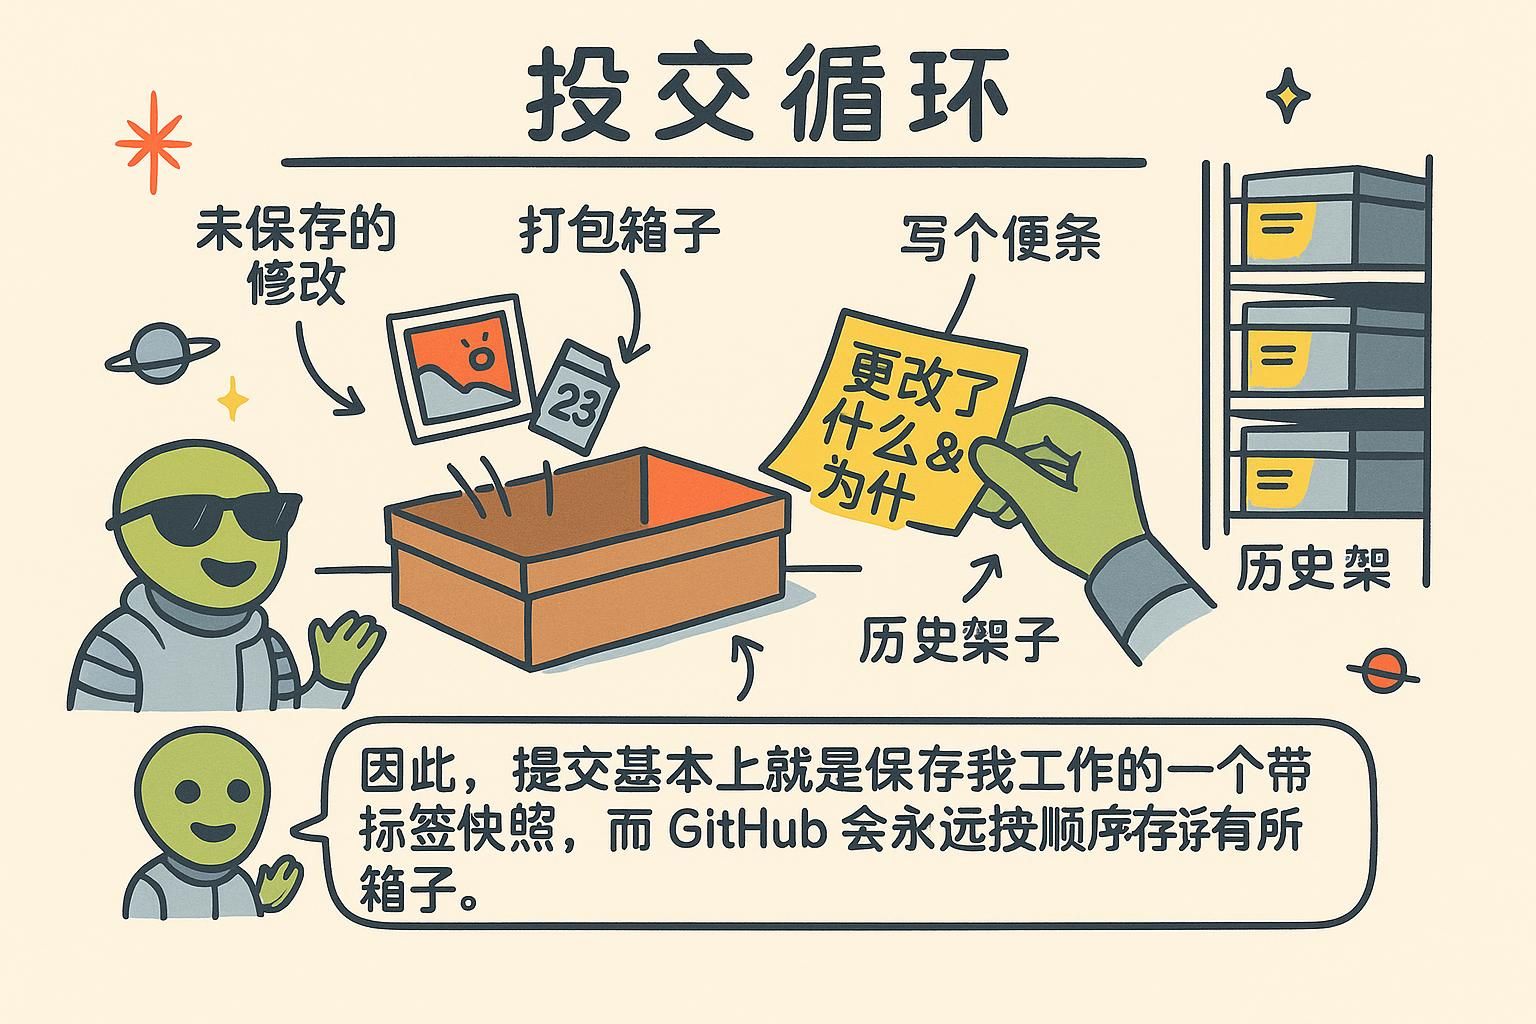
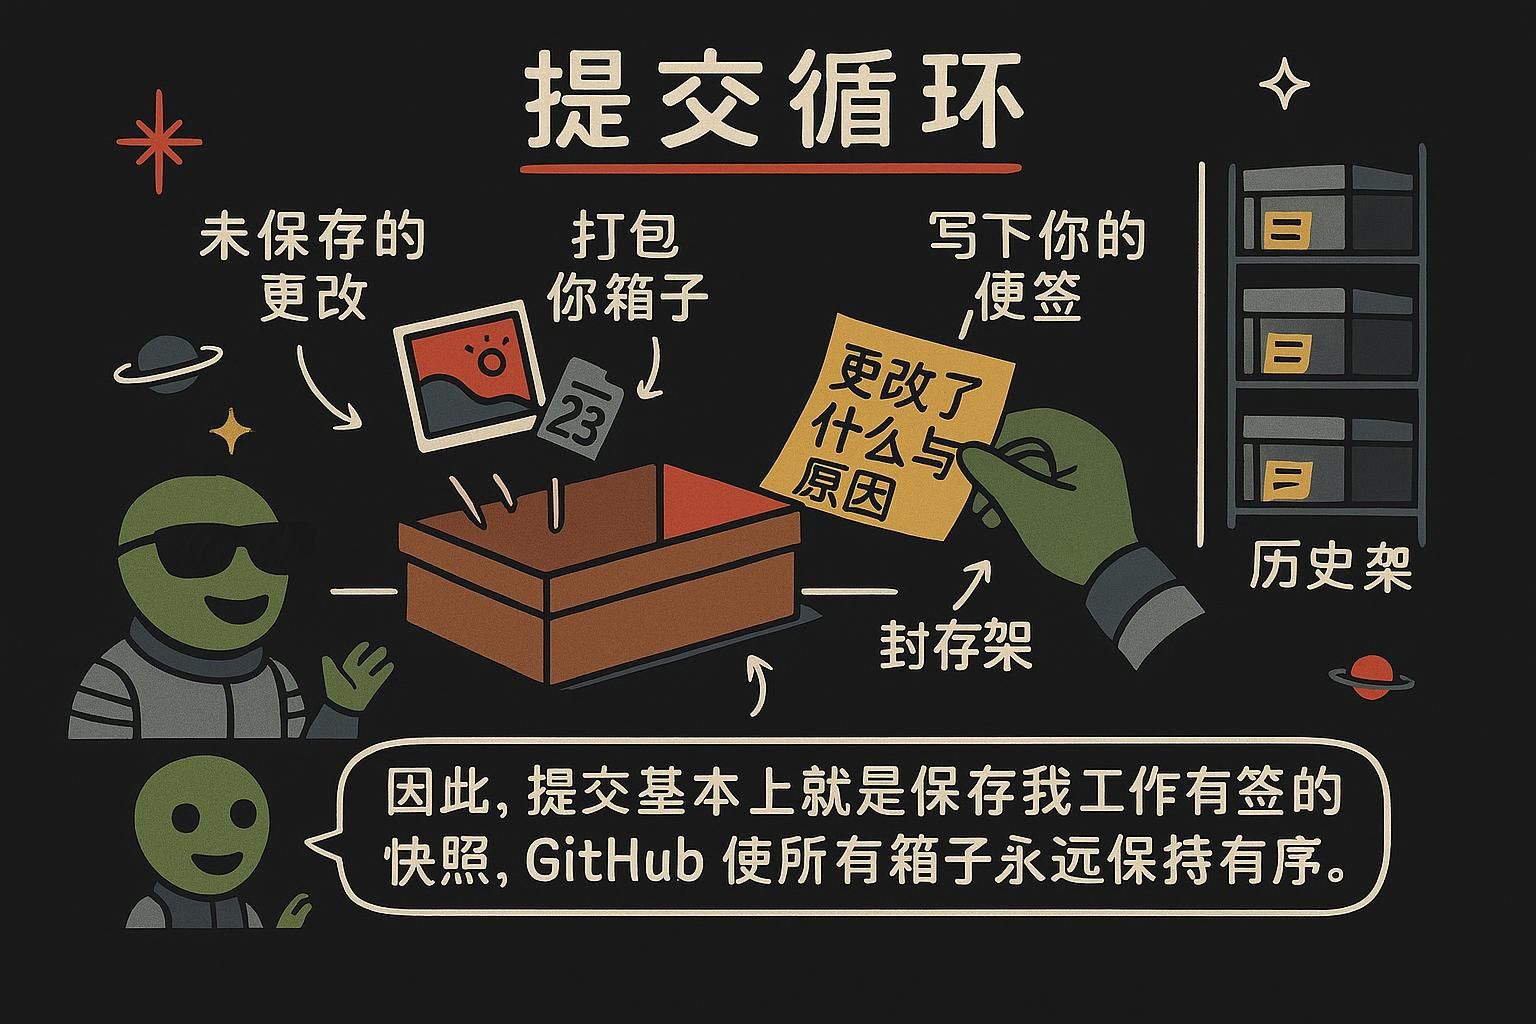
在 Git 里,你做的每一处修改都要经过三个环节才能变成永久的历史记录。工作目录就是项目现在在磁盘上的样子,也就是你正在编辑的那些文件。**暂存区**是一个中转地带,你把接下来想要保存的那些改动放在这里。提交则是保存下来的快照本身——一旦你写下它,连同描述它的提交信息一起,就成了提交。

想象一下搬家打包的场景。你的整个房子就是工作目录:你拥有的一切东西,不管现在是什么状态。你已经打包好、贴上封条放在门口的箱子就是暂存区:只包含你特意选中要带走的东西。载着这些箱子开走的搬家卡车就是提交:记录了那一刻究竟带走了什么,外面还贴着标签写明里面是什么。

来看看这套心理模型在真实终端里的样子。编辑完 weather-app 里的两个文件后,git status 只是读取当前状态,不会改动任何东西:

bash
$ git status
On branch main
Changes not staged for commit:
  (use "git add <file>..." to update what will be committed)
  (use "git restore <file>..." to discard changes in working directory)
        modified:   src/index.js
        modified:   styles.css

no changes added to commit (use "git add" to commit)

两个文件都显示为"未暂存",因为仅仅编辑文件只会改变你的工作目录。在你用 git add(下一节会讲)告诉 Git 之前,不会有任何东西进入暂存区。

正是在这里,暂存区存在的意义才真正体现出来。暂存区让你可以精确选择哪些内容进入提交,不受工作目录里还有哪些其他改动的影响。如果没有暂存区,保存一个检查点就得把磁盘上的所有改动一次性都带上,不管是否准备好。

有了暂存区,你就可以把 src/index.js 里已经完成的 bug 修复暂存起来,把还没写完的 styles.css 留在外面,只提交真正完成的那一部分。暂存区和工作目录可以同时保存不同的内容——这一点几乎每个人在第一周都会被绊一下。一旦你想通了这一点,Git 日常工作流的其他部分就都顺理成章了。
在日常工作中,把 git status 当成每次 add 和每次 commit 之前的常规步骤,不管感觉有没有问题都执行一下。这不费什么力气,也永远不会改动你的项目,还能防止误提交超出预期范围的常见错误。养成这样的习惯:先检查状态,再暂存,暂存完再检查一次状态,最后才提交——只需要几秒钟,却能保证你的提交信息始终和实际提交的内容对得上。

暂存区实际上是一个真实存在的文件,叫做**索引(index)**,位于仓库内部的 .git/index。每次运行 git add,Git 都会更新这个文件,记录哪个文件的哪个版本被暂存了。运行 git commit 时,Git 完全根据索引里记录的内容来构建新提交,不会再去检查一遍工作目录。这就是你刚才在 git status 里看到的那种分裂状态背后的全部机制:磁盘上有两个文件被编辑过,但索引目前还没记录其中任何一个,所以此刻如果提交,提交内容会是空的。

JunoGit 的三个区域 你的工作目录就是文件现在的样子。暂存区是你放置接下来想要保存的那些改动的地方,提交则是你写下它之后保存下来的快照。编辑文件本身并不会自动把它暂存,你要用 git add 来选择哪些内容进入暂存区,这正是你能保存一个已完成的改动、同时留下一个未完成改动的原因。
JunoGit 的三个区域 工作目录、暂存区、提交:改动先出现在第一个地方,git add 把你选中的内容精确地移到第二个地方,git commit 再把第二个地方的内容保存成永久快照。暂存前跑一次 git status,提交前再跑一次,这不花什么代价,还能保证你的提交内容和你想保存的东西一致。
JunoGit 的三个区域 暂存区是一个真实存在的文件,也就是 .git/index 里的索引,git commit 是根据索引来构建快照的,而不是直接读取工作目录。这就是为什么两个都被编辑过的文件都会显示为未暂存:索引还没被告知这两处改动。用这种方式理解索引之后,每一条暂存相关的命令都不再显得神秘,更像是在读写一个文件。

暂存改动:git add ​

git add 把一处改动从工作目录移入暂存区。指定你想放进下一次提交的那个文件:

bash
$ git add src/index.js
$ git status
On branch main
Changes to be committed:
  (use "git restore --staged <file>..." to unstage)
        modified:   src/index.js

Changes not staged for commit:
  (use "git add <file>..." to update what will be committed)
  (use "git restore <file>..." to discard changes in working directory)
        modified:   styles.css

src/index.js 已经移到了"Changes to be committed"(待提交的改动)下面,bug 修复已经暂存好,随时可以提交。styles.css 还列在"未暂存"下面,正好符合你的心意——毕竟样式还没改完。再运行一次 git add styles.css 也会把它暂存进去;而运行 git add . 会把当前文件夹里所有改动过的文件一次性全部暂存,等你确认磁盘上的一切都真的准备好了,这样用起来会很方便。

有时候一个文件里既有你想保存的改动,也有你不想保存的改动,而把它们拆成两个文件又不现实。git add -p <file>(-p 是 --patch 的缩写)会把文件的改动拆成一个个小块(叫做 hunk),逐块让你决定:

bash
$ git add -p src/index.js
@@ -12,7 +12,7 @@ function celsiusToFahrenheit(celsius) {
-  return celsius * (9 / 5 + 32)
+  return (celsius * 9) / 5 + 32
Stage this hunk [y,n,q,a,d,e,?]?

输入 y 暂存这一块,n 留到以后处理,q 停止操作。这样即使在同一个文件内部,你也能获得提交级别的精细控制,只要出现"这个文件改了一半"的情况,就值得用一下这个命令。

git add 实际上同时做了两件事,搞清楚这两件事能帮你理解一个迟早会遇到的坑。首先,它把文件当前的内容写进一个新的**blob**——这是 Git 永久存储的一种对象,用哈希标识(和提交的标识方式一样),保存着某个文件在某一时刻的确切内容。其次,它更新索引,让索引指向这个文件对应的这个 blob。add 之后就不会再去查看这个文件了。

这就是为什么,如果你先 git add src/index.js,然后在提交之前继续编辑同一个文件,git status 会同时把它显示为已暂存和已修改:索引仍然指向你运行 add 那一刻的 blob,而你的工作目录已经往前走了。git commit 只看得到已暂存的那个 blob,所以要把更新的改动也带进去,就得再运行一次 git add。

Juno暂存改动git add <file> 把该文件当前的改动移入暂存区,为下一次提交做好准备。还没 add 的文件会留在外面,所以你可以完成一件事,同时留另一件事半途暂放。git add . 会一次性暂存所有改动过的文件,等一切真的准备好了用起来很方便。
Juno暂存改动git add <file> 会暂存整个文件,而当文件只有一部分改动准备好时,git add -p <file> 能让你按块(hunk)暂存。一旦出现"这个文件改了一半"的情况,第二种就是你该用的工具。
Juno暂存改动git add 把文件当前的内容写进一个 blob,并让索引指向它,之后就不会再盯着这个文件了。如果你在提交前又编辑了一次文件,status 会把它显示为既已暂存又已修改,因为索引里还留着旧的那个 blob。重新运行一次 add 就能把新的改动带进去。我第一次踩到这个坑的时候,困惑了整整十分钟。

保存一份快照:git commit ​

一旦暂存区里放好了你想要的内容,git commit 就能把它保存成一份永久快照,-m 参数("message" 的缩写)用来提供随之保存的描述文字:

bash
$ git commit -m "Fix temperature conversion in Celsius-to-Fahrenheit formula"
[main 4f2a1c9] Fix temperature conversion in Celsius-to-Fahrenheit formula
 1 file changed, 1 insertion(+), 1 deletion(-)

只有 src/index.js 被提交进去了,因为你只暂存了这一个文件。styles.css 依然停留在工作目录里,处于已编辑但未提交的状态,等着你把样式改完再说。那个短 id,4f2a1c9,就是这次提交的标识,历史记录 一章会讲怎么查看项目完整的提交列表。

写提交信息时用祈使句,像是在下一条指令。"Fix temperature conversion"(修复温度换算)和 Git 自身使用的措辞("this commit will...",即"这次提交将会……")保持一致,在那些逐行列出提交的工具里读起来也很清爽。如果改动比一行修复要复杂得多,就再加一段正文说明为什么需要这个改动。diff 本身已经能看出改了什么,所以正文留给背后的原因就好:

bash
$ git commit -m "Fix temperature conversion in Celsius-to-Fahrenheit formula

The formula was applying operator precedence in the wrong order,
which rounded warm temperatures down by a degree in the UI."

如果提交完之后马上发现打错字或者漏了什么细节,git commit --amend 可以用一个新提交替换掉你最近的那次提交,而不是在上面再叠一次:

bash
$ git commit --amend -m "Fix temperature conversion in Celsius-to-Fahrenheit formula"

只有还没分享给任何人的提交才能用 amend 修改。一旦你已经推送过它(也就是发到了项目的共享副本上),amend 就会改写别人可能已经拿到的历史记录,撤销操作 会讲到那之后修正提交的安全方法。

提交本身是一个小对象,由三部分组成:一个指向**树(tree)**的指针、作者信息和提交信息,以及一个指向父提交的指针。树是那一刻你整个项目目录结构的快照:对于每一个文件和文件夹,它都记录一个名字,以及一个指向 blob(文件内容)或另一棵树(子文件夹)的指针。git add 会逐个文件写入 blob 并更新索引;而 git commit 正是 Git 把当前索引整理成一棵完整的树、再把它包进一个提交对象的那一刻。

两个内容完全相同的文件,即使放在不同的文件夹里,也会指向同一个 blob,所以一次提交永远不会把同样的字节重复存两份。这种结构也让比较两次提交变得很高效:Git 会并排遍历两棵树,只打开那些指针确实不同的 blob,跳过所有没变化的文件。

Juno保存一次提交git commit -m "message" 会把当前暂存区里的内容保存成一份永久快照,并附上你给的提交信息。没有暂存的内容会留在外面,仍然可以继续编辑。提交信息要简短清楚地说明这次提交做了什么,未来的你回头看的次数会比你想象的多得多。
Juno保存一次提交 提交信息要写成一条指令的语气,用"Fix"而不是"Fixed",如果单看 diff 会让人猜不透你为什么这么改,就补一段正文说明。git commit --amend 会替换掉你上一次提交,而不是再叠一个新的,用来修正提交信息里的错字非常合适,前提是你还没把那次提交推送到任何地方。
Juno保存一次提交 提交指向一棵树,树把名字映射到 blob 和更深一层的树,构成整个项目在提交那一刻、基于索引内容构建出的完整嵌套快照。add 负责写入 blob,commit 负责把索引变成一棵完整的树,项目里任何地方内容相同的文件都会共享同一个 blob,而不会被重复存储。想清楚这个结构之后,两件事就不再显得神秘:为什么不会有重复存储,以及为什么比较两次提交靠的是并排遍历两棵树,而不是把每个文件都重新读一遍。